المسار: مقاييس Dynatrace SaaS · الوحدة 5/7 — مقاييس Kubernetes في Grail والعمليات وبيئات التشغيل والحاويات · الشكل: بطاقات مرجعية · المنصة: Dynatrace SaaS (Grail وDQL)
في هذه الوحدة:
- جدول موجز لـ21 مقياسًا من
dt.process.*وdt.runtime.*وdt.containers.*وdt.kubernetes.*. - بطاقة لكل مقياس: ما يقيسه، ومتى تستخدمه، والفخ الذي يجب تجنبه، واستعلام
timeseries. - طريقة للتحقق من وجود مفتاح فعلًا في بيئتك قبل بناء لوحة معلومات.
تجمع هذه الوحدة الخامسة من مسار مقاييس Dynatrace SaaS مقاييس Kubernetes في Grail ومقاييس الطبقات التي تعمل تحتها: العمليات وآلات Java الافتراضية والحاويات. هذه هي المقاييس التي تُفتح عندما يُعاد تشغيل pod، أو تبطؤ خدمة دون سبب ظاهر في الطلبات، أو تتشبع عقدة. تعطي كل بطاقة المفتاح بدقة ووحدته وأبعاده الرئيسية واستعلام DQL جاهزًا للتكييف.
كل ما في هذه الوحدة يخص Dynatrace SaaS مع Grail وDQL. وفي Dynatrace Managed توجد الإشارات نفسها على شكل مفاتيح كلاسيكية builtin:tech.* وbuiltin:containers.* وbuiltin:kubernetes.*، تُستعلم بمحدد المقاييس (metric selector): وتُعالَج في وحدة مقاييس العمليات builtin من مسار Managed.
تذهب البطاقات مباشرة إلى المفتاح. ولدمج هذه المقاييس في نسب (الطلبات مقابل الاستهلاك، والتشبع، والحصص) وفي تنبيهات، تعطي الوحدة 7 عن DQL timeseries المعاملات المفيدة.
مقاييس Kubernetes في Grail وجاراتها في جدول واحد
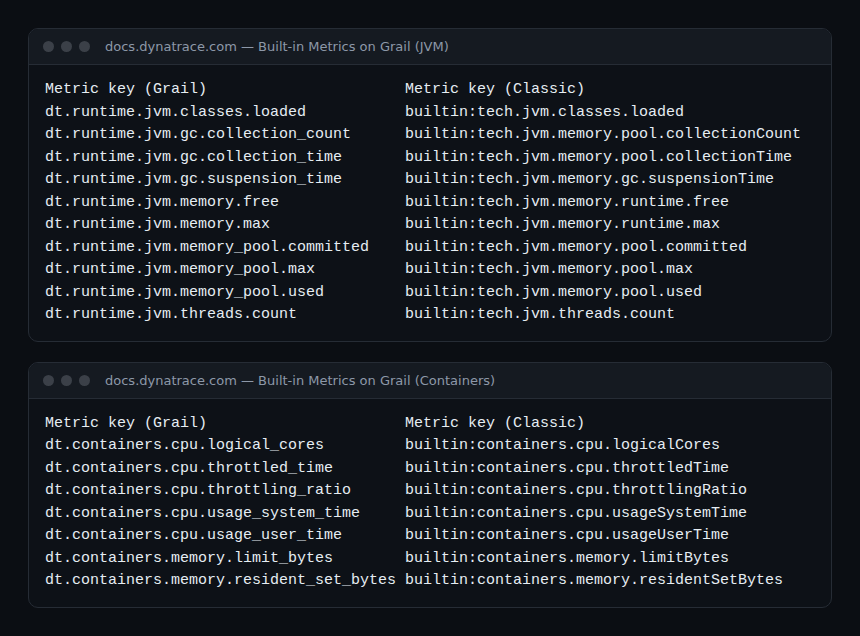
كل المفاتيح أدناه واردة في صفحة Built-in Metrics on Grail. الوحدات هي وحدات المقابل الكلاسيكي الموثّق في مرجع المقاييس المدمجة. الأبعاد المذكورة هي الأكثر استخدامًا للتجميع؛ افتح متصفح المقاييس لرؤية القائمة الكاملة.
| مفتاح Grail | الوحدة | الأبعاد الرئيسية | ما يقيسه |
|---|---|---|---|
dt.process.cpu.usage |
% | dt.entity.process_group_instance |
المعالج الذي تستهلكه عملية |
dt.process.memory.working_set_size |
بايت | dt.entity.process_group_instance |
ذاكرة العمل للعملية |
dt.process.handles.file_descriptors_percent_used |
% | dt.entity.process_group_instance |
حصة واصفات الملفات المستخدمة |
dt.process.network.sessions.reset |
في الثانية | dt.entity.process_group_instance |
جلسات TCP الواردة المنتهية بإعادة تعيين (reset) |
dt.runtime.jvm.memory_pool.used |
بايت | dt.entity.process_group_instance |
الذاكرة المستخدمة لكل مجمّع (pool) في JVM |
dt.runtime.jvm.gc.suspension_time |
% | dt.entity.process_group_instance |
زمن التوقف بسبب جامع النفايات |
dt.runtime.jvm.gc.collection_count |
عدد | dt.entity.process_group_instance |
عمليات جمع النفايات |
dt.runtime.jvm.threads.count |
عدد | dt.entity.process_group_instance |
خيوط (threads) JVM |
dt.containers.cpu.throttled_time |
ns/دقيقة | dt.entity.container_group_instance |
زمن تقييد المعالج لحاوية |
dt.containers.memory.resident_set_bytes |
بايت | dt.entity.container_group_instance |
الذاكرة المقيمة للحاوية |
dt.containers.memory.limit_bytes |
بايت | dt.entity.container_group_instance |
حد ذاكرة الحاوية |
dt.kubernetes.container.cpu_usage |
millicores | k8s.cluster.name، k8s.namespace.name، k8s.workload.name |
المعالج الذي تستهلكه الحاويات |
dt.kubernetes.container.requests_cpu |
millicores | k8s.cluster.name، k8s.namespace.name، k8s.workload.name |
المعالج المطلوب (requests) |
dt.kubernetes.container.memory_working_set |
بايت | k8s.cluster.name، k8s.namespace.name، k8s.workload.name |
ذاكرة العمل للحاويات |
dt.kubernetes.container.limits_memory |
بايت | k8s.cluster.name، k8s.namespace.name، k8s.workload.name |
حد الذاكرة المعلن |
dt.kubernetes.container.restarts |
عدد | k8s.cluster.name، k8s.namespace.name، k8s.workload.name |
إعادات تشغيل الحاويات |
dt.kubernetes.container.oom_kills |
عدد | k8s.cluster.name، k8s.namespace.name، k8s.workload.name |
الإيقافات بسبب نفاد الذاكرة (OOMKilled) |
dt.kubernetes.workload.pods_desired |
عدد | k8s.cluster.name، k8s.namespace.name، k8s.workload.name |
الـpods المطلوبة من workload |
dt.kubernetes.pods |
عدد | k8s.cluster.name، k8s.namespace.name، k8s.workload.name |
الـpods الموجودة |
dt.kubernetes.node.cpu_allocatable |
millicores | k8s.cluster.name |
المعالج القابل للتخصيص في العقد |
dt.kubernetes.persistentvolumeclaim.used |
بايت | k8s.cluster.name، k8s.namespace.name |
المساحة المستخدمة في وحدة تخزين دائمة |
العمليات: dt.process.*
يجمع OneAgent مقاييس العمليات لكل نسخة من مجموعة عمليات. وهي تجيب عن سؤال «أي عملية تستهلك ماذا على هذا المضيف؟».
dt.process.cpu.usage
النسبة المئوية من معالج المضيف التي تستهلكها العملية، بجمع كل عمّالها (workers). تعني 100% أن العملية تشغل كل موارد المعالج المتاحة للمضيف. مفيد لعزل العملية المسؤولة عند ارتفاع dt.host.cpu.usage. الفخ: على مضيف من 16 نواة، تمثل 10% أكثر من نواة ونصف؛ قارن دائمًا بعدد الأنوية قبل أن تستنتج.
timeseries cpu = avg(dt.process.cpu.usage), by: {dt.entity.process_group_instance}
| sort arrayAvg(cpu) desc
| limit 10
dt.process.memory.working_set_size
ذاكرة العمل للعملية، بالبايت. منحنى يصعد كدرج دون أن ينزل بعد ذروات الحِمل هو العلامة الكلاسيكية لتسرب الذاكرة. ولتطبيق Java قاطعه مع مجمّعات JVM: فذاكرة العملية تشمل أيضًا الشيفرة الأصلية والخيوط والمخازن المؤقتة خارج الكومة (heap).
timeseries ws = max(dt.process.memory.working_set_size), by: {dt.entity.process_group_instance}dt.process.handles.file_descriptors_percent_used
حصة واصفات الملفات المفتوحة مقارنة بالحد الأقصى المسموح للعملية. الخادم الذي يقترب من 100% ينتهي برفض الاتصالات بأخطاء «too many open files»، غالبًا بعيدًا عن السبب الحقيقي. ويجنّب تنبيه مبكر على هذا المقياس حادثة يصعب تشخيصها. وتبقى العتبة من اختيارك بحسب تطبيقك.
timeseries fd = max(dt.process.handles.file_descriptors_percent_used), by: {dt.entity.process_group_instance}
| filter arrayMax(fd) > 80
dt.process.network.sessions.reset
عدد جلسات TCP الواردة المنتهية بخطأ إعادة تعيين، في الثانية. يرافق الارتفاع المفاجئ غالبًا مجمّع اتصالات محدد الحجم خطأً، أو جدارًا ناريًا يقطع الجلسات الخاملة، أو خدمة بعيدة تُعاد تشغيلها. انظر إلى هذا المقياس عندما يرتفع معدل الأخطاء في خدمة دون استثناء ظاهر في التتبعات.
timeseries resets = avg(dt.process.network.sessions.reset), by: {dt.entity.process_group_instance}بيئات التشغيل: dt.runtime.jvm.*
تحل مقاييس بيئة التشغيل على Grail محل المفاتيح الكلاسيكية builtin:tech.jvm.*. ولبيئات تشغيل أخرى (Go وNode.js و.NET وPHP) عائلات dt.runtime.* خاصة بها؛ وتركّز هذه الوحدة على JVM، الأكثر انتشارًا في الإنتاج.
dt.runtime.jvm.memory_pool.used
الذاكرة المستخدمة في كل مجمّع من JVM (eden وsurvivor وold gen وmetaspace بحسب جامع النفايات). قارنها بـdt.runtime.jvm.memory_pool.max: مجمّع old gen الذي يبقى مرتفعًا بعد كل عملية جمع ينذر بـOutOfMemoryError. الفخ: جمع كل المجمّعات بلا معنى للأعمال، فانظر إليها منفصلة.
timeseries used = avg(dt.runtime.jvm.memory_pool.used), by: {dt.entity.process_group_instance}dt.runtime.jvm.gc.suspension_time
الزمن الذي تُعلَّق فيه JVM بسبب جامع النفايات، بالنسبة المئوية. أثناء هذه التوقفات لا يتقدم أي طلب: وهي سبب متكرر لارتفاع زمن الاستجابة عند النسبة المئوية 99 تُظهره التتبعات دون أن تفسره. القيمة المرتفعة باستمرار تستدعي ضبط الكومة أو جامع النفايات، لا إضافة pods.
timeseries gc = avg(dt.runtime.jvm.gc.suspension_time), by: {dt.entity.process_group_instance}dt.runtime.jvm.gc.collection_count
عدد عمليات الجمع التي نفّذها جامع النفايات. وحدها تقول القليل؛ وبنسبتها إلى الحِمل تكشف تطبيقًا ينشئ كائنات مؤقتة كثيرة. الارتفاع المفاجئ بعد نشر يشير غالبًا إلى تراجع في الشيفرة.
timeseries gcs = sum(dt.runtime.jvm.gc.collection_count), by: {dt.entity.process_group_instance}dt.runtime.jvm.threads.count
عدد خيوط JVM. النمو المستمر يفضح خيوطًا لا تنتهي (مجمّع غير محدود أو استدعاءات محجوبة). ومع ارتفاع زمن الاستجابة يشير إلى نفاد المجمّع.
timeseries threads = max(dt.runtime.jvm.threads.count), by: {dt.entity.process_group_instance}الحاويات كما يراها OneAgent: dt.containers.*
تأتي هذه المقاييس من OneAgent على المضيف وتصف كل نسخة من مجموعة حاويات. وتوضح الوثائق أن مقاييس الحاويات الكلاسيكية القديمة أُهملت لصالح هذه المفاتيح.
dt.containers.cpu.throttled_time
الزمن الذي قُيّدت فيه الحاوية بحد المعالج، بالنانوثانية في الدقيقة. الحاوية المقيَّدة تبطؤ بينما لا يزال في المضيف معالج حر: وهذا هو الفخ الكلاسيكي لحدود المعالج المنخفضة جدًا. وتبيّن صفحة ترحيل Kubernetes في الوثائق كيف تُحوَّل هذه القيمة إلى millicores.
timeseries throttled = avg(dt.containers.cpu.throttled_time), by: {dt.entity.container_group_instance}dt.containers.memory.resident_set_bytes
الذاكرة المقيمة للحاوية، بالبايت. هي القياس الذي يُقارَن بالحد لتقدير خطر الإيقاف بسبب نفاد الذاكرة. الفخ: ذاكرة التخزين المؤقت للصفحات غير محسوبة هنا؛ ولها مفتاحها الخاص dt.containers.memory.cache_bytes.
timeseries rss = avg(dt.containers.memory.resident_set_bytes), by: {dt.entity.container_group_instance}dt.containers.memory.limit_bytes
حد ذاكرة الحاوية، بالبايت. وبدون حد تكون القيمة فارغة. تحسب الوثائق نسبة الاستخدام بقسمة الذاكرة المقيمة على هذا الحد، أو على الذاكرة الفيزيائية الإجمالية عند غياب الحد.
timeseries {
    rss = avg(dt.containers.memory.resident_set_bytes),
    lim = avg(dt.containers.memory.limit_bytes)
  }, by: {dt.entity.container_group_instance}
| fieldsAdd pct = 100 * rss[] / lim[]
Kubernetes: dt.kubernetes.*
تصل هذه المقاييس مع تجربة Kubernetes الجديدة، عبر ActiveGate بالإصدار 1.279 أو أحدث. مقاييس Kubernetes القديمة غير متاحة على Grail: فانطلق مباشرة من هذه المفاتيح.
dt.kubernetes.container.cpu_usage
المعالج الذي تستهلكه الحاويات (المستخدم والنظام)، بالـmillicores. قيمته الأكثر فائدة نسبية: بمقارنته بالـrequests يُظهر الـworkloads ذات الحجم الناقص أو الزائد. أدق مستوى هو الحاوية؛ جمّع حسب workload لقراءة تطبيق.
timeseries cpu = sum(dt.kubernetes.container.cpu_usage),
  by: {k8s.cluster.name, k8s.namespace.name, k8s.workload.name}
dt.kubernetes.container.requests_cpu
المعالج المطلوب من الحاويات (requests)، بالـmillicores. يضع المجدوِل (scheduler) الـpods وفق هذه القيمة لا وفق الاستهلاك الفعلي. والفرق المستمر بين requests والاستخدام يهدر السعة أو، على العكس، يهيئ تنافسًا على العقدة.
timeseries {
    usage = sum(dt.kubernetes.container.cpu_usage),
    req = sum(dt.kubernetes.container.requests_cpu)
  }, by: {k8s.namespace.name, k8s.workload.name}
| fieldsAdd ratio = 100 * usage[] / req[]
dt.kubernetes.container.memory_working_set
ذاكرة العمل للحاويات، بالبايت. هذه هي القيمة التي يراقبها kubelet ليقرر الإخلاء (eviction) وتقارنها النواة بالحد. وتجمّعها الوثائق على مستوى workload بالجمع حسب cluster وnamespace وworkload.
timeseries memory_working_set = sum(dt.kubernetes.container.memory_working_set),
  by: {k8s.cluster.name, k8s.namespace.name, k8s.workload.name}
dt.kubernetes.container.limits_memory
حد الذاكرة المعلن للحاويات، بالبايت. وبنسبته إلى memory_working_set يعطي الهامش المتبقي قبل OOMKill. الفخ: الحاوية بلا حد لا تظهر في هذه السلسلة، مما يشوّه نسبة محسوبة على namespace كامل.
timeseries {
    ws = sum(dt.kubernetes.container.memory_working_set),
    lim = sum(dt.kubernetes.container.limits_memory)
  }, by: {k8s.namespace.name, k8s.workload.name}
| fieldsAdd marge = 100 * ws[] / lim[]
dt.kubernetes.container.restarts
إعادات تشغيل الحاويات، بحسب restartCount في حالة pod. توضح وثائق المقاييس الكلاسيكية أن القيمة لا تُكتب إلا إذا حدثت إعادة تشغيل واحدة على الأقل: سلسلة فارغة تعني «لا إعادات تشغيل» لا عطلًا في الجمع. وهو المؤشر الأول على CrashLoopBackOff.
timeseries restarts = sum(dt.kubernetes.container.restarts),
  by: {k8s.namespace.name, k8s.workload.name}
| filter arraySum(restarts) > 0
dt.kubernetes.container.oom_kills
عدد إيقافات الحاويات بالحالة OOMKilled. كما في إعادات التشغيل، لا توجد السلسلة إلا إذا وقع حدث واحد على الأقل. وOOMKill المتكرر على workload يُعالَج بحد الذاكرة أو بالشيفرة، نادرًا بإضافة نسخ (replicas). والتشخيص الكامل مفصّل في CrashLoopBackOff وOOMKilled: تشخيص الـpods.
timeseries oom = sum(dt.kubernetes.container.oom_kills),
  by: {k8s.namespace.name, k8s.workload.name}
dt.kubernetes.workload.pods_desired
عدد الـpods المطلوبة من workload (النسخ المعلنة). وبمقارنته بـdt.kubernetes.pods يكشف نشرًا عالقًا: صورة غير موجودة، أو حصة مستنفدة، أو عقد ممتلئة.
timeseries {
    desired = max(dt.kubernetes.workload.pods_desired),
    actual = max(dt.kubernetes.pods)
  }, by: {k8s.namespace.name, k8s.workload.name}
dt.kubernetes.pods
عدد الـpods، قابل للتجميع حسب workload. مفيد لتتبع التوسع الأفقي التلقائي أو لرصد اختفاء pods بعد حادثة عقدة. الفخ: يشمل هذا العدد كل الـpods أيًّا كانت حالتها؛ لا تقرأه كعدد pods الجاهزة.
timeseries pods = max(dt.kubernetes.pods), by: {k8s.namespace.name, k8s.workload.name}dt.kubernetes.node.cpu_allocatable
المعالج القابل للتخصيص في العقد، بالـmillicores: السعة المتاحة فعلًا للـpods بعد حجوزات النظام. وبمقارنته بمجموع requests يبيّن كم pod يمكن للعنقود أن يستقبل بعد. والمنطق نفسه ينطبق على memory_allocatable وpods_allocatable.
timeseries alloc = sum(dt.kubernetes.node.cpu_allocatable), by: {k8s.cluster.name}dt.kubernetes.persistentvolumeclaim.used
البايتات المستخدمة في وحدة تخزين دائمة، مقيسة على مستوى PersistentVolumeClaim. وبنسبتها إلى dt.kubernetes.persistentvolumeclaim.capacity تستبق امتلاء قرص في قاعدة بيانات أو طابور رسائل، وهي حادثة يطول حلها بعد وقوعها.
timeseries {
    used = avg(dt.kubernetes.persistentvolumeclaim.used),
    cap = avg(dt.kubernetes.persistentvolumeclaim.capacity)
  }, by: {k8s.namespace.name}
| fieldsAdd pct = 100 * used[] / cap[]
كيف تتحقق من أن كل شيء يعمل
- افتح Notebook ونفّذ
timeseries sum(dt.kubernetes.pods), by: {k8s.cluster.name}: يجب أن يعيد كل عنقود مراقَب سلسلة. وغياب أي نتيجة يعني غالبًا أن تجربة Kubernetes الجديدة غير مفعّلة. - بالنسبة إلى مقاييس العمليات وJVM، رشّح على مضيف معروف وتحقق من أن
dt.process.cpu.usageيعيد عملياته الرئيسية. - قبل بناء تنبيه، اعرض المفتاح في متصفح المقاييس: فهو يعطي القائمة الدقيقة للأبعاد المتاحة في بيئتك.
- بالنسبة إلى السلاسل «المكتوبة فقط عند وقوع حدث» (إعادات التشغيل وOOMKills)، جرّب الاستعلام على فترة وقعت فيها حادثة.
تتبع استعلامات هذه الوحدة الصيغة المفصلة في DQL timeseries: الدليل المتقدم. ولتحويل هذه الإشارات إلى تنبيهات راجع تنبيهات Kubernetes على العقد والـpods والحصص.
الأسئلة الشائعة
لماذا لا يعيد استعلامي على مفتاح Kubernetes قديم شيئًا؟
مقاييس Kubernetes القديمة غير متاحة على Grail. استخدم مفاتيح dt.kubernetes.*: تقدم الوثائق جدول مطابقة مع مفاتيح builtin:kubernetes.*.
هل أستخدم dt.containers.* أم dt.kubernetes.container.*؟
انطلق من dt.kubernetes.* للتفكير بالـworkloads والـnamespaces. وأبقِ dt.containers.* للتفاصيل النظامية لحاوية، مثل زمن تقييد المعالج.
هل لهذه المقاييس تكلفة خاصة؟
تشير الوثائق إلى أن مقاييس Kubernetes والحاويات الجديدة تخضع لنموذج ترخيص مستقل عن وحدات المضيف full-stack. تحقق من عقدك قبل تفعيلها على كل العناقيد.
بهذه البطاقات الـ21 تغطي بنية التشغيل، من العملية إلى العنقود. تخرج الوحدة التالية من العنقود إلى الخدمات السحابية والامتدادات.
→ الوحدة 4: مقاييس RUM في Grail · فهرس المسار · الوحدة 6: مقاييس السحابة في Grail ←
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC. لا تغني هذه الوحدة عن الوثائق الرسمية: تحقق من كل مفتاح ووحدة وبعد في الوثائق ومتصفح المقاييس في بيئتك.