Curso: Métricas de Dynatrace SaaS · Módulo 5/7 — métricas de Kubernetes de Grail, procesos, runtimes y contenedores · Formato: fichas de referencia · Plataforma: Dynatrace SaaS (Grail, DQL)
En este módulo:
- Una tabla resumen de 21 métricas
dt.process.*,dt.runtime.*,dt.containers.*ydt.kubernetes.*. - Una ficha por métrica: qué mide, cuándo usarla, la trampa que evitar y una consulta
timeseries. - Un método para comprobar que una clave existe en tu entorno antes de construir un dashboard.
Este quinto módulo del curso de métricas de Dynatrace SaaS reúne las métricas de Kubernetes de Grail y las de las capas que funcionan por debajo: procesos, máquinas virtuales Java y contenedores. Son las métricas que se abren cuando un pod se reinicia, cuando un servicio se ralentiza sin motivo visible en las solicitudes o cuando un nodo se satura. Cada ficha da la clave exacta, su unidad, sus dimensiones principales y una consulta DQL lista para adaptar.
Todo este módulo se refiere a Dynatrace SaaS con Grail y DQL. En Dynatrace Managed, las mismas señales existen en forma de claves clásicas builtin:tech.*, builtin:containers.* y builtin:kubernetes.*, que se consultan con el metric selector: se tratan en el módulo de métricas de proceso builtin del curso de Managed.
Las fichas van directas a la clave. Para combinar estas métricas en ratios (solicitudes frente a consumo, saturación, cuotas) y en alertas, el módulo 7 sobre DQL timeseries da los parámetros útiles.
Las métricas de Kubernetes de Grail y sus vecinas en una tabla
Todas las claves siguientes figuran en la página Built-in Metrics on Grail. Las unidades son las del equivalente clásico documentado en la referencia de las métricas integradas. Las dimensiones indicadas son las que más se usan para agrupar; abre el navegador de métricas para ver la lista completa.
| Clave de Grail | Unidad | Dimensiones principales | Qué mide |
|---|---|---|---|
dt.process.cpu.usage |
% | dt.entity.process_group_instance | CPU consumida por un proceso |
dt.process.memory.working_set_size |
bytes | dt.entity.process_group_instance | Memoria de trabajo del proceso |
dt.process.handles.file_descriptors_percent_used |
% | dt.entity.process_group_instance | Parte de los descriptores de archivo utilizados |
dt.process.network.sessions.reset |
por segundo | dt.entity.process_group_instance | Sesiones TCP entrantes terminadas con un reset |
dt.runtime.jvm.memory_pool.used |
bytes | dt.entity.process_group_instance | Memoria utilizada por pool de la JVM |
dt.runtime.jvm.gc.suspension_time |
% | dt.entity.process_group_instance | Tiempo de pausa debido al recolector de basura |
dt.runtime.jvm.gc.collection_count |
número | dt.entity.process_group_instance | Recolecciones del recolector de basura |
dt.runtime.jvm.threads.count |
número | dt.entity.process_group_instance | Threads de la JVM |
dt.containers.cpu.throttled_time |
ns/min | dt.entity.container_group_instance | Tiempo de limitación de CPU (throttling) de un contenedor |
dt.containers.memory.resident_set_bytes |
bytes | dt.entity.container_group_instance | Memoria residente del contenedor |
dt.containers.memory.limit_bytes |
bytes | dt.entity.container_group_instance | Límite de memoria del contenedor |
dt.kubernetes.container.cpu_usage |
millicores | k8s.cluster.name, k8s.namespace.name, k8s.workload.name | CPU consumida por los contenedores |
dt.kubernetes.container.requests_cpu |
millicores | k8s.cluster.name, k8s.namespace.name, k8s.workload.name | CPU solicitada (requests) |
dt.kubernetes.container.memory_working_set |
bytes | k8s.cluster.name, k8s.namespace.name, k8s.workload.name | Memoria de trabajo de los contenedores |
dt.kubernetes.container.limits_memory |
bytes | k8s.cluster.name, k8s.namespace.name, k8s.workload.name | Límite de memoria declarado |
dt.kubernetes.container.restarts |
número | k8s.cluster.name, k8s.namespace.name, k8s.workload.name | Reinicios de contenedores |
dt.kubernetes.container.oom_kills |
número | k8s.cluster.name, k8s.namespace.name, k8s.workload.name | Detenciones por falta de memoria (OOMKilled) |
dt.kubernetes.workload.pods_desired |
número | k8s.cluster.name, k8s.namespace.name, k8s.workload.name | Pods deseados por el workload |
dt.kubernetes.pods |
número | k8s.cluster.name, k8s.namespace.name, k8s.workload.name | Pods existentes |
dt.kubernetes.node.cpu_allocatable |
millicores | k8s.cluster.name | CPU asignable de los nodos |
dt.kubernetes.persistentvolumeclaim.used |
bytes | k8s.cluster.name, k8s.namespace.name | Espacio utilizado de un volumen persistente |
Procesos: dt.process.*
Las métricas de proceso las recoge OneAgent para cada instancia de grupo de procesos. Responden a la pregunta «¿qué proceso consume qué en este host?».
dt.process.cpu.usage
Porcentaje de la CPU del host consumido por el proceso, con todos sus workers sumados. 100 % significa que el proceso ocupa todos los recursos de CPU disponibles del host. Útil para aislar el proceso responsable cuando dt.host.cpu.usage sube. Trampa: en un host de 16 núcleos, un 10 % ya representa más de un núcleo y medio; compara siempre con el número de núcleos antes de concluir.
timeseries cpu = avg(dt.process.cpu.usage), by: {dt.entity.process_group_instance}
| sort arrayAvg(cpu) desc
| limit 10
dt.process.memory.working_set_size
Memoria de trabajo del proceso, en bytes. Una curva que sube en escalera sin bajar nunca después de los picos de carga es la señal clásica de una fuga de memoria. Para una aplicación Java, cruza la métrica con los pools de la JVM: la memoria del proceso incluye también el código nativo, los threads y los búferes fuera del heap.
timeseries ws = max(dt.process.memory.working_set_size), by: {dt.entity.process_group_instance}dt.process.handles.file_descriptors_percent_used
Parte de los descriptores de archivo abiertos respecto al máximo permitido para el proceso. Un servidor que se acerca al 100 % acaba rechazando conexiones con errores «too many open files», a menudo lejos de la causa real. Una alerta temprana sobre esta métrica evita un incidente difícil de diagnosticar. El umbral queda por fijar según tu aplicación.
timeseries fd = max(dt.process.handles.file_descriptors_percent_used), by: {dt.entity.process_group_instance}
| filter arrayMax(fd) > 80
dt.process.network.sessions.reset
Número de sesiones TCP entrantes terminadas por un error de reset, por segundo. Un aumento repentino suele acompañar a un pool de conexiones mal dimensionado, a un firewall que corta sesiones inactivas o a un servicio remoto que se reinicia. Mira esta métrica cuando la tasa de errores de un servicio aumenta sin ninguna excepción visible en las trazas.
timeseries resets = avg(dt.process.network.sessions.reset), by: {dt.entity.process_group_instance}Runtimes: dt.runtime.jvm.*
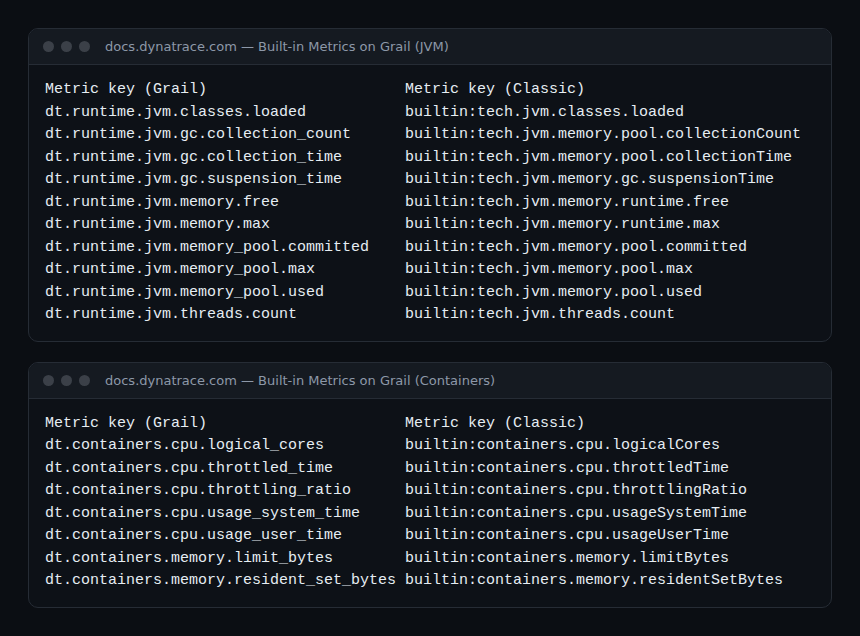
Las métricas de runtime sustituyen en Grail a las claves clásicas builtin:tech.jvm.*. Otros runtimes (Go, Node.js, .NET, PHP) tienen sus propias familias dt.runtime.*; este módulo se centra en la JVM, la más extendida en producción.
dt.runtime.jvm.memory_pool.used
Memoria utilizada por cada pool de la JVM (eden, survivor, old gen, metaspace según el recolector de basura). Compárala con dt.runtime.jvm.memory_pool.max: un pool old gen que se mantiene alto después de cada recolección anuncia una OutOfMemoryError. Trampa: sumar todos los pools no tiene sentido de negocio; míralos por separado.
timeseries used = avg(dt.runtime.jvm.memory_pool.used), by: {dt.entity.process_group_instance}dt.runtime.jvm.gc.suspension_time
Tiempo durante el cual el recolector de basura suspende la JVM, expresado en porcentaje. Durante esas pausas, ninguna solicitud avanza: es una causa frecuente de latencia en el percentil 99 que las trazas muestran sin explicarla. Un valor alto de forma sostenida pide un ajuste del heap o del recolector de basura, no añadir pods.
timeseries gc = avg(dt.runtime.jvm.gc.suspension_time), by: {dt.entity.process_group_instance}dt.runtime.jvm.gc.collection_count
Número de recolecciones efectuadas por el recolector de basura. Por sí sola dice poco; relacionada con la carga, revela una aplicación que asigna demasiados objetos efímeros. Un aumento brusco tras un despliegue suele apuntar a una regresión de código.
timeseries gcs = sum(dt.runtime.jvm.gc.collection_count), by: {dt.entity.process_group_instance}dt.runtime.jvm.threads.count
Número de threads de la JVM. Un crecimiento continuo delata threads que no terminan (pool sin límite, llamadas bloqueadas). Combinada con una latencia que sube, orienta hacia un agotamiento de pool.
timeseries threads = max(dt.runtime.jvm.threads.count), by: {dt.entity.process_group_instance}Contenedores vistos por OneAgent: dt.containers.*
Estas métricas proceden de OneAgent en el host y describen cada instancia de grupo de contenedores. La documentación precisa que las antiguas métricas clásicas de contenedor se han abandonado en favor de estas claves.
dt.containers.cpu.throttled_time
Tiempo durante el cual el contenedor ha sido limitado por su límite de CPU, en nanosegundos por minuto. Un contenedor limitado se ralentiza aunque el host tenga todavía CPU libre: es la trampa clásica de los límites de CPU demasiado bajos. La página de migración de Kubernetes de la documentación muestra cómo convertir este valor en millicores.
timeseries throttled = avg(dt.containers.cpu.throttled_time), by: {dt.entity.container_group_instance}dt.containers.memory.resident_set_bytes
Memoria residente del contenedor, en bytes. Es la medida que hay que acercar al límite para estimar el riesgo de detención por falta de memoria. Trampa: la caché de páginas no se cuenta aquí; tiene su propia clave, dt.containers.memory.cache_bytes.
timeseries rss = avg(dt.containers.memory.resident_set_bytes), by: {dt.entity.container_group_instance}dt.containers.memory.limit_bytes
Límite de memoria del contenedor, en bytes. Sin límite, el valor está vacío. La documentación calcula un porcentaje de uso dividiendo la memoria residente por este límite, o por la memoria física total cuando no existe límite.
timeseries {
    rss = avg(dt.containers.memory.resident_set_bytes),
    lim = avg(dt.containers.memory.limit_bytes)
  }, by: {dt.entity.container_group_instance}
| fieldsAdd pct = 100 * rss[] / lim[]
Kubernetes: dt.kubernetes.*
Estas métricas llegan con la nueva experiencia de Kubernetes, mediante ActiveGate 1.279 o posterior. Las antiguas métricas de Kubernetes no están disponibles en Grail: parte directamente de estas claves.
dt.kubernetes.container.cpu_usage
CPU consumida por los contenedores (usuario y sistema), en millicores. Su valor más útil es relativo: comparada con las requests, muestra los workloads infra o sobredimensionados. El nivel más fino es el contenedor; agrupa por workload para leer una aplicación.
timeseries cpu = sum(dt.kubernetes.container.cpu_usage),
  by: {k8s.cluster.name, k8s.namespace.name, k8s.workload.name}
dt.kubernetes.container.requests_cpu
CPU solicitada por los contenedores (requests), en millicores. El scheduler coloca los pods según este valor, no según el consumo real. Una diferencia sostenida entre requests y uso desperdicia capacidad o, a la inversa, prepara una contención en el nodo.
timeseries {
    usage = sum(dt.kubernetes.container.cpu_usage),
    req = sum(dt.kubernetes.container.requests_cpu)
  }, by: {k8s.namespace.name, k8s.workload.name}
| fieldsAdd ratio = 100 * usage[] / req[]
dt.kubernetes.container.memory_working_set
Memoria de trabajo de los contenedores, en bytes. Es el valor que vigila el kubelet para decidir una expulsión y que el kernel compara con el límite. La documentación lo agrega al nivel de workload sumando por clúster, namespace y workload.
timeseries memory_working_set = sum(dt.kubernetes.container.memory_working_set),
  by: {k8s.cluster.name, k8s.namespace.name, k8s.workload.name}
dt.kubernetes.container.limits_memory
Límite de memoria declarado para los contenedores, en bytes. Relacionado con memory_working_set, da el margen restante antes de un OOMKill. Trampa: un contenedor sin límite no aparece en esta serie, lo que falsea un ratio calculado sobre todo un namespace.
timeseries {
    ws = sum(dt.kubernetes.container.memory_working_set),
    lim = sum(dt.kubernetes.container.limits_memory)
  }, by: {k8s.namespace.name, k8s.workload.name}
| fieldsAdd marge = 100 * ws[] / lim[]
dt.kubernetes.container.restarts
Reinicios de contenedores, según el restartCount del estado del pod. La documentación de las métricas clásicas precisa que el valor solo se escribe si ha habido al menos un reinicio: una serie vacía significa «ningún reinicio», no un fallo de recogida. Es el primer indicador de un CrashLoopBackOff.
timeseries restarts = sum(dt.kubernetes.container.restarts),
  by: {k8s.namespace.name, k8s.workload.name}
| filter arraySum(restarts) > 0
dt.kubernetes.container.oom_kills
Número de detenciones de contenedores con el estado OOMKilled. Como los reinicios, la serie solo existe si ha habido al menos un evento. Un OOMKill recurrente en un workload se corrige con el límite de memoria o con el código, rara vez añadiendo réplicas. El diagnóstico completo se detalla en CrashLoopBackOff y OOMKilled: diagnosticar los pods.
timeseries oom = sum(dt.kubernetes.container.oom_kills),
  by: {k8s.namespace.name, k8s.workload.name}
dt.kubernetes.workload.pods_desired
Número de pods deseados por el workload (réplicas declaradas). Comparado con dt.kubernetes.pods, revela un despliegue bloqueado: imagen no encontrada, cuota alcanzada, nodos llenos.
timeseries {
    desired = max(dt.kubernetes.workload.pods_desired),
    actual = max(dt.kubernetes.pods)
  }, by: {k8s.namespace.name, k8s.workload.name}
dt.kubernetes.pods
Número de pods, agrupable por workload. Útil para seguir un autoescalado horizontal o detectar la desaparición de pods tras un incidente de nodo. Trampa: este recuento incluye todos los pods, sea cual sea su estado; no lo leas como un número de pods listos.
timeseries pods = max(dt.kubernetes.pods), by: {k8s.namespace.name, k8s.workload.name}dt.kubernetes.node.cpu_allocatable
CPU asignable de los nodos, en millicores: la capacidad realmente disponible para los pods, tras las reservas del sistema. Comparada con la suma de las requests, indica cuántos pods puede acoger todavía el clúster. La misma lógica vale para memory_allocatable y pods_allocatable.
timeseries alloc = sum(dt.kubernetes.node.cpu_allocatable), by: {k8s.cluster.name}dt.kubernetes.persistentvolumeclaim.used
Bytes utilizados en un volumen persistente, medidos a nivel de PersistentVolumeClaim. Relacionado con dt.kubernetes.persistentvolumeclaim.capacity, anticipa un disco lleno en una base de datos o una cola de mensajes, un incidente largo de resolver una vez producido.
timeseries {
    used = avg(dt.kubernetes.persistentvolumeclaim.used),
    cap = avg(dt.kubernetes.persistentvolumeclaim.capacity)
  }, by: {k8s.namespace.name}
| fieldsAdd pct = 100 * used[] / cap[]
Cómo comprobar que funciona
- Abre un notebook y lanza
timeseries sum(dt.kubernetes.pods), by: {k8s.cluster.name}: cada clúster monitorizado debe devolver una serie. La ausencia de resultados suele significar que la nueva experiencia de Kubernetes no está activada. - Para las métricas de proceso y de JVM, filtra por un host conocido y comprueba que
dt.process.cpu.usagedevuelve sus procesos principales. - Antes de construir una alerta, muestra la clave en el navegador de métricas: da la lista exacta de las dimensiones disponibles en tu entorno.
- Para las series «escritas solo si hay un evento» (reinicios, OOMKills), prueba la consulta en un periodo en el que haya habido un incidente.
Las consultas de este módulo siguen la sintaxis detallada en DQL timeseries: la guía avanzada. Para transformar estas señales en alertas, consulta las alertas de Kubernetes sobre nodos, pods y cuotas.
Preguntas frecuentes
¿Por qué mi consulta sobre una clave antigua de Kubernetes no devuelve nada?
Las antiguas métricas de Kubernetes no están disponibles en Grail. Usa las claves dt.kubernetes.*: la documentación proporciona una tabla de correspondencia con las claves builtin:kubernetes.*.
¿Hay que usar dt.containers.* o dt.kubernetes.container.*?
Parte de dt.kubernetes.* para razonar en workloads y namespaces. Reserva dt.containers.* para el detalle de sistema de un contenedor, como el tiempo de limitación de CPU.
¿Tienen estas métricas un coste particular?
La documentación indica que las nuevas métricas de Kubernetes y de contenedor dependen de un modelo de licencia distinto de las unidades de host full-stack. Revisa tu contrato antes de activarlas en todos los clústeres.
Con estas 21 fichas cubres la pila de ejecución, del proceso al clúster. El módulo siguiente sale del clúster y pasa a los servicios cloud y a las extensiones.
← Módulo 4: métricas RUM en Grail · Índice del curso · Módulo 6: métricas cloud en Grail →
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Este módulo no sustituye la documentación oficial: comprueba cada clave, unidad y dimensión en la documentación y en el navegador de métricas de tu entorno.