Curso: Métricas de Dynatrace SaaS · Módulo 7/7 — DQL timeseries, métricas personalizadas y alertas · Duración: ~75 min · Nivel: intermedio a avanzado
Objetivos:
- Dominar los parámetros del comando DQL timeseries:
by,filter,interval,bins,rollup,default,nonempty,union,shift. - Calcular ratios entre series y trazar logs o spans con
makeTimeseries. - Crear métricas personalizadas: API de ingesta, OpenTelemetry o extracción con OpenPipeline.
- Definir una alerta sobre una consulta
timeseriescon la aplicación Anomaly Detection.
Requisitos previos: módulos 1 a 6 del curso, las bases de DQL (fetch, filter, summarize) y, para la parte de ingesta, un token autorizado a ingerir métricas.
Una consulta de métrica errónea no falla: devuelve un gráfico plausible y un SLI incorrecto. Este último módulo del curso de métricas de Dynatrace SaaS explora el comando DQL timeseries más allá de la agregación simple, parámetro por parámetro, y después muestra cómo añadir tus propias métricas a Grail y disparar una alerta cuando se desvían.
El contenido vale para Dynatrace SaaS: timeseries, makeTimeseries, OpenPipeline y Anomaly Detection son propios de la plataforma Grail. En Dynatrace Managed, el equivalente pasa por el metric selector y la Metrics API v2; la API de ingesta y su protocolo de línea existen en ambos. Para las bases de DQL, repasa los fundamentos de DQL.
La sintaxis completa de DQL timeseries
La documentación da la siguiente forma general:
timeseries [column =] aggregation(metricKey [, filter:] [, default:] [, rollup:] [, rate:] [, scalar:])
  [, by:] [, filter:] [, union:] [, nonempty:] [, interval: | bins:]
  [, from:] [, to:] [, timeframe:] [, shift:]
Las agregaciones disponibles son sum, avg, min, max, count (el número de series, es decir, la cardinalidad), percentile, percentRank y countDistinct. El resultado contiene siempre las columnas timeframe e interval, y después un array de valores por agregación y por combinación de dimensiones.
by y filter: dividir y restringir
by divide el resultado por dimensión; filter restringe las series antes de la agregación. Filtrar dentro del comando es más eficaz que filtrar después, porque se cargan menos series.
timeseries p90 = percentile(dt.service.request.response_time, 90),
  by: { dt.entity.service },
  filter: in(dt.entity.service, "SERVICE-1", "SERVICE-2"),
  interval: 5m, from: -24h
Solo dt.service.request.response_time y dt.service.request.service_mesh.response_time aceptan percentile sin rollup. Para un indicador de tipo gauge como la CPU, escribe percentile(dt.host.cpu.usage, 90, rollup: avg). Cuidado también con la unidad: el tiempo de respuesta de servicio se expresa en microsegundos.
interval y bins: la resolución nunca es exactamente la solicitada
interval fija la duración de un punto y bins el número de puntos; ambos se excluyen. La plataforma redondea a un intervalo conocido (1, 2, 3, 5, 10, 15 o 30 minutos; 1, 2, 3, 4, 6, 8, 12 o 24 horas; después múltiplos de 24 horas), limita cada serie a 1500 elementos y alinea los intervalos con la medianoche. Pedir interval: 5h da, por tanto, intervalos de 6 h. Para un SLI, lee siempre la columna interval del resultado.
rollup, default, nonempty y rate
rollup(min,max,sum,avg,total) separa la agregación en el tiempo de la agregación entre series:avg(dt.requests.failed, rollup: sum)calcula la media, entre series, de las sumas por intervalo.defaultsustituye los intervalos vacíos (null) por un valor. Es indispensable antes de una división.nonempty: truedevuelve una serie incluso sin datos. Sin él, un ratio de errores sin ningún error devuelve «ningún registro» en lugar de 0 %.ratenormaliza por una duración:sum(dt.requests.failed, rate: 1s)da un caudal por segundo, independiente del intervalo elegido.
union: la intersección silenciosa
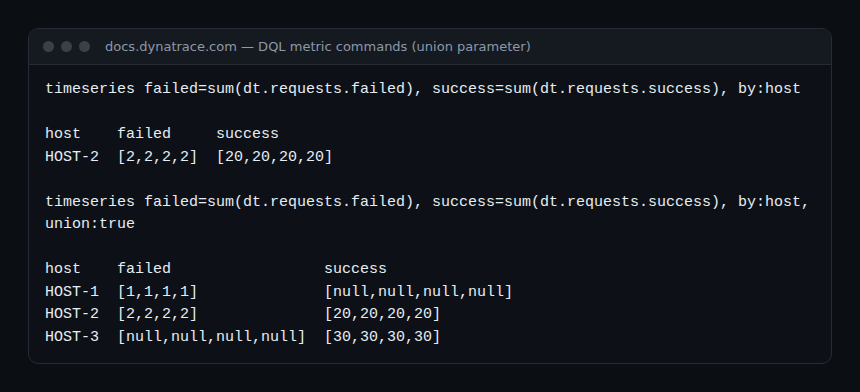
Cuando una consulta contiene varias agregaciones, timeseries conserva por defecto solo las series presentes en todas las columnas, como un INNER JOIN. Un host que no tiene ninguna solicitud fallida desaparece, por tanto, del resultado. union: true conserva todas las series, con columnas posiblemente vacías.
Aritmética entre series y comparación en el tiempo
El operador [] aplica un cálculo elemento a elemento sobre arrays de la misma longitud. Es la base de los ratios de errores:
timeseries {
  failed = sum(dt.service.request.failure_count, default: 0),
  total  = sum(dt.service.request.count)
}, by: { dt.entity.service }, nonempty: true, union: true
| fieldsAdd error_rate = failed[] / total[] * 100
Para reducir un array a un solo valor, usa arrayAvg, arrayMax o arraySum, o el parámetro scalar: true. El parámetro shift desplaza la ventana consultada y realinea las marcas de tiempo; combinado con append, superpone hoy y la semana pasada:
timeseries avail = avg(dt.host.disk.avail), by: { dt.entity.host }, from: -24h
| append [
    timeseries avail.7d = avg(dt.host.disk.avail), by: { dt.entity.host }, shift: -7d
  ]
makeTimeseries: series a partir de logs y spans
timeseries lee métricas. Para trazar registros, usa makeTimeseries después de un fetch. El campo de tiempo por defecto es timestamp, y después start_time si el primero no existe, lo que permite aplicarlo directamente a los spans:
fetch spans
| filter request.is_root_span == true
| filter endpoint.name == "GET /api/cart"
| makeTimeseries { p50 = median(duration), p90 = percentile(duration, 90) }
Para los logs, fetch logs | filter loglevel == "ERROR" | makeTimeseries count(default: 0), interval: 30m, nonempty: true produce una curva de errores a cero en lugar de un resultado vacío. Ten presente el coste: makeTimeseries vuelve a leer los registros en bruto en cada ejecución. Para un indicador que se muestra de forma permanente, es preferible una métrica creada en la ingesta, lo que lleva a lo siguiente.
Crear tus propias métricas
| Vía | Cuándo elegirla | Punto de atención |
|---|---|---|
| API de ingesta (protocolo de línea) | Scripts, tareas programadas, equipos sin SDK | Prefijo dt. reservado, carga útil limitada a 1 MB |
| OpenTelemetry (OTLP) | Aplicaciones instrumentadas con un SDK o un Collector | Dynatrace espera una temporalidad delta |
| Extracción con OpenPipeline | La información ya existe en logs, spans o eventos | La métrica solo existe a partir de los datos ingeridos después de la regla |
El protocolo de línea y la API de ingesta
Una línea sigue la forma metric.key,dimensions payload, con una marca de tiempo opcional en milisegundos. La carga útil es un gauge (por defecto) o un contador:
cpu.temperature,hostname=hostA,cpu=1 55
new_user_count,region=EAST count,delta=50
mymetric,team=teamA,businessapp=hr 1000 1609459200000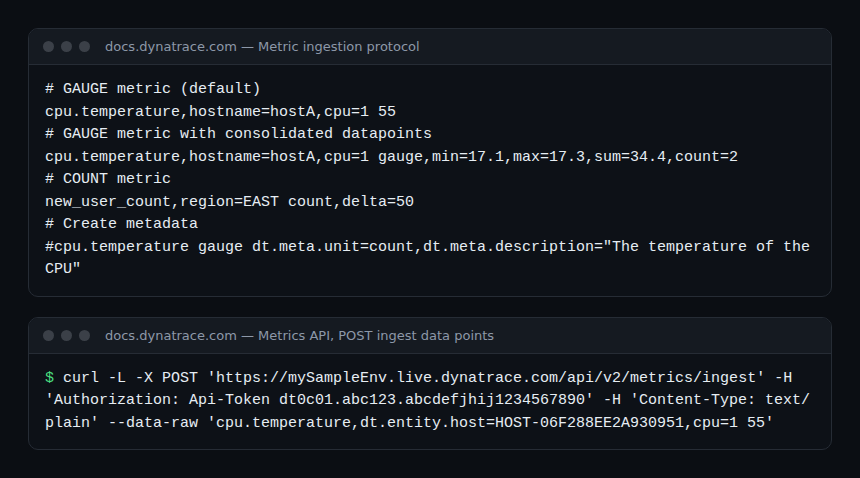
curl -L -X POST 'https://{your-environment-id}.live.dynatrace.com/api/v2/metrics/ingest' \
  -H 'Authorization: Api-Token <votre-token>' \
  -H 'Content-Type: text/plain' \
  --data-raw 'shop.orders.validated,channel=web count,delta=12'
Con un token de acceso clásico, el scope necesario es metrics.ingest; con un token de plataforma o un cliente OAuth, es openpipeline:metrics:ingest. Una respuesta 400 señala líneas no válidas, y las líneas válidas se procesan igualmente. Trampa frecuente: para un contador, el modelo clásico añade el sufijo .count, pero Grail no. Por tanto, se consulta timeseries orders = sum(shop.orders.validated), by: { channel }.
OpenTelemetry y OpenPipeline
Un SDK o un Collector de OpenTelemetry exporta a https://{your-environment-id}.live.dynatrace.com/api/v2/otlp/v1/metrics. Dynatrace espera contadores en delta (OTEL_EXPORTER_OTLP_METRICS_TEMPORALITY_PREFERENCE=delta en el SDK); el tema se detalla en temporalidad de las métricas OTLP. Los atributos se convierten en dimensiones: evita los identificadores únicos.
Cuando la información ya está en los logs, OpenPipeline ofrece dos procesadores de extracción: Counter metric cuenta los registros que cumplen una condición y Value metric toma el valor numérico de un campo, extraído si hace falta a un campo temporal dt.temp.* que nunca se almacena en Grail. Las métricas de histograma se tratan en métricas de histograma con OpenPipeline.
Generar alertas sobre una consulta DQL timeseries
En la aplicación Anomaly Detection, una alerta personalizada parte de una consulta timeseries y de un analizador. El umbral estático compara cada punto con un valor fijo; la línea base estacional conviene a las métricas que siguen un ritmo. Los parámetros de un umbral estático, tal como los expone la documentación en la API Settings (esquema builtin:davis.anomaly-detectors):
"analyzer": {
  "name": "dt.statistics.ui.anomaly_detection.StaticThresholdAnomalyDetectionAnalyzer",
  "input": [
    { "key": "query", "value": "timeseries avg(dt.host.disk.free), by:{dt.entity.host, dt.entity.disk}" },
    { "key": "threshold", "value": "10" },
    { "key": "alertCondition", "value": "BELOW" },
    { "key": "violatingSamples", "value": "3" },
    { "key": "slidingWindow", "value": "5" },
    { "key": "dealertingSamples", "value": "5" }
  ]
}
La alerta se dispara cuando 3 puntos de una ventana deslizante de 5 caen por debajo del umbral, y solo se cierra tras 5 puntos de vuelta a la normalidad: los picos aislados se filtran y la alerta no oscila. No pongas un valor escalar cambiante en las dimensiones de la consulta, o crearás una serie nueva en cada evaluación.
Cómo comprobar que funciona
- La consulta del ratio de errores sobre un servicio sin errores devuelve una serie a 0, no un resultado vacío.
timeseries avg(dt.host.cpu.usage), interval: 5h, from: -2dmuestra 6 h en la columnainterval.- La respuesta de la API de ingesta muestra
linesInvalid: 0, ymetrics | filter metric.key == "shop.orders.validated" | limit 1devuelve la métrica unos instantes después del envío. - Ejecutada sola en un notebook, la consulta de la alerta devuelve una serie por entidad monitorizada.
Buenas prácticas
- Filtra dentro del comando
timeseriesy no después: menos series leídas, consultas más rápidas. - Antes de cualquier división, añade
default: 0al numerador ynonempty: true, y piensa enunion. - Nombra tus claves con un prefijo de equipo y limita las dimensiones a lo que sirve para filtrar o dividir.
- Prefiere una métrica extraída a
makeTimeseriespara los indicadores que se muestran de forma permanente. - Vincula cada alerta a un SLO o a una acción de guardia clara. Los ejemplos de consultas DQL de operación pueden servir de base.
Ejercicio práctico
- Escribe el ratio de errores por servicio en 24 h, sin y con
union. Cuenta los servicios de cada resultado. - Envía tres líneas de contador
training.eventscon dos valores de la dimensiónenvy traza despuéstimeseries sum(training.events), by: { env }. - Crea en Anomaly Detection una alerta de umbral estático sobre esa métrica, con un umbral que tus envíos superen.
Resultado esperado: explicas la diferencia del paso 1 y sabes prever el disparo de la alerta.
Cuestionario
- ¿Qué devuelve
interval: 5h? A) 5 h exactas B) 6 h C) Un error - ¿Por qué desaparece de un cálculo fallos/total un host sin fallos? A) El comportamiento por defecto es una intersección B) Un error de permisos
- ¿Qué comando traza spans en el tiempo? A)
timeseriesB)makeTimeseries - ¿Con qué clave se consulta en Grail un contador enviado como
coffees.brewing count,delta=2? A)coffees.brewing.countB)coffees.brewing
Soluciones
- B. 5 h no es un intervalo conocido; la plataforma elige 6 h.
- A. Sin
union: true, solo se conservan las series presentes en todas las columnas. - B.
makeTimeseriesagrega registros;timeseriessolo lee métricas. - B. El sufijo
.countsolo existe en el modelo clásico.
← Módulo 6: métricas cloud en Grail · Índice del curso · Volver al módulo 1 →
Preguntas frecuentes
¿Qué diferencia hay entre timeseries y makeTimeseries?
timeseries es un comando inicial que lee las métricas almacenadas en Grail. makeTimeseries se coloca después de un fetch y construye una serie a partir de registros: logs, spans, eventos o business events.
¿Hay que declarar una métrica antes de enviarla?
No. La métrica se crea en la primera ingesta. Los metadatos (nombre mostrado, unidad, descripción) pueden añadirse después, por ejemplo con una línea que empiece por #.
¿Cómo conocer las dimensiones de una métrica?
Usa metrics | filter metric.key == "mi.clave" | limit 1 o el archivo /dt/platform/metrics.metadata con el comando load.
Has terminado el curso: sabes leer las métricas integradas, consultarlas con precisión, crear las tuyas y generar alertas sobre ellas. Referencias: DQL metric commands y Metrics API, POST ingest data points.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Este curso no sustituye las formaciones y certificaciones oficiales de Dynatrace University. Comprueba siempre los scopes y la sintaxis en la documentación oficial correspondiente a tu entorno.