Parcours : Métriques Dynatrace SaaS · Module 1/7 — les métriques Grail · Durée : ~40 min · Niveau : Débutant à intermédiaire
Objectifs :
- Lire une clé de métrique
dt.*et savoir ce qu’elle mesure. - Comprendre le rôle des dimensions et de la commande DQL
timeseries. - Faire correspondre une clé classique
builtin:à sa clé Grail. - Connaître la résolution, la rétention et les permissions des métriques sur Grail.
Prérequis : un environnement Dynatrace SaaS avec au moins un OneAgent, l’application Notebooks et des bases de DQL.
Les métriques Grail sont les séries temporelles que Dynatrace SaaS range dans Grail, à côté des logs, des spans et des événements. Ce premier module du parcours Métriques Dynatrace SaaS pose le vocabulaire : clés dt.*, dimensions, agrégations, correspondance avec les anciennes clés et durée de conservation.
Pour un SRE, une métrique est la matière première d’un SLI. Si vous lisez mal une clé ou une unité, votre SLO mesure autre chose que ce que vous croyez, et l’astreinte paie la différence. Prendre une heure pour comprendre le modèle évite des semaines de tableaux de bord trompeurs.
Ce module vaut pour Dynatrace SaaS (plateforme avec Grail). Dynatrace Managed n’a ni Grail ni DQL : ses métriques se manipulent avec le metric selector, traité dans le parcours Métriques Dynatrace Managed.
Que sont les métriques Grail ?
Une métrique sur Grail est une suite de mesures numériques horodatées, identifiée par une clé et décrite par des dimensions. OneAgent produit automatiquement les métriques intégrées (built-in) ; d’autres arrivent par OpenTelemetry, par l’API d’ingestion ou par extraction depuis des logs et des spans (module 7).
La documentation résume ce que Grail apporte aux métriques :
- une résolution d’une minute conservée 15 mois ;
- un enrichissement par le contexte (hôte, processus, Kubernetes, cloud) ;
- une cardinalité sans limite fixe, utile pour des déploiements Kubernetes très dynamiques ;
- la possibilité de créer des séries à partir des logs, des spans ou d’autres données.
La consommation des métriques sur Grail relève du modèle Dynatrace Platform Subscription (DPS). Vérifiez votre contrat avant d’ingérer massivement des métriques personnalisées.
Anatomie d’une clé dt.*
Les clés fournies par Dynatrace suivent trois règles de nommage, décrites dans la page « Built-in Metrics on Grail » :
- le préfixe
builtin:est remplacé pardt., qui signale une métrique fournie par Dynatrace ; - le snake case remplace le camel case :
bytes_readplutôt quebytesRead; - le nom décrit plus précisément la mesure :
dt.host.disk.used.percentplutôt queusedPct.
Lisez une clé de gauche à droite, du plus général au plus précis : dt.host.memory.avail.percent désigne la mémoire disponible d’un hôte, en pourcentage. Les métriques que vous créez vous-même ne commencent pas par dt. : ce préfixe est réservé.
Correspondance builtin: vers dt.*
Si vous venez de Dynatrace Managed ou de Metrics Classic, vos requêtes, alertes et tableaux de bord utilisent des clés builtin:. La documentation publie la table de correspondance complète. Voici un extrait réel :
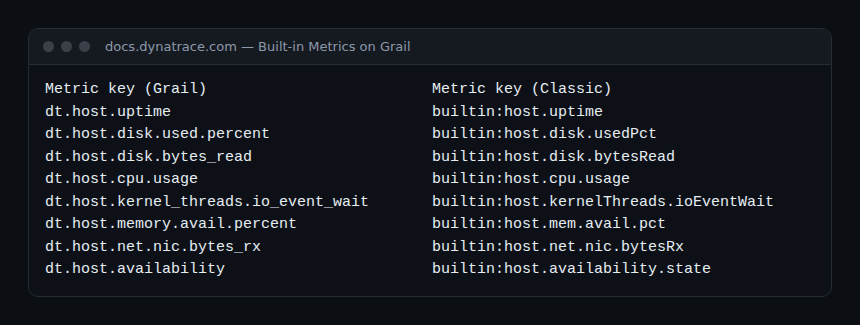
Trois cas demandent de l’attention lors d’une migration :
- Métriques pré-agrégées absentes.
builtin:host.net.bytesRxagrégeait déjà les interfaces réseau par hôte. Grail gère la cardinalité élevée : on interroge directementdt.host.net.nic.bytes_rxet on regroupe par hôte. De même,builtin:host.mem.totaln’est pas reprise. - Extensions 1.0. Les métriques
builtin:tech.*issues d’Extensions 1.0 apparaissent avec le préfixelegacy., par exemplelegacy.cassandra.KeyCache.Hit.Rate. Exception : les métriques de processus génériques (builtin:tech.generic.*) et WebSphere. - Services. Une trentaine de clés de service classiques convergent vers trois métriques par endpoint, filtrées par dimensions (module 3). Les métriques calculées de service passent du préfixe
calc:serviceau préfixeservice.une fois activées sur Grail.
Le guide migrer de Managed vers SaaS replace cette correspondance dans un projet de migration complet.
Dimensions, agrégations et timeseries
Une dimension est une paire clé-valeur attachée à chaque point : dt.entity.host, dt.smartscape.host, endpoint.name, k8s.namespace.name… Elle sert à filtrer et à découper la série. Une même clé de métrique avec des valeurs de dimensions différentes forme autant de séries distinctes.
On lit une métrique avec la commande DQL timeseries, commande de départ qui charge, filtre et agrège en une seule étape. Elle accepte les agrégations sum, avg, min, max, count, percentile, percentRank et countDistinct, et des paramètres comme by:, filter:, interval:, from: ou rollup: (min, max, sum, avg, total).
Le résultat est homogène : toutes les séries partagent le même timeframe et le même interval, et chaque cellule contient un tableau de valeurs, une par intervalle. Sans interval:, Dynatrace choisit un pas adapté à la période, aligné sur une valeur connue (1, 2, 5, 10 minutes, 1 heure…). Les fondamentaux du langage sont dans le module DQL fondamentaux ; le module 5 de ce parcours approfondit timeseries.
Explorer les métriques disponibles
La commande metrics liste les séries existantes, sans valeurs ni horodatage. Elle sert à découvrir les clés et les dimensions, sur les dix derniers jours au maximum et dans la limite de 100 000 séries par requête. Pour obtenir les métadonnées (description, dimensions), la documentation renvoie aussi au fichier de lookup /dt/platform/metrics.metadata.
Exercice pratique
Étape 1 — Lister les clés d’un hôte
Dans un notebook, récupérez l’identifiant d’un hôte surveillé (format HOST-…) puis exécutez l’exemple de la documentation :
metrics
| filter dt.entity.host == "HOST-6DF6DE092963F2AB"
| dedup metric.key
Résultat attendu : une liste de clés dt.host.*, dt.process.* et autres, envoyées par cet hôte.
Étape 2 — Tracer une première série
timeseries usage = avg(dt.host.cpu.usage)La requête renvoie une seule série : la moyenne de l’utilisation CPU de tous les hôtes. Affichez-la en courbe.
Étape 3 — Découper par dimension
timeseries usage = avg(dt.host.cpu.usage), by: {dt.smartscape.host}
| fieldsAdd host_name = getNodeName(dt.smartscape.host)
Résultat attendu : une série par hôte, avec son nom lisible. Comparez le nombre de lignes au nombre d’hôtes de l’environnement.
Étape 4 — Fixer l’intervalle et la période
timeseries usage = avg(dt.host.cpu.usage), by: {dt.smartscape.host}, interval: 1h, from: -7dObservez la colonne interval : elle vaut une heure, et chaque tableau contient environ 168 valeurs.
Comment vérifier que ça fonctionne
Si timeseries renvoie une erreur d’accès plutôt qu’un résultat vide, vérifiez vos permissions : la lecture des métriques demande storage:metrics:read et storage:buckets:read. Un résultat vide sur dt.host.cpu.usage signifie en général qu’aucun OneAgent n’envoie de données sur la période choisie : élargissez from: avant de chercher plus loin.
Bonnes pratiques
- Vérifiez chaque clé dans la table de la documentation avant de la mettre dans une alerte : une clé inexistante ne lève pas d’erreur, elle renvoie juste un résultat vide.
- Notez l’unité à côté du SLI :
dt.service.request.response_time, par exemple, est exprimée en microsecondes. - Découpez par le moins de dimensions possible : chaque dimension multiplie le nombre de séries à lire et à afficher.
- Gardez
metricspour l’exploration ettimeseriespour les graphiques et les calculs.
Pour aller plus loin
- Métriques histogrammes et OpenPipeline, pour les percentiles sur vos propres métriques
- Dashboard Dynatrace SaaS : exemples DQL
- Documentation officielle : Built-in Metrics on Grail et DQL metric commands
← Présentation du parcours · Sommaire du parcours · Module 2 : Métriques hôte Grail →
Questions fréquentes
Les clés builtin: fonctionnent-elles encore dans Dynatrace SaaS ?
Elles restent utilisables avec Metrics Classic (API Metrics v2, Data Explorer). Dans DQL et sur Grail, il faut employer les clés dt.* correspondantes, d’où l’intérêt de la table de correspondance.
Combien de temps les métriques sont-elles conservées sur Grail ?
La documentation annonce une résolution d’une minute pendant 15 mois. Les règles de rétention propres à votre compte et à vos buckets restent à vérifier dans les réglages de l’environnement.
Faut-il utiliser dt.entity.host ou dt.smartscape.host ?
Les deux dimensions apparaissent dans la documentation. Les exemples récents utilisent dt.smartscape.host avec getNodeName() ; les exemples de référence de timeseries utilisent encore dt.entity.host. Choisissez-en une et restez cohérent dans un même tableau de bord.
Vous savez lire une clé dt.*, la retrouver depuis une clé builtin: et la tracer avec timeseries. Le module suivant applique ces bases aux métriques hôte, les plus utilisées en astreinte.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Ce parcours ne remplace pas les formations et certifications officielles de Dynatrace University. Vérifiez les clés de métriques dans la documentation officielle de votre environnement.