
Il est 3 h du matin, un problème s’ouvre sur un hôte, et la personne d’astreinte ne sait pas à qui il appartient. Elle fouille un wiki, écrit dans trois canaux, perd vingt minutes. Le ownership Dynatrace sert à supprimer cette recherche : chaque entité supervisée porte une étiquette qui désigne une équipe, et l’équipe porte ses moyens de contact.
Cet article part d’une décision d’exploitation : où doit vivre la vérité sur « qui possède quoi » ? Je compare trois choix possibles, puis je montre comment poser les étiquettes, alimenter les équipes et router une alerte avec un workflow. Il vaut pour Dynatrace SaaS ; la documentation Managed existe aussi, avec un contenu proche, mais je ne l’ai pas éprouvée (voir plus bas).
Précision d’honnêteté : span.observer n’a pas monté ce dispositif sur un tenant pour cet article. Les faits viennent de la documentation officielle et d’un billet de l’éditeur ; les exemples sont des modèles à adapter, pas des résultats mesurés.
Ownership Dynatrace : deux couches à ne pas confondre
La documentation décrit l’ownership comme des paires clé-valeur posées sur les nœuds Smartscape. Autrement dit, deux objets distincts travaillent ensemble.
- L’étiquette sur l’entité : une clé reconnue (par défaut
owneroudt.owner) et une valeur, l’identifiant de l’équipe. - La fiche d’équipe : un nom, un identifiant, des responsabilités, des liens et des canaux de contact (Slack, Microsoft Teams, Jira, e-mail).
Le lien se fait par l’identifiant. Si l’étiquette dit team-payments et que la fiche porte cet identifiant, Dynatrace sait qui prévenir. Sans fiche, vous avez un nom mais aucun moyen de joindre qui que ce soit.
Décider d’abord : la source de vérité
Avant de taguer quoi que ce soit, choisissez qui fait foi. Trois options reviennent.
- La saisie manuelle dans l’interface. Rapide pour dix équipes, intenable à cent : les responsabilités bougent à chaque déploiement.
- Un annuaire existant (Microsoft Entra ID ou ServiceNow) synchronisé régulièrement. C’est le choix le plus durable si vos équipes y sont déjà tenues à jour.
- La configuration as code (Settings API, Monaco ou Terraform). Elle donne un historique Git, mais demande une équipe qui accepte de relire des fichiers JSON.
Mon avis : retenez un seul maître et laissez Dynatrace en recevoir une copie. Deux sources qui divergent produisent exactement le doute que vous vouliez éviter. Pour la partie as code, l’article sur Terraform donne le cadre général.
Choisir les clés d’étiquette
La documentation indique deux clés par défaut, owner et dt.owner, et jusqu’à trois clés personnalisées, à régler dans Settings > Environment segmentation > Ownership > Keys. Un point surprend : les clés sont comparées comme des préfixes, pas comme des égalités exactes.
Conséquence pratique : si vous déclarez team., les clés team.frontend, team.backend et team.support comptent toutes. C’est pratique pour réutiliser une convention existante, mais un préfixe trop large ramasse des étiquettes sans rapport. Gardez un préfixe qui ne ressemble à aucune autre étiquette de votre parc.
La valeur est un identifiant, éventuellement suivi d’un identifiant complémentaire. L’identifiant est obligatoire, unique et ne peut plus être modifié ; l’identifiant complémentaire reste modifiable. Choisissez donc des identifiants stables (team-payments) plutôt que des noms qui changeront à la prochaine réorganisation.
Poser les étiquettes sur les entités
La documentation recommande trois voies : les labels et annotations Kubernetes, les propriétés d’hôte posées avec oneagentctl, et les variables d’environnement des groupes de processus. Pour un cluster, l’annotation dans le manifeste reste la plus propre, car elle voyage avec le déploiement. Pour un hôte classique, la commande suffit.
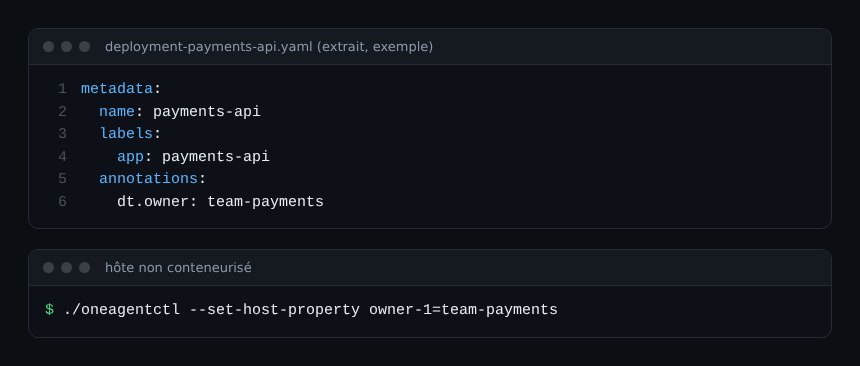
Je n’ai pas vérifié ici si l’annotation doit être autorisée côté configuration Kubernetes de Dynatrace avant d’être lue : testez sur un seul déploiement avant de généraliser. De même, la documentation ne détaille pas la propagation le long de la topologie ; ne la supposez pas.
Alimenter les fiches d’équipe
L’action Import teams d’un workflow sait lire trois sources : les groupes Entra ID, les groupes ServiceNow, ou un JSON au schéma Ownership. Elle demande aussi deux préférences : ignorer ou écraser les équipes existantes, et échouer en bloc ou continuer en journalisant les erreurs. Pour une première synchronisation, « continuer en journalisant » évite qu’une ligne invalide bloque tout.
La sortie indique un statut (SUCCESS, PARTIAL ou FAILED), les identifiants importés, les doublons et les échecs. Surveillez les doublons : un identifiant déjà pris ne sera pas redéfini.
Voici une fiche au format JSON du schéma, avec des valeurs d’exemple. Les cinq responsabilités sont obligatoires, comme les listes de contacts et de liens.
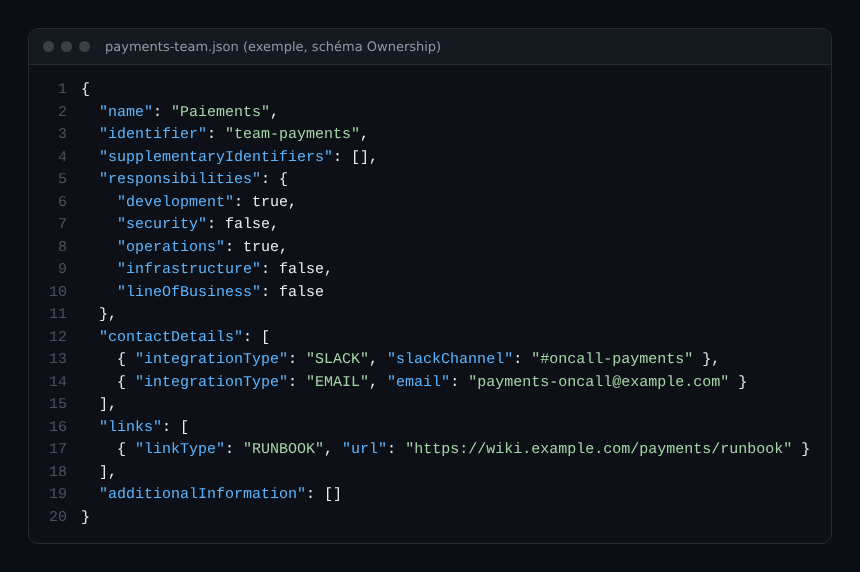
Pour créer des équipes à la main ou par API, il faut la permission de gérer les paramètres de surveillance (interface), ou settings.write / une politique IAM sur le schéma builtin:ownership.teams (API). La page sur la création d’équipes mentionne aussi builtin:ownership.config sans réconcilier les deux : vérifiez l’identifiant exact dans votre environnement.
Router une alerte avec l’action Get owners
Le routage lui-même passe par un workflow. L’action Get owners reçoit des identifiants d’entités (par exemple {{ event()["dt.entity.host"] }} pour un événement de problème), un filtre d’équipe et un filtre de responsabilité. Elle renvoie owners et, par équipe, les coordonnées Jira, Teams, Slack et e-mail.
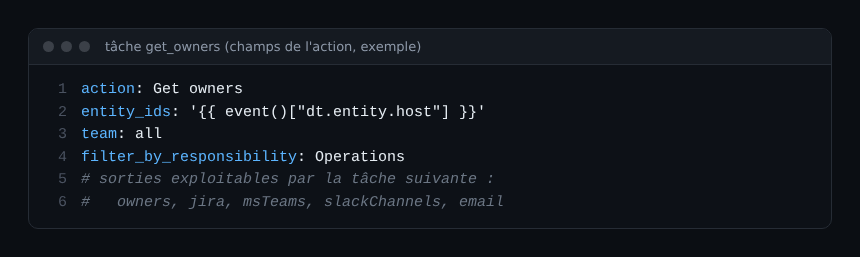
La tâche suivante n’a plus qu’à lire ces sorties pour envoyer le message ou créer le ticket. Filtrer sur la responsabilité Operations évite de réveiller l’équipe sécurité pour une saturation disque. Pour la création de tickets, voyez le workflow Jira et ServiceNow.
L’action devient d’autant plus utile que le bruit est maîtrisé : routez des problèmes, pas des centaines d’alertes brutes. L’article sur la réduction du bruit des alertes Davis prépare ce terrain.
Mesurer la couverture, pas seulement l’installer
Un dispositif d’ownership se dégrade en silence : une équipe est renommée, un service migre, l’étiquette reste. Le billet de l’éditeur propose de visualiser la couverture et les zones sans propriétaire dans un notebook ou un dashboard, avec un exemple de dashboard à adapter. Il note aussi que l’accès DQL aux données d’ownership était en cours de développement : vérifiez son état dans la documentation avant de bâtir une requête dessus.
Un contrôle simple vaut mieux qu’un grand projet : chaque mois, listez les entités critiques sans étiquette et attribuez-les. C’est de la réduction de toil, au sens SRE : on paie une fois pour ne plus chercher à 3 h du matin.
Et le contexte de sécurité ?
Ne confondez pas ownership et contrôle d’accès. L’ownership dit qui prévenir ; l’accès aux données relève des permissions et, côté Grail, d’autres mécanismes décrits dans l’article sur Grail et Classic. Je n’ai pas relu ici la page sur le security context : traitez-le comme un sujet séparé, à lire avant de mélanger les deux. Le tagging des zones de gestion reste couvert dans l’article sur les Management zones.
Bonnes pratiques
- Un seul maître pour les équipes, synchronisé à échéance fixe.
- Des identifiants stables, jamais un nom d’équipe susceptible de changer.
- Un préfixe de clé distinct de vos autres étiquettes.
- Un premier essai sur un seul déploiement, puis un audit mensuel de couverture.
Questions fréquentes
L’ownership Dynatrace fonctionne-t-il sur Managed ?
Une page de documentation Managed décrit l’ownership (mise à jour le 7 novembre 2023, sans numéro de version). La page SaaS ne précise pas la plateforme. Je ne les ai pas comparées fonction par fonction : vérifiez chaque action sur votre version avant de la supposer disponible.
Peut-on changer l’identifiant d’une équipe ?
Non, d’après la page sur l’attribution : l’identifiant est unique et immuable, seul l’identifiant complémentaire se modifie. Prévoyez des identifiants neutres.
Faut-il utiliser dt.owner ou ma propre clé ?
Les deux marchent. Si vous avez déjà une convention (par exemple team.), ajoutez-la comme clé personnalisée plutôt que de retaguer tout le parc, en surveillant l’effet du préfixe.
Conclusion
Commencez par trancher la source de vérité, posez dt.owner sur un déploiement, importez une équipe, puis testez Get owners sur un problème réel. Le billet de l’éditeur, The right person at the right time, et la documentation Ownership donnent le détail officiel.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans la documentation officielle.