
02 h 15, le traitement de nuit démarre, et à 02 h 40 le service de courtiers répond en six secondes. Personne n’est réveillé, aucun seuil statique n’a sauté, mais le matin les clients se plaignent. Voilà le problème que pose la supervision des traitements batch Dynatrace : un batch n’est ni un service ni un hôte, il se contente de manger de la CPU, de la mémoire et des I/O au pire moment. Cet article propose une façon de décider quoi alerter, quoi laisser à Davis et quoi automatiser. L’éditeur décrit un scénario voisin dans son billet en deux parties ; je pars ici de la décision d’exploitation, pas de son plan.
Méthode : j’ai relu le billet et les pages de documentation citées le 11 novembre 2026, mais je n’ai pas rejoué ce scénario sur un environnement. Ce que je n’ai pas pu confirmer est marqué « non vérifié ». Le raisonnement vaut pour Dynatrace SaaS ; je n’ai pas vérifié l’équivalent Managed, donc je ne le promets pas.
Pourquoi les traitements batch Dynatrace échappent aux alertes classiques
Un batch pose trois difficultés. Il est éphémère : le pod existe une heure, puis disparaît. Il est périodique : sa charge est normale à 02 h 15 et anormale à 14 h. Et surtout il est une cause, rarement la victime : c’est le service voisin qui souffre. Une alerte sur la CPU du batch ne dit donc rien ; il faut relier le batch aux symptômes du service touché.
La première question d’exploitation est : que veut-on savoir ? Trois réponses suffisent. Le batch a-t-il échoué ? A-t-il duré anormalement longtemps ? A-t-il dégradé autre chose ? Les deux premières relèvent d’un contrôle périodique, la troisième de Davis. Le billet de l’éditeur illustre le premier volet par un workflow qui lit l’état des jobs toutes les 15 minutes ; le seuil de « trop long » n’y est pas donné, c’est à vous de le fixer.
Donner du contexte à Davis avec un événement de début et de fin
Davis voit les métriques et les traces, pas votre calendrier de traitements. Pour qu’il rapproche un ralentissement d’un batch, annoncez celui-ci par un événement. L’API d’ingestion d’événements (POST /api/v2/events/ingest) exige seulement eventType et title ; l’entitySelector rattache l’événement au service concerné, faute de quoi il se colle à l’environnement. Le jeton d’API a besoin du scope events.ingest.
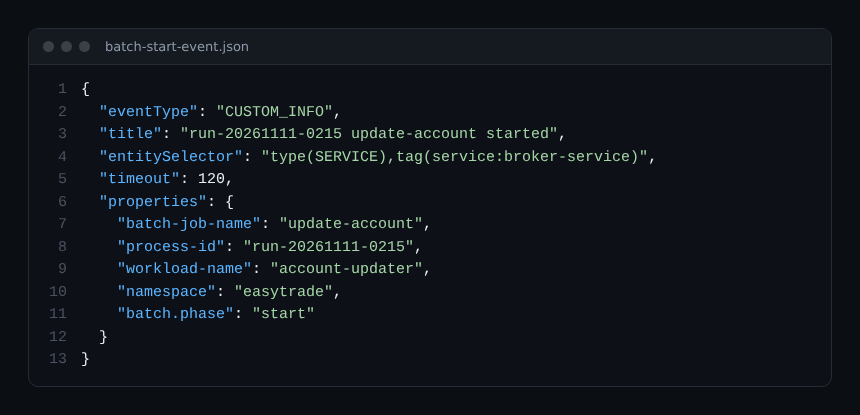
Trois détails comptent dans cette charge utile. Le type CUSTOM_INFO est informatif : il ne déclenche pas de problème par lui-même. Le timeout (en minutes, 15 par défaut, 360 au maximum) borne la durée de vie de l’événement ; réglez-le sur la durée habituelle du batch. Enfin les propriétés non dt.* sont libres, jusqu’à 100 entrées : mettez-y le nom du job, l’identifiant d’exécution, la charge de travail et l’espace de noms. Envoyez un second événement à la fin, avec le même identifiant, pour pouvoir mesurer les durées.
Laisser Davis relier le ralentissement au batch
Une fois l’événement posé, le travail de détection ne vous appartient plus. Dans le scénario de l’éditeur, Davis repère la hausse de latence et d’erreurs du service avant tout ticket, et attribue la cause à un batch qui a saturé CPU, mémoire et I/O du service voisin. Ce que j’en retiens pour l’exploitation : ne réglez pas de seuil sur le batch, réglez la détection sur le service métier et laissez l’événement fournir l’explication. Cela réduit le bruit, thème que traite déjà notre article sur le bruit des alertes Davis.
Limite à connaître : l’événement enrichit le contexte, il ne garantit pas que Davis retiendra le batch comme cause racine. Vérifiez-le sur un incident réel ou un test de charge avant de bâtir une automatisation dessus.
Décider ce qu’un workflow a le droit de faire seul
C’est la décision centrale, et elle précède toute configuration. Un workflow peut démarrer sur un problème Davis, ouvrir un ticket, tester une condition, puis agir. Posez-vous une grille simple :
- Sans risque : ouvrir ou commenter un ticket, prévenir un canal. À automatiser d’emblée ; voyez le workflow Jira et ServiceNow.
- Réversible : suspendre un CronJob, reporter à plus tard. Automatisable si une condition vérifie que le job n’est pas critique pour la clôture comptable.
- Irréversible : supprimer un job en cours, relancer une base. Réservez-le à un humain.
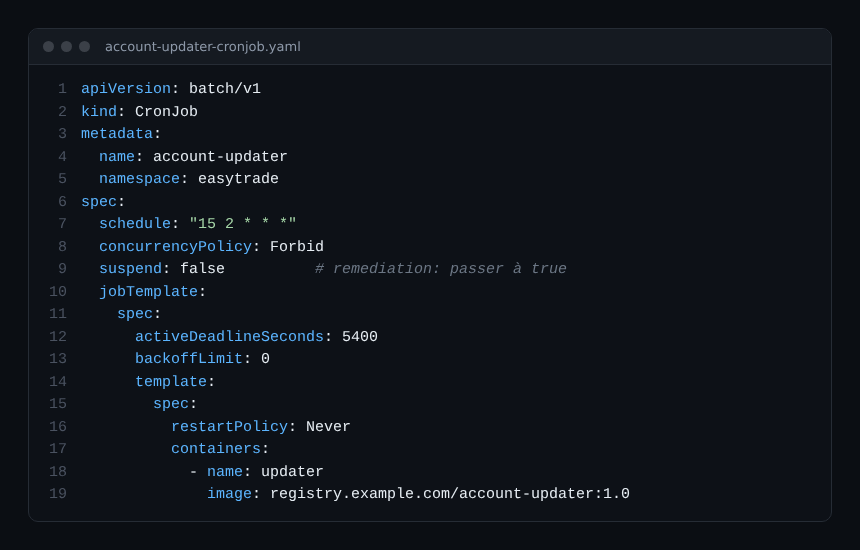
Pour le cas du batch, la suspension d’un CronJob a un avantage : elle ne touche que la prochaine planification. Un job déjà lancé continue, et c’est donc un second geste, à décider, que d’arrêter l’exécution en cours. Dans un manifeste, deux garde-fous existent avant même Dynatrace : concurrencyPolicy: Forbid évite les chevauchements et activeDeadlineSeconds borne la durée.
Atteindre le cluster privé sans ouvrir de port
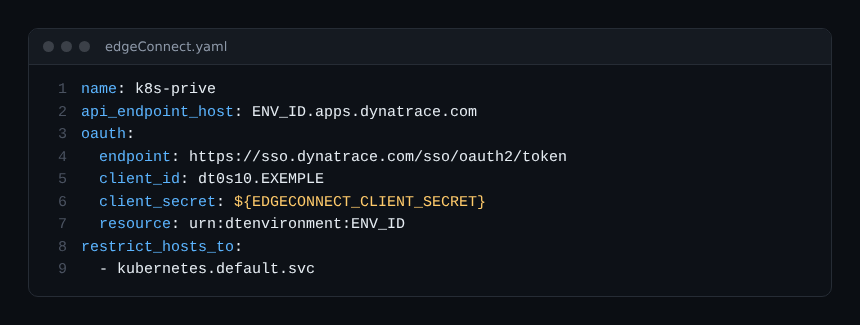
Un workflow tourne côté Dynatrace ; l’API Kubernetes d’un cluster privé, elle, ne doit pas être exposée. EdgeConnect règle ce point : il ouvre une connexion WebSocket sortante vers Dynatrace AppEngine et ne demande aucune connexion entrante. Les requêtes HTTP dont l’hôte correspond à un motif configuré sont alors exécutées dans votre réseau. D’après la documentation, ce motif se déclare dans Settings > General > External Requests > EdgeConnect, pas dans le fichier YAML.
Le compte de service utilisé contre l’API Kubernetes doit avoir le strict minimum : le droit de modifier (patch) les CronJobs d’un seul espace de noms. Je n’ai pas lu la page décrivant l’action exacte qui appelle l’API Kubernetes depuis un workflow : détail non vérifié, à contrôler dans l’éditeur de workflows.
Comment vérifier que ça fonctionne
- Envoyez à la main l’événement de début sur un service de test et contrôlez qu’il apparaît sur sa chronologie. La réponse 201 liste un
statuspar événement : cherchezOK, pasINVALID_ENTITY_TYPE. - Provoquez une charge réelle sur un environnement de préproduction, pas en production.
- Confirmez que le problème Davis cite bien le batch et que le workflow démarre.
- Vérifiez que le champ
suspenddu CronJob passe àtrue, et que le ticket est commenté plutôt que dupliqué. - Rejouez en sens inverse : un problème sans lien avec le batch ne doit déclencher aucune suspension.
Bonnes pratiques
- Un identifiant d’exécution unique par run, présent dans l’événement de début, de fin et dans le ticket.
- Un mode « simulation » : le workflow écrit dans le ticket ce qu’il ferait, pendant les deux premières semaines.
- Une exception explicite pour les batchs de clôture, jamais suspendus automatiquement.
- Les droits Workflows (
automation:workflows:readetadmin) limités à l’équipe plateforme ; pour la prise en main, voyez le module Workflows de la formation SaaS. - Un secret OAuth d’EdgeConnect rangé dans un coffre, jamais dans le dépôt.
Questions fréquentes
Faut-il un événement pour chaque batch ?
Oui si vous voulez que Davis puisse l’expliquer. Sans événement, le ralentissement reste visible mais sa cause n’est pas rattachée au traitement planifié.
Dynatrace peut-il arrêter un job tout seul ?
Il peut déclencher un workflow qui appelle l’API Kubernetes via EdgeConnect, à condition que vous l’ayez construit et autorisé. Rien ne s’arrête sans cette chaîne.
Cela fonctionne-t-il sur Managed ?
Les pages lues décrivent Workflows et EdgeConnect côté SaaS. Je n’ai pas vérifié d’équivalent pour Managed : considérez le scénario comme SaaS uniquement.
Conclusion
Annoncez vos batchs par un événement, surveillez le service métier plutôt que le job, puis n’automatisez que les gestes réversibles. Commencez par la simulation, avant de laisser un workflow suspendre quoi que ce soit en production.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans la documentation officielle.