VoiceStudio clonage voix local : c’est l’idée du dépôt debpalash/VoiceStudio, qui se présente comme une alternative open source et entièrement locale à ElevenLabs. Une application de bureau regroupe clonage de voix, conception de voix à partir d’une description, doublage vidéo, dictée, transcription et livres audio. Le dépôt compte environ 81 000 étoiles en octobre 2026 : un chiffre qui attire, mais qui ne dit rien de l’usage que vous avez le droit d’en faire.
Cet article suit le README et la documentation du projet : ce qu’est l’outil, ce que la licence AGPL-3.0 implique, comment l’installer, ce que montre son interface, comment le superviser quand il tourne sur un serveur GPU, et surtout le cadre à poser avant de cloner la voix de quelqu’un. Pour situer l’outil parmi les piles auto-hébergées, voir notre stack IA open source auto-hébergée.
Précision d’honnêteté : span.observer n’a pas installé ni testé VoiceStudio. Les commandes viennent du README, et les captures ci-dessous viennent du dépôt du projet.
VoiceStudio clonage voix local : qui est derrière, quelle licence
- Auteur et éditeur : le dépôt appartient à
debpalash. Le fichier LICENSE-NOTICE.md indique un copyright « Palash Debnath and VoiceStudio contributors » et précise que les contributions sont licenciées à Yupcha Softwares Private Limited, l’entreprise qui maintient le projet. - Licence : AGPL-3.0 (GNU Affero General Public License v3), avec une offre commerciale payante, « VoiceStudio Pro », pour qui veut l’intégrer dans un produit fermé.
- Chiffres relus le 22 octobre 2026 sur la page du dépôt : environ 81 000 étoiles, environ 8 900 forks, 4 491 commits. La page des releases affichait la v0.5.6 du 23 septembre ; le fichier
package.jsonde la branche principale porte déjà la version 0.5.7. - Moteur par défaut : le README cite k2-fsa/OmniVoice, avec d’autres moteurs au choix et un catalogue décrit dans
docs/feature-catalog.md. Le projet annonce 646 langues. - Application : Electron est la seule application de bureau et l’interface web ; la v0.5.3 est la dernière version Tauri, d’après le README.
Ce que l’AGPL-3.0 implique concrètement
L’AGPL est une licence copyleft. Le projet lui-même résume ce qu’elle change dans LICENSE-NOTICE.md (ce résumé n’a pas de valeur juridique, seul le texte de LICENSE compte).
- Vous pouvez utiliser, copier, modifier et redistribuer le logiciel, y compris pour un usage commercial ou interne.
- Si vous modifiez VoiceStudio et que vous mettez cette version modifiée à disposition d’autres personnes via un réseau, vous devez leur offrir le code source complet de votre version, sous la même licence. C’est la différence avec la GPL classique : exposer un service ne suffit pas à échapper à l’obligation.
- Utiliser l’application telle quelle, pour vous ou votre équipe, n’oblige à publier aucun code.
- Intégrer VoiceStudio dans un produit ou un service propriétaire sans ces obligations demande la licence commerciale du projet.
Deuxième piège : la licence de l’application ne couvre pas les modèles. Le README le dit sans détour : poids de modèles, tokenizers, voix et conditions des sorties générées relèvent de licences séparées, et une licence payante de l’application ne donne pas ces droits. Le projet fournit un inventaire (docs/licensing/model-inventory.md) et affiche des avis de licence par modèle dans le gestionnaire de modèles, en précisant que ces avis ne certifient pas l’usage commercial. Avant toute production, relisez la licence de chaque modèle installé. Ce n’est pas un avis juridique : en cas de doute, consultez un juriste.
Visite de l’interface
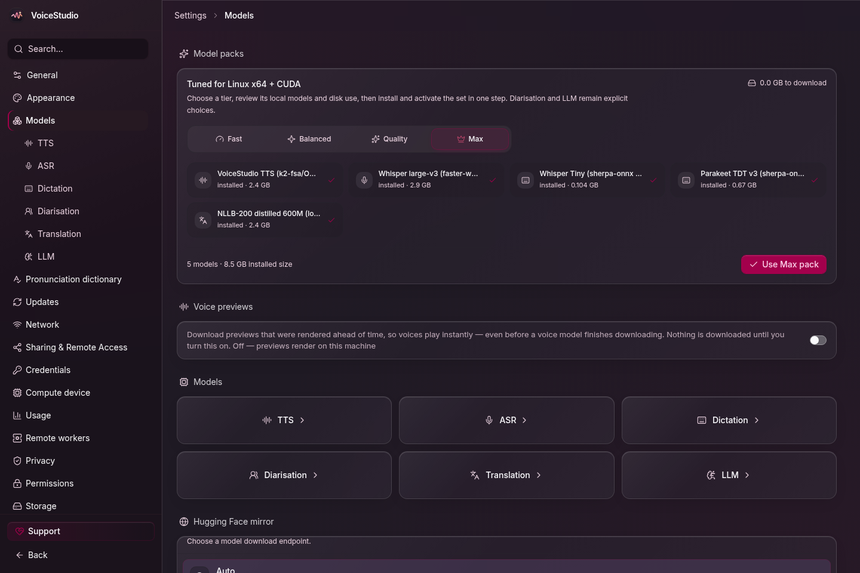
La capture suivante, publiée dans le dépôt, montre la page Settings > Models : des « model packs » (Fast, Balanced, Quality, Max) qui installent d’un coup un jeu de modèles pour la synthèse vocale (TTS), la reconnaissance (ASR), la traduction et la dictée, avec la taille disque de chacun.
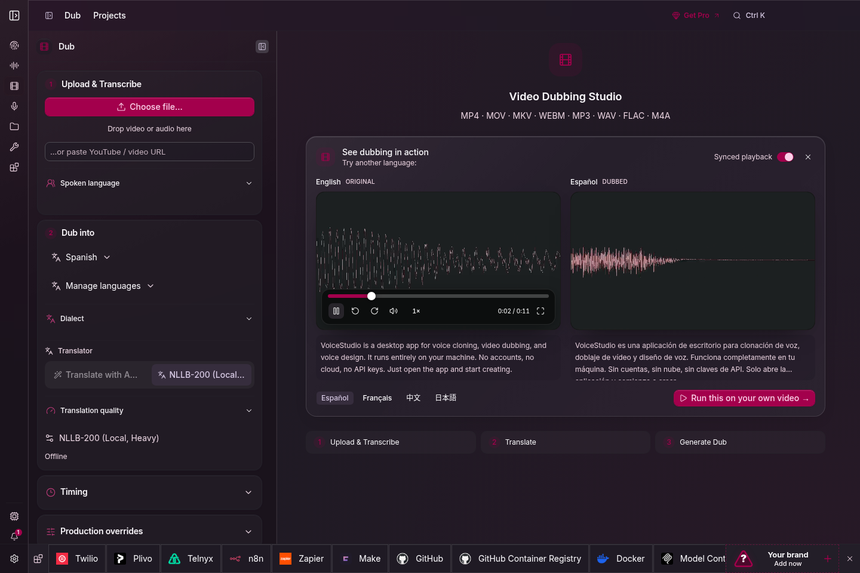
Le doublage vidéo suit un parcours en trois étapes : envoi et transcription, traduction, génération. Le panneau de gauche choisit la langue cible, le traducteur (ici un modèle NLLB-200 local) et le calage temporel.
La conception de voix part d’une description en texte libre (« une conteuse britannique âgée, légèrement rauque ») ou de points de départ prédéfinis, puis s’enregistre comme profil de voix.
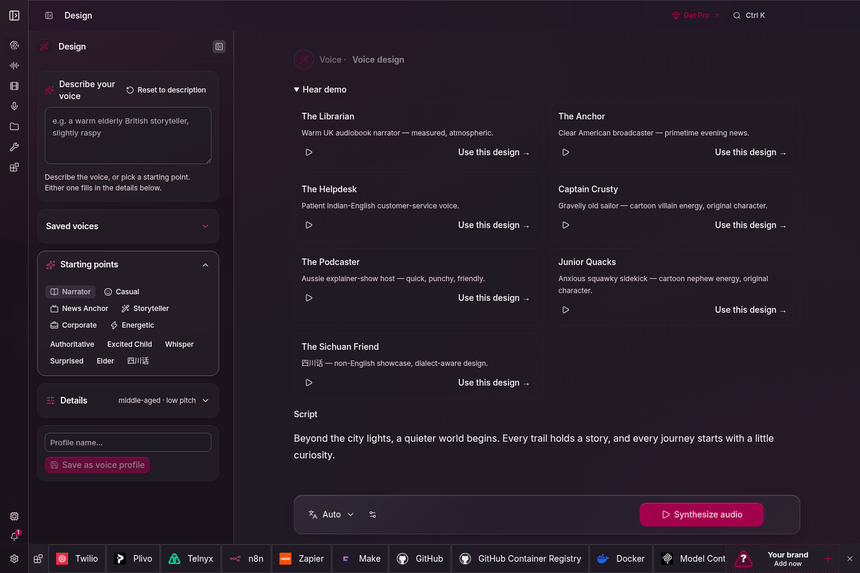
Ces captures montrent aussi, en bas, une barre d’intégrations tierces et un emplacement de sponsor : c’est l’état de l’interface au moment de la capture, pas un choix de span.observer.
Installation d’après le README
Étape 1 — Vérifier le matériel
Le README donne ce tableau de support : GPU NVIDIA sous Windows ou Linux (accélération CUDA), Apple Silicon (Metal, MPS), CPU seul possible mais plus lent (le programme d’installation prend alors la petite version CPU de PyTorch, environ 5 Go d’espace libre), Windows sur ARM expérimental, et Mac Intel limité à l’interface avec un serveur distant.
Étape 2 — Lancer l’installeur
Sous macOS et Linux :
curl -fsSL https://voicestudio.sh/install | shSous Windows, dans PowerShell :
irm https://voicestudio.sh/install | iexPiper un script distant dans un shell est une pratique à risque : le README propose en repli de lancer le script depuis le dépôt (scripts/install.sh) ou de télécharger les paquets des releases (.dmg, .exe, .AppImage, .deb). Lisez le script avant de l’exécuter, ou préférez le paquet signé de la release.
Étape 3 — Ou passer par Docker, pour un serveur
La documentation Docker du dépôt publie l’image ghcr.io/debpalash/voicestudio, en linux/amd64 uniquement. Elle demande une clé d’administration, car le mode serveur protège les réglages et les diagnostics :
export OMNIVOICE_API_KEY="$(python3 -c 'import secrets; print(secrets.token_urlsafe(32))')"
docker pull ghcr.io/debpalash/voicestudio:stable
docker run -d --name omnivoice \
  -p 127.0.0.1:3900:3900 \
  -e OMNIVOICE_API_KEY="$OMNIVOICE_API_KEY" \
  -v omnivoice-data:/app/omnivoice_data \
  ghcr.io/debpalash/voicestudio:stable
Le port est publié sur 127.0.0.1 seulement. La première exécution télécharge environ 2,4 Go de poids de modèle ; suivez-la avec docker logs -f omnivoice. Épinglez le tag :stable ou une version exacte : selon la documentation, :latest est un aperçu mobile de la branche principale.
Cloner une voix : consentement, droits et usages interdits
Le README résume la règle en quatre mots : cloner une voix seulement avec permission. C’est le minimum, pas une garantie juridique.
- Consentement écrit et daté de la personne dont vous clonez la voix, avec la finalité (projet, durée, supports). Conservez-le avec l’échantillon source.
- Droits de la personne : une voix identifiable est liée à la personnalité de son titulaire et peut constituer une donnée personnelle ; selon le pays, son usage commercial exige un accord explicite. Cette lecture est générale et ne remplace pas l’avis d’un juriste.
- Usages à exclure : usurpation d’identité, fausse preuve audio, arnaque téléphonique, désinformation, voix d’une personne décédée ou d’un mineur sans accord de ses ayants droit.
- Ce que le projet prévoit : un filigrane audio invisible (AudioSeal) activable dans Settings > Privacy, et, pour les appels, un champ « Voice ownership » où enregistrer une déclaration de consentement. La feuille de route du dépôt classe en revanche l’enregistrement systématique de la source et du consentement de chaque clonage comme un point encore ouvert.
Mettez ces règles dans votre charte interne avant de déployer l’outil, comme vous le feriez pour un agent à privilèges (voir les garde-fous des agents IA en production).
Limites et points ouverts
- Le projet avance vite : 4 491 commits, une version 0.5.x, des applications mobiles iOS et Android décrites comme préversion dans le CHANGELOG. Fixez une version.
- Les claims de qualité et de langues sont ceux du projet ; vérifiez-les sur vos propres voix. Les pages
docs/benchmarks.mdetdocs/performance.mdsont le point de départ. - Le README prévoit une analyse d’usage activable après consentement (PostHog) ; la documentation Docker permet de la couper avec
-e OMNIVOICE_ANALYTICS_DISABLED=1. - Les poids de modèles viennent de Hugging Face au moment de l’installation : prévoyez bande passante, disque et revue des licences.
Superviser VoiceStudio sur un serveur GPU
Pour une application de bureau, la supervision se limite à ce que l’application expose. Pour un déploiement Docker, plusieurs sources existent, toutes issues de la documentation du dépôt. Elles valent pour Dynatrace SaaS comme pour Dynatrace Managed si vous les collectez via un agent ou un Collector, car l’outil n’est pas un produit Dynatrace.
- Journaux : Settings > Logs affiche les journaux du backend et du frontend, avec recherche, rafraîchissement toutes les trois secondes et copie. Rien n’est envoyé à distance. Sous Docker,
docker logssuffit ; c’est aussi ce que votre agent de collecte lira. - Santé : le superviseur de l’application interroge un contrat
/healthcompact ; l’outil MCPcheck_healthrenvoie l’état du backend et le périphérique GPU actif. - GPU et mémoire : Settings > Performance lit
GET /api/settings/gpu-report(GPU vus par le système, version de PyTorch, verdict par moteur) et affiche l’usage CPU, GPU, RAM et VRAM en direct. Pour un suivi long terme, ajouteznvidia-smiou l’exporteur DCGM côté hôte. - Agents : le backend monte un serveur MCP sur
http://localhost:3900/mcp/avec des outils commegenerate_speech,clone_voice,transcribeetcheck_health. Le répertoire défini parOMNIVOICE_MCP_BASE_PATHest la frontière de sécurité pour les fichiers lus ou écrits ; sans lui, les chemins sont refusés. Traitez ce point d’entrée comme n’importe quel serveur MCP : sécuriser un serveur MCP et observer les agents MCP avec OpenTelemetry.
Le README ne décrit aucun export OpenTelemetry natif. Une durée de génération, une file d’attente ou une consommation VRAM se mesurent donc à l’extérieur : logs du conteneur, métriques de l’hôte, traces côté agent qui appelle generate_speech.
Comment vérifier que ça fonctionne
- Ouvrez l’interface, onglet Voice cloning, choisissez la voix de démonstration fournie et générez une phrase : le README décrit ce parcours.
- Dans Settings > Performance, vérifiez que le GPU est bien utilisé et non le CPU.
- Avec Docker, vérifiez que le port n’est joignable que depuis la machine locale et que la clé d’administration est demandée.
- Appelez
check_healthdepuis votre client MCP.
Bonnes pratiques
- Obtenez et archivez un consentement avant tout clonage ; refusez les demandes sans preuve.
- Gardez le service sur 127.0.0.1 ou derrière un proxy authentifié, avec une clé API longue.
- Épinglez la version de l’image et relisez les licences de chaque modèle.
- Désactivez l’analyse d’usage si votre politique l’exige.
- Exposez les fichiers audio via un répertoire dédié (
OMNIVOICE_MCP_BASE_PATH), jamais la racine du disque.
Questions fréquentes
VoiceStudio est-il gratuit pour une entreprise ?
Selon LICENSE-NOTICE.md, l’usage commercial et interne de l’application est gratuit sous AGPL-3.0. La licence commerciale payante sert à l’intégrer dans un produit fermé. Les modèles ont leurs propres conditions.
Faut-il une carte graphique ?
Non, d’après le README : l’outil reste utilisable sur CPU, plus lentement. Une carte NVIDIA ou une puce Apple Silicon active l’accélération.
Mes enregistrements quittent-ils ma machine ?
Le README indique que les flux locaux tournent sur votre matériel et que les services distants sont optionnels. Les modèles sont téléchargés depuis Hugging Face, et l’analyse d’usage n’est active qu’après consentement.
Conclusion
VoiceStudio mérite l’attention de qui cherche une synthèse et un clonage vocaux auto-hébergés, avec une documentation fournie. Il demande en retour trois décisions : accepter l’AGPL-3.0, vérifier la licence de chaque modèle, et fixer par écrit les règles de consentement avant le premier clonage. Sources : dépôt debpalash/VoiceStudio.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni aux projets cités. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans leur documentation officielle. Cet article n’est pas un avis juridique.