VoiceStudio clonación de voz local: esa es la idea del repositorio debpalash/VoiceStudio, que se presenta como una alternativa de código abierto y totalmente local a ElevenLabs. Una aplicación de escritorio reúne clonación de voz, diseño de voces a partir de una descripción, doblaje de video, dictado, transcripción y audiolibros. El repositorio tiene unas 81 000 estrellas en octubre de 2026: una cifra que llama la atención, pero que no dice nada del uso que tienes derecho a hacer de él.
Este artículo sigue el README y la documentación del proyecto: qué es la herramienta, qué implica la licencia AGPL-3.0, cómo instalarla, qué muestra su interfaz, cómo monitorizarla cuando corre en un servidor con GPU y, sobre todo, el marco que hay que fijar antes de clonar la voz de alguien. Para situar la herramienta entre las pilas autoalojadas, consulta nuestra pila de IA de código abierto autoalojada.
Una precisión de honestidad: span.observer no ha instalado ni probado VoiceStudio. Los comandos proceden del README, y las capturas de abajo proceden del repositorio del proyecto.
VoiceStudio clonación de voz local: quién está detrás y qué licencia tiene
- Autor y editor: el repositorio pertenece a
debpalash. El archivo LICENSE-NOTICE.md indica un copyright «Palash Debnath and VoiceStudio contributors» y precisa que las contribuciones se licencian a Yupcha Softwares Private Limited, la empresa que mantiene el proyecto. - Licencia: AGPL-3.0 (GNU Affero General Public License v3), con una oferta comercial de pago, «VoiceStudio Pro», para quien quiera integrarlo en un producto cerrado.
- Cifras consultadas el 22 de octubre de 2026 en la página del repositorio: unas 81 000 estrellas, unos 8900 forks, 4491 commits. La página de releases mostraba la v0.5.6 del 23 de septiembre; el archivo
package.jsonde la rama principal ya lleva la versión 0.5.7. - Motor por defecto: el README cita k2-fsa/OmniVoice, con otros motores a elegir y un catálogo descrito en
docs/feature-catalog.md. El proyecto anuncia 646 idiomas. - Aplicación: Electron es la única aplicación de escritorio y la interfaz web; la v0.5.3 es la última versión con Tauri, según el README.
Qué implica en la práctica la AGPL-3.0
La AGPL es una licencia copyleft. El propio proyecto resume lo que cambia en LICENSE-NOTICE.md (ese resumen no tiene valor jurídico, solo cuenta el texto de LICENSE).
- Puedes usar, copiar, modificar y redistribuir el software, también para un uso comercial o interno.
- Si modificas VoiceStudio y pones esa versión modificada a disposición de otras personas a través de una red, debes ofrecerles el código fuente completo de tu versión, bajo la misma licencia. Esa es la diferencia con la GPL clásica: exponer un servicio no basta para librarse de la obligación.
- Usar la aplicación tal cual, para ti o tu equipo, no obliga a publicar ningún código.
- Integrar VoiceStudio en un producto o servicio propietario sin esas obligaciones requiere la licencia comercial del proyecto.
Segunda trampa: la licencia de la aplicación no cubre los modelos. El README lo dice sin rodeos: los pesos de los modelos, los tokenizers, las voces y las condiciones de las salidas generadas dependen de licencias distintas, y una licencia de pago de la aplicación no concede esos derechos. El proyecto ofrece un inventario (docs/licensing/model-inventory.md) y muestra avisos de licencia por modelo en el gestor de modelos, precisando que esos avisos no certifican el uso comercial. Antes de cualquier producción, revisa la licencia de cada modelo instalado. Esto no es asesoramiento jurídico: en caso de duda, consulta a un jurista.
Recorrido por la interfaz
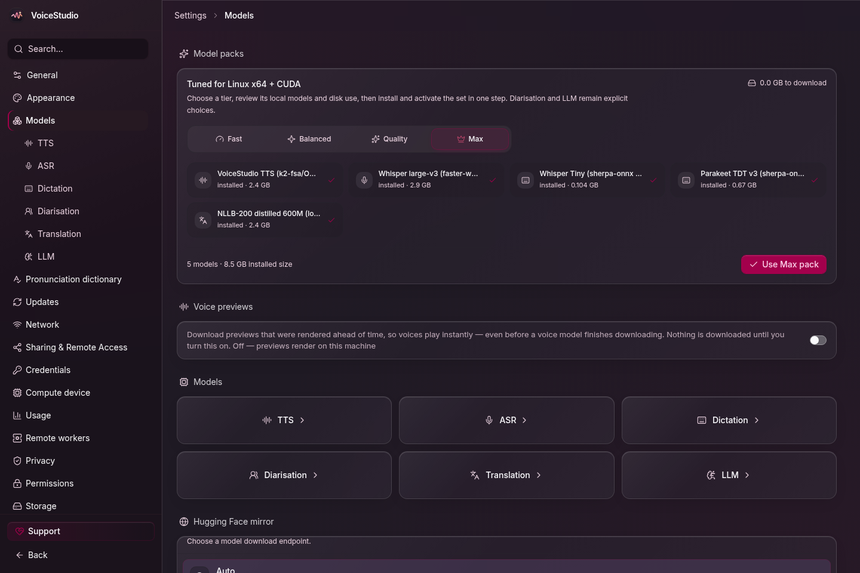
La siguiente captura, publicada en el repositorio, muestra la página Settings > Models: «model packs» (Fast, Balanced, Quality, Max) que instalan de golpe un conjunto de modelos para la síntesis de voz (TTS), el reconocimiento (ASR), la traducción y el dictado, con el tamaño en disco de cada uno.
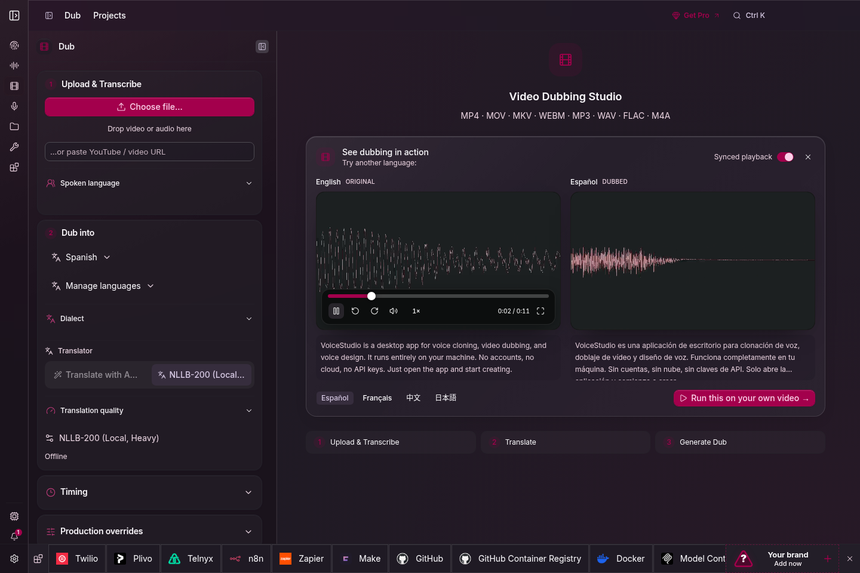
El doblaje de video sigue un recorrido en tres pasos: envío y transcripción, traducción, generación. El panel izquierdo elige el idioma de destino, el traductor (aquí un modelo NLLB-200 local) y el ajuste temporal.
El diseño de voces parte de una descripción en texto libre («una narradora británica mayor, ligeramente ronca») o de puntos de partida predefinidos, y después se guarda como perfil de voz.
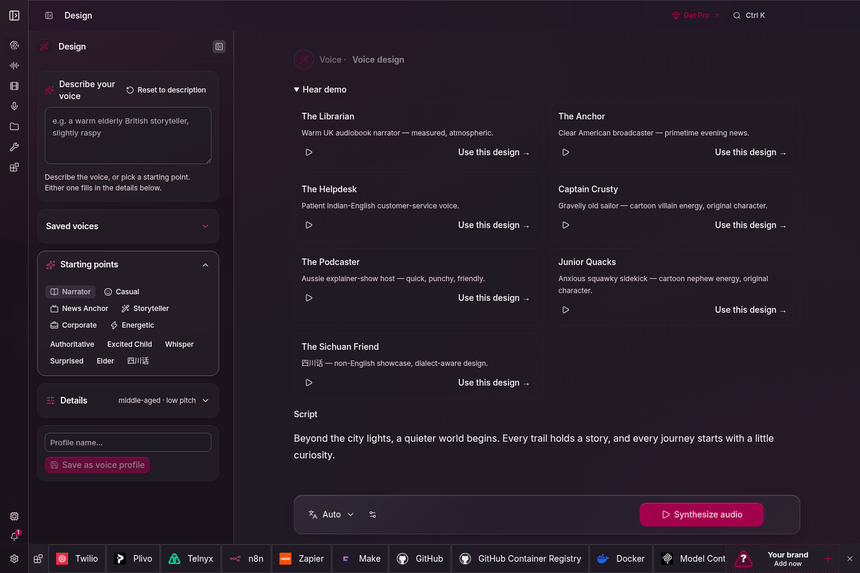
Estas capturas muestran también, abajo, una barra de integraciones de terceros y un espacio de patrocinador: es el estado de la interfaz en el momento de la captura, no una elección de span.observer.
Instalación según el README
Paso 1: comprobar el hardware
El README da esta tabla de soporte: GPU NVIDIA en Windows o Linux (aceleración CUDA), Apple Silicon (Metal, MPS), solo CPU posible pero más lento (el instalador toma entonces la versión pequeña de PyTorch para CPU, con unos 5 GB de espacio libre), Windows en ARM experimental, y Mac Intel limitado a la interfaz con un servidor remoto.
Paso 2: lanzar el instalador
En macOS y Linux:
curl -fsSL https://voicestudio.sh/install | shEn Windows, en PowerShell:
irm https://voicestudio.sh/install | iexPasar un script remoto a un shell es una práctica de riesgo: como alternativa, el README propone lanzar el script desde el repositorio (scripts/install.sh) o descargar los paquetes de las releases (.dmg, .exe, .AppImage, .deb). Lee el script antes de ejecutarlo, o prefiere el paquete firmado de la release.
Paso 3: o usar Docker, para un servidor
La documentación de Docker del repositorio publica la imagen ghcr.io/debpalash/voicestudio, solo en linux/amd64. Pide una clave de administración, porque el modo servidor protege los ajustes y los diagnósticos:
export OMNIVOICE_API_KEY="$(python3 -c 'import secrets; print(secrets.token_urlsafe(32))')"
docker pull ghcr.io/debpalash/voicestudio:stable
docker run -d --name omnivoice \
  -p 127.0.0.1:3900:3900 \
  -e OMNIVOICE_API_KEY="$OMNIVOICE_API_KEY" \
  -v omnivoice-data:/app/omnivoice_data \
  ghcr.io/debpalash/voicestudio:stable
El puerto se publica solo en 127.0.0.1. La primera ejecución descarga unos 2,4 GB de pesos de modelo; síguela con docker logs -f omnivoice. Fija el tag :stable o una versión exacta: según la documentación, :latest es una vista previa móvil de la rama principal.
Clonar una voz: consentimiento, derechos y usos prohibidos
El README resume la regla en pocas palabras: clona una voz solo con permiso. Es el mínimo, no una garantía jurídica.
- Consentimiento escrito y fechado de la persona cuya voz clonas, con la finalidad (proyecto, duración, soportes). Consérvalo junto con la muestra de origen.
- Derechos de la persona: una voz identificable está ligada a la personalidad de su titular y puede constituir un dato personal; según el país, su uso comercial exige un acuerdo explícito. Esta lectura es general y no sustituye el asesoramiento de un jurista.
- Usos que hay que excluir: suplantación de identidad, falsa prueba de audio, estafa telefónica, desinformación, voz de una persona fallecida o de un menor sin acuerdo de sus derechohabientes.
- Lo que prevé el proyecto: una marca de agua de audio invisible (AudioSeal) que se activa en Settings > Privacy y, para las llamadas, un campo «Voice ownership» donde registrar una declaración de consentimiento. En cambio, la hoja de ruta del repositorio clasifica el registro sistemático del origen y del consentimiento de cada clonación como un punto todavía abierto.
Incluye estas reglas en tu política interna antes de desplegar la herramienta, como harías con un agente con privilegios (consulta las barreras de seguridad de los agentes de IA en producción).
Límites y puntos abiertos
- El proyecto avanza rápido: 4491 commits, una versión 0.5.x, aplicaciones móviles iOS y Android descritas como versión preliminar en el CHANGELOG. Fija una versión.
- Las afirmaciones de calidad y de idiomas son las del proyecto; compruébalas con tus propias voces. Las páginas
docs/benchmarks.mdydocs/performance.mdson el punto de partida. - El README prevé un análisis de uso que se activa tras el consentimiento (PostHog); la documentación de Docker permite desactivarlo con
-e OMNIVOICE_ANALYTICS_DISABLED=1. - Los pesos de los modelos vienen de Hugging Face en el momento de la instalación: prevé ancho de banda, disco y revisión de licencias.
Monitorizar VoiceStudio en un servidor con GPU
Para una aplicación de escritorio, la monitorización se limita a lo que expone la aplicación. Para un despliegue con Docker existen varias fuentes, todas procedentes de la documentación del repositorio. Valen tanto para Dynatrace SaaS como para Dynatrace Managed si las recoges mediante un agente o un Collector, porque la herramienta no es un producto de Dynatrace.
- Logs: Settings > Logs muestra los logs del backend y del frontend, con búsqueda, actualización cada tres segundos y copia. No se envía nada a distancia. Con Docker, basta
docker logs; es también lo que leerá tu agente de recogida. - Salud: el supervisor de la aplicación consulta un contrato
/healthcompacto; la herramienta MCPcheck_healthdevuelve el estado del backend y el dispositivo GPU activo. - GPU y memoria: Settings > Performance lee
GET /api/settings/gpu-report(GPU vistas por el sistema, versión de PyTorch, veredicto por motor) y muestra el uso de CPU, GPU, RAM y VRAM en directo. Para un seguimiento a largo plazo, añadenvidia-smio el exportador DCGM en el host. - Agentes: el backend monta un servidor MCP en
http://localhost:3900/mcp/con herramientas comogenerate_speech,clone_voice,transcribeycheck_health. El directorio definido porOMNIVOICE_MCP_BASE_PATHes la frontera de seguridad para los archivos leídos o escritos; sin él, se rechazan las rutas. Trata este punto de entrada como cualquier servidor MCP: proteger un servidor MCP y observar agentes MCP con OpenTelemetry.
El README no describe ninguna exportación nativa de OpenTelemetry. Una duración de generación, una cola de espera o un consumo de VRAM se miden, pues, desde fuera: logs del contenedor, métricas del host, trazas del lado del agente que llama a generate_speech.
Cómo comprobar que funciona
- Abre la interfaz, pestaña Voice cloning, elige la voz de demostración incluida y genera una frase: el README describe ese recorrido.
- En Settings > Performance, comprueba que se usa la GPU y no la CPU.
- Con Docker, comprueba que el puerto solo es accesible desde la máquina local y que se pide la clave de administración.
- Llama a
check_healthdesde tu cliente MCP.
Buenas prácticas
- Obtén y archiva un consentimiento antes de cualquier clonación; rechaza las peticiones sin prueba.
- Mantén el servicio en 127.0.0.1 o detrás de un proxy autenticado, con una clave de API larga.
- Fija la versión de la imagen y revisa las licencias de cada modelo.
- Desactiva el análisis de uso si tu política lo exige.
- Expón los archivos de audio mediante un directorio dedicado (
OMNIVOICE_MCP_BASE_PATH), nunca la raíz del disco.
Preguntas frecuentes
¿VoiceStudio es gratuito para una empresa?
Según LICENSE-NOTICE.md, el uso comercial e interno de la aplicación es gratuito bajo AGPL-3.0. La licencia comercial de pago sirve para integrarla en un producto cerrado. Los modelos tienen sus propias condiciones.
¿Hace falta una tarjeta gráfica?
No, según el README: la herramienta se puede usar en CPU, más lentamente. Una tarjeta NVIDIA o un chip Apple Silicon activa la aceleración.
¿Mis grabaciones salen de mi máquina?
El README indica que los flujos locales corren en tu hardware y que los servicios remotos son opcionales. Los modelos se descargan desde Hugging Face, y el análisis de uso solo se activa tras el consentimiento.
Conclusión
VoiceStudio merece atención si buscas síntesis y clonación de voz autoalojadas, con una documentación abundante. A cambio, exige tres decisiones: aceptar la AGPL-3.0, comprobar la licencia de cada modelo y fijar por escrito las reglas de consentimiento antes de la primera clonación. Fuentes: repositorio debpalash/VoiceStudio.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a los proyectos citados. Las marcas citadas pertenecen a sus propietarios. Las herramientas evolucionan rápido: comprueba los comandos y las opciones en su documentación oficial. Este artículo no es asesoramiento jurídico.