الوحدة 3 من مسار مقاييس Dynatrace Managed عن مقاييس الخدمات: 20 مقياس خدمة من نوع builtin (مفاتيح builtin:service.*) لمتابعة الحركة وزمن الاستجابة والأخطاء والطلبات الرئيسية والاستدعاءات إلى قواعد البيانات، مع استعلام metric selector لكل بطاقة.
المسار: تدريب مقاييس Dynatrace Managed · الوحدة 3/7 · المجال: الخدمات والطلبات وقواعد البيانات · المنصة: Dynatrace Managed (Metrics API v2 وmetric selector)
لا يرى المستخدمون مضيفًا، بل يرون خدمة تستجيب ببطء أو بخطأ. لذلك تحمل مقاييس الخدمة الإشارات الذهبية: الحركة وزمن الاستجابة والأخطاء، وجزءًا من التشبع عبر الأزمنة المنفقة في قاعدة البيانات أو في الانتظار. وهي التي تغذي معظم أهداف SLO.
غطّت الوحدة 2 المضيفين؛ وتصعد هذه الوحدة طبقة. وتتبع البطاقات كلها الخطة نفسها: القياس والاستخدام والفخ والاستعلام.
المحتوى صالح لـDynatrace Managed وللمقاييس الكلاسيكية في Dynatrace SaaS. أما في Grail فتصبح المفاتيح dt.service.* وتُستعلم بـDQL.
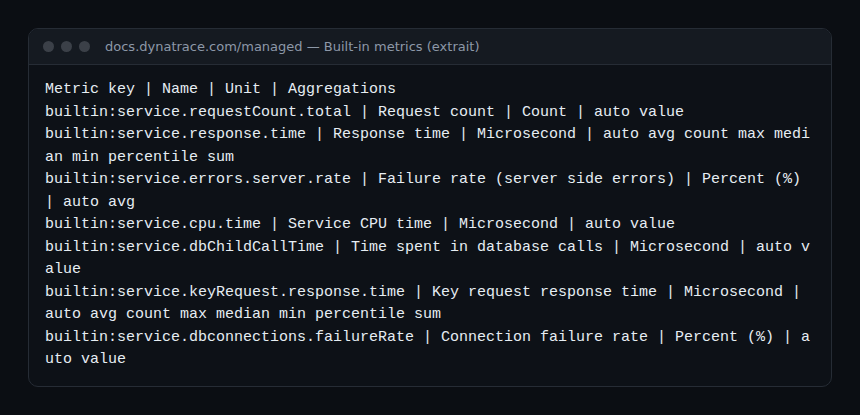
مقاييس الخدمات: الجدول الموجز
المصدر: صفحة Built-in metrics في وثائق Managed. البعد الرئيسي هو dt.entity.service؛ وتُقسَّم مقاييس keyRequest بحسب الطلب الرئيسي (dt.entity.service_method). نقطة انتباه: الأزمنة بـالميكروثانية.
| المفتاح | الوحدة | التجميعات | ما يقيسه |
|---|---|---|---|
builtin:service.requestCount.total |
Count | value | الطلبات المستلمة |
builtin:service.requestCount.server |
Count | value | الطلبات المقيسة من جهة الخادم |
builtin:service.response.time |
ميكروثانية | avg, count, max, median, min, percentile, sum | زمن الاستجابة |
builtin:service.response.server |
ميكروثانية | avg, count, max, median, min, percentile, sum | زمن الاستجابة من جهة الخادم |
builtin:service.errors.total.count |
Count | value | الطلبات الفاشلة (كلها) |
builtin:service.errors.total.rate |
% | avg | معدل الفشل (كله) |
builtin:service.errors.server.count |
Count | value | حالات الفشل من جهة الخادم |
builtin:service.errors.server.rate |
% | avg | معدل الفشل من جهة الخادم |
builtin:service.errors.fivexx.count |
Count | value | استجابات HTTP من الفئة 5xx |
builtin:service.errors.fourxx.count |
Count | value | استجابات HTTP من الفئة 4xx |
builtin:service.successes.server.rate |
% | avg | معدل النجاح من جهة الخادم |
builtin:service.cpu.time |
ميكروثانية | value | المعالج الذي تستهلكه الخدمة |
builtin:service.cpu.perRequest |
ميكروثانية | avg, count, max, min, sum | المعالج لكل طلب |
builtin:service.dbChildCallCount |
Count | value | الاستدعاءات إلى قواعد البيانات |
builtin:service.dbChildCallTime |
ميكروثانية | value | الزمن المنفق في قاعدة البيانات |
builtin:service.nonDbChildCallCount |
Count | value | الاستدعاءات إلى خدمات أخرى |
builtin:service.dbconnections.failureRate |
% | value | فشل الاتصال بقاعدة البيانات |
builtin:service.keyRequest.response.time |
ميكروثانية | avg, count, max, median, min, percentile, sum | زمن استجابة طلب رئيسي |
builtin:service.keyRequest.count.total |
Count | value | حجم طلب رئيسي |
builtin:service.keyRequest.errors.server.rate |
% | avg | معدل فشل طلب رئيسي |
الحركة وزمن الاستجابة: مقاييس الخدمة builtin الأساسية
builtin:service.requestCount.total
عدد الطلبات التي تستلمها الخدمة؛ وتوضح الوثائق أنه يقبل تقسيمات الخدمة (splittings). وهو إشارة الحركة. وانخفاض مفاجئ يستحق من الانتباه ما تستحقه زيادة الأخطاء: فهو يكشف غالبًا مشكلة في المنبع.
builtin:service.requestCount.total:splitBy("dt.entity.service"):sort(value(sum,descending)):limit(10)builtin:service.requestCount.server
العدّ نفسه، مقيسًا من جهة الخادم فقط. ويفيد مقامًا متسقًا عند حساب معدل انطلاقًا من أخطاء جهة الخادم.
builtin:service.requestCount.server:splitBy("dt.entity.service")builtin:service.response.time
الزمن الذي تستغرقه الخدمة لإعادة استجابتها، بالميكروثانية. فضّل المئين (percentile) على المتوسط: فالمئين 90 يصف تجربة الأغلبية دون أن تسحقه قلة من الطلبات السريعة جدًا. اقسم على 1 000 لقراءة المللي ثانية.
builtin:service.response.time:splitBy("dt.entity.service"):percentile(90):sort(value(max,descending)):limit(10)builtin:service.response.server
زمن الاستجابة من جهة الخادم، دون الجزء المقيس من جهة العميل المستدعي. والفارق بينهما يكشف زمن شبكة أو زمن انتظار عند المستدعي.
builtin:service.response.server:splitBy("dt.entity.service"):medianالأخطاء والنجاحات
builtin:service.errors.total.count
الطلبات الفاشلة، مقيسة من جهة الخادم أو العميل. وما يُعدّ فشلًا يتوقف على إعداد كشف الإخفاقات للخدمة: تحقق من هذا الإعداد قبل أن تبني عليه هدف SLO.
builtin:service.errors.total.count:splitBy("dt.entity.service"):sort(value(sum,descending)):limit(10)builtin:service.errors.total.rate
معدل الفشل بكل أنواع الأخطاء، بالنسبة المئوية، وتجميعه الوحيد avg. مناسب للوحة المعلومات؛ أما لهدف SLO فاحسب النسبة بنفسك لتتحكم في المقام.
builtin:service.errors.total.rate:splitBy("dt.entity.service"):avgbuiltin:service.errors.server.count
حالات الفشل المقيسة من جهة الخادم. وهو العدّاد الأولى باستخدامه في مؤشر موثوقية الخدمة نفسها، بمعزل عن عملائها.
builtin:service.errors.server.count:splitBy("dt.entity.service")builtin:service.errors.server.rate
معدل الفشل من جهة الخادم. وارتفاعه المفاجئ بعد نشر إصدار هو حالة الاستخدام النموذجية لحدث مقياس أو تنبيه burn rate.
builtin:service.errors.server.rate:splitBy("dt.entity.service"):avg:sort(value(avg,descending)):limit(10)builtin:service.errors.fivexx.count
استجابات HTTP التي يقع رمزها بين 500 و599. وتدل على إخفاق في الخدمة أو في إحدى تبعياتها.
builtin:service.errors.fivexx.count:splitBy("dt.entity.service")builtin:service.errors.fourxx.count
استجابات HTTP من الفئة 4xx. فخ كلاسيكي: ذروة من 404 أو 401 تأتي غالبًا من عميل مضبوط خطأً لا من الخدمة. فلا تدرجها كما هي في ميزانية الأخطاء.
builtin:service.errors.fourxx.count:splitBy("dt.entity.service")builtin:service.successes.server.rate
معدل النجاح من جهة الخادم، بالنسبة المئوية. وهو أبسط صيغة لمؤشر SLI للتوافر؛ ويبيّن مقال أهداف SLO في Dynatrace Managed كيفية استخدامه.
builtin:service.successes.server.rate:splitBy("dt.entity.service"):avgالاستهلاك والتبعيات
builtin:service.cpu.time
زمن المعالج الذي تستهلكه الخدمة، بالميكروثانية. وهو يتيح ربط ارتفاع المعالج على المضيف بخدمة بعينها، ومقارنة إصدارين من الشيفرة نفسها.
builtin:service.cpu.time:splitBy("dt.entity.service"):sort(value(sum,descending)):limit(10)builtin:service.cpu.perRequest
المعالج المستهلك لكل طلب. وعلى خلاف الإجمالي لا يرتفع مع الحركة: فارتفاعه يدل على طلب صار أكثر كلفة، وغالبًا بعد تغيير في الشيفرة.
builtin:service.cpu.perRequest:splitBy("dt.entity.service"):avgbuiltin:service.dbChildCallCount
عدد الاستدعاءات إلى قواعد البيانات التي تجريها الخدمة. ونسبة استدعاءات/طلبات تنفجر تكشف نمط N+1 الشائع مع أدوات ORM.
builtin:service.dbChildCallCount:splitBy("dt.entity.service") / builtin:service.requestCount.total:splitBy("dt.entity.service")builtin:service.dbChildCallTime
الزمن المنفق في الاستدعاءات إلى قواعد البيانات، بالميكروثانية. وبمقارنته بزمن الاستجابة نعرف هل البطء من قاعدة البيانات أم من شيفرة الخدمة.
builtin:service.dbChildCallTime:splitBy("dt.entity.service")builtin:service.nonDbChildCallCount
عدد الاستدعاءات إلى خدمات أخرى؛ ويعطي nonDbChildCallTime الزمن المقابل. وارتفاع هذا الزمن يوجّه التحليل نحو تبعية في المصب. وفي العائلة نفسها تفصّل المقاييس builtin:service.ioTime وlockTime وwaitTime (بالميكروثانية) أزمنة الإدخال والإخراج والقفل والانتظار.
builtin:service.nonDbChildCallCount:splitBy("dt.entity.service")builtin:service.dbconnections.failureRate
معدل محاولات الاتصال بقاعدة بيانات التي تفشل، منسوبًا إلى كل المحاولات. ويظهر فيه تجمّع اتصالات مشبع أو قاعدة بيانات لا يمكن بلوغها قبل ظهور أخطاء التطبيق.
builtin:service.dbconnections.failureRate:splitBy("dt.entity.service")الطلبات الرئيسية
الطلب الرئيسي (key request) نقطة دخول تعلّمها على أنها حرجة (الدفع أو تسجيل الدخول). وتكتب Dynatrace حينئذ مقاييس مخصصة لكل منها.
builtin:service.keyRequest.response.time
زمن استجابة طلب رئيسي، بالميكروثانية. وهو المستوى المناسب من التفصيل لهدف SLO لزمن الاستجابة على مسار عمل: فلا تخفف الطلبات الثانوية الإشارة.
builtin:service.keyRequest.response.time:splitBy("dt.entity.service_method"):percentile(95)builtin:service.keyRequest.count.total
عدد الطلبات الخاص بطلب رئيسي. ويصلح مقامًا لأهداف SLO وإشارة تجارية: فانخفاض حجم المدفوعات يظهر هنا.
builtin:service.keyRequest.count.total:splitBy("dt.entity.service_method")builtin:service.keyRequest.errors.server.rate
معدل الفشل من جهة الخادم لطلب رئيسي. وبالاقتران مع زمن الاستجابة يغطي مؤشري SLI الأكثر استخدامًا على نقطة دخول حرجة.
builtin:service.keyRequest.errors.server.rate:splitBy("dt.entity.service_method"):avgكيف تتحقق من أن الأمر يعمل
- اسرد مفاتيح الخدمات المتاحة:
curl -s "$DT_URL/api/v2/metrics?metricSelector=builtin:service.*&fields=unit,aggregationTypes" \ -H "Authorization: Api-Token $DT_TOKEN" - استعلم عن استعلام من الوحدة:
curl -s -G "$DT_URL/api/v2/metrics/query" \ --data-urlencode 'metricSelector=builtin:service.response.time:splitBy("dt.entity.service"):percentile(90)' \ --data-urlencode 'from=now-2h' \ -H "Authorization: Api-Token $DT_TOKEN" - قارن قيمة برسم صفحة الخدمة: بالقسمة على 1 000 يجب أن تطابق الميكروثانية المللي ثانية المعروضة.
لا تعيد مقاييس keyRequest شيئًا ما دام لا يوجد طلب معلَّم على أنه رئيسي. والصياغة الكاملة لـmetric selector مفصلة في وحدة metric selector وAPI.
أفضل الممارسات
- اقرأ الأزمنة بالميكروثانية، وحوّلها قبل مقارنتها بهدف بالمللي ثانية.
- استخدم المئين لزمن الاستجابة، ونسبة النجاح إلى الإجمالي للتوافر.
- افصل 4xx عن 5xx: فالثانية وحدها تعكس عادة موثوقية الخدمة.
- علّم مساراتك الحرجة طلبات رئيسية لتحصل على مقاييس بالتفصيل المناسب.
الأسئلة الشائعة
ما الفرق بين errors.total وerrors.server؟
الأول يعد حالات الفشل المقيسة من جهة الخادم أو العميل، والثاني من جهة الخادم فقط. وللحكم على الخدمة نفسها ابدأ من جهة الخادم.
أين قواعد البيانات في هذه الوحدة؟
مرئية من الخدمة المستدعية: الاستدعاءات والأزمنة وفشل الاتصال. أما المقاييس الداخلية لمحرك قاعدة البيانات فتعود إلى الإضافات (الوحدة 6).
هل توجد هذه المفاتيح في Grail؟
توجد مقابلات dt.service.* في Dynatrace SaaS مع Grail، بأسماء ووحدات تختلف أحيانًا؛ ويتناولها مسار مقاييس SaaS.
مع المضيفين والخدمات تمسك بطبقتي جهة الخادم. وتنتقل الوحدة التالية إلى جهة المستخدمين: تطبيقات الويب والجوال وApdex والمراقبات الاصطناعية.
→ الوحدة 2: المضيفون · فهرس المسار · الوحدة 4: التطبيقات ←
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC. المفاتيح والوحدات المذكورة مأخوذة من الوثائق الرسمية لـDynatrace Managed؛ تحقق منها في إصدار عنقودك.