Módulo 3 del curso de métricas de Dynatrace Managed: 20 métricas de servicio builtin (claves builtin:service.*) para seguir el tráfico, la latencia, los errores, las key requests y las llamadas a bases de datos, con una consulta de metric selector por ficha.
Curso: Formación en métricas de Dynatrace Managed · Módulo 3/7 · Dominio: servicios, peticiones, bases de datos · Plataforma: Dynatrace Managed (Metrics API v2, metric selector)
Los usuarios no ven un host, ven un servicio que responde despacio o con errores. Las métricas de servicio llevan, por tanto, las señales de oro: tráfico, latencia, errores y una parte de la saturación a través de los tiempos pasados en la base de datos o en espera. Son ellas las que alimentan la mayoría de los SLO.
El módulo 2 cubrió los hosts; este módulo sube un escalón. Todas las fichas siguen el mismo esquema: medida, uso, trampa, consulta.
El contenido vale para Dynatrace Managed y para las métricas clásicas de Dynatrace SaaS. En Grail, las claves pasan a ser dt.service.* y se consultan con DQL.
Servicios: la tabla resumen
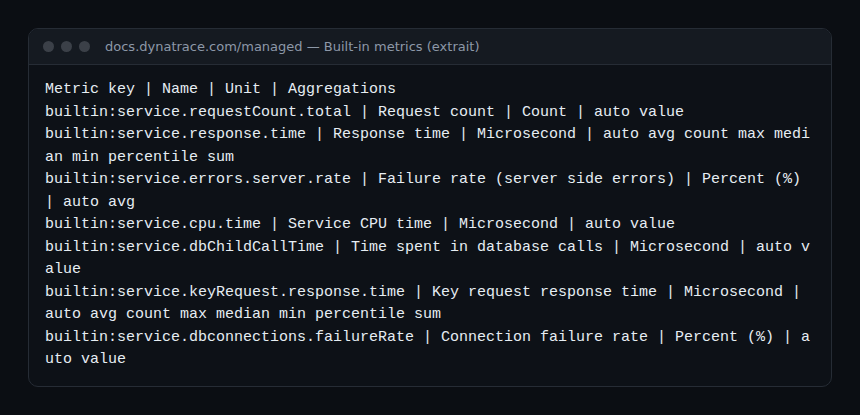
Fuente: página Built-in metrics de la documentación de Managed. La dimensión principal es dt.entity.service; las métricas keyRequest se desglosan por key request (dt.entity.service_method). Punto de atención: los tiempos están en microsegundos.
| Clave | Unidad | Agregaciones | Qué mide |
|---|---|---|---|
builtin:service.requestCount.total |
Count | value | Peticiones recibidas |
builtin:service.requestCount.server |
Count | value | Peticiones medidas en el servidor |
builtin:service.response.time |
Microsegundo | avg, count, max, median, min, percentile, sum | Tiempo de respuesta |
builtin:service.response.server |
Microsegundo | avg, count, max, median, min, percentile, sum | Tiempo de respuesta en el servidor |
builtin:service.errors.total.count |
Count | value | Peticiones fallidas (todas) |
builtin:service.errors.total.rate |
% | avg | Tasa de fallos (todos) |
builtin:service.errors.server.count |
Count | value | Fallos en el servidor |
builtin:service.errors.server.rate |
% | avg | Tasa de fallos en el servidor |
builtin:service.errors.fivexx.count |
Count | value | Respuestas HTTP 5xx |
builtin:service.errors.fourxx.count |
Count | value | Respuestas HTTP 4xx |
builtin:service.successes.server.rate |
% | avg | Tasa de éxito en el servidor |
builtin:service.cpu.time |
Microsegundo | value | CPU consumida por el servicio |
builtin:service.cpu.perRequest |
Microsegundo | avg, count, max, min, sum | CPU por petición |
builtin:service.dbChildCallCount |
Count | value | Llamadas a bases de datos |
builtin:service.dbChildCallTime |
Microsegundo | value | Tiempo pasado en la base de datos |
builtin:service.nonDbChildCallCount |
Count | value | Llamadas a otros servicios |
builtin:service.dbconnections.failureRate |
% | value | Fallos de conexión a la base de datos |
builtin:service.keyRequest.response.time |
Microsegundo | avg, count, max, median, min, percentile, sum | Tiempo de respuesta de una key request |
builtin:service.keyRequest.count.total |
Count | value | Volumen de una key request |
builtin:service.keyRequest.errors.server.rate |
% | avg | Tasa de fallos de una key request |
Tráfico y latencia: las métricas de servicio builtin de base
builtin:service.requestCount.total
El número de peticiones recibidas por el servicio; la documentación precisa que acepta los desgloses de servicio (splittings). Es la señal de tráfico. Una caída brusca merece tanta atención como un aumento de errores: a menudo delata un problema aguas arriba.
builtin:service.requestCount.total:splitBy("dt.entity.service"):sort(value(sum,descending)):limit(10)builtin:service.requestCount.server
El mismo recuento, medido solo en el servidor. Sirve de denominador coherente al calcular una tasa a partir de los errores del lado servidor.
builtin:service.requestCount.server:splitBy("dt.entity.service")builtin:service.response.time
El tiempo que tarda el servicio en devolver su respuesta, en microsegundos. Prefiere un percentil a la media: un p90 describe la experiencia de la mayoría sin quedar aplastado por unas pocas peticiones muy rápidas. Divide entre 1 000 para leer milisegundos.
builtin:service.response.time:splitBy("dt.entity.service"):percentile(90):sort(value(max,descending)):limit(10)builtin:service.response.server
El tiempo de respuesta en el servidor, sin la parte medida en el cliente que llama. La diferencia entre ambos revela un tiempo de red o de cola en el llamante.
builtin:service.response.server:splitBy("dt.entity.service"):medianErrores y éxitos
builtin:service.errors.total.count
Las peticiones fallidas, medidas en el servidor o en el cliente. Lo que cuenta como fallo depende de la detección de fallos configurada para el servicio: verifica ese ajuste antes de construir un SLO sobre ella.
builtin:service.errors.total.count:splitBy("dt.entity.service"):sort(value(sum,descending)):limit(10)builtin:service.errors.total.rate
La tasa de fallos con todos los errores juntos, en porcentaje, con la única agregación avg. Práctica para un dashboard; para un SLO, calcula mejor el ratio tú mismo para controlar el denominador.
builtin:service.errors.total.rate:splitBy("dt.entity.service"):avgbuiltin:service.errors.server.count
Los fallos medidos en el servidor. Es el contador que conviene priorizar para un indicador de fiabilidad del propio servicio, independientemente de sus clientes.
builtin:service.errors.server.count:splitBy("dt.entity.service")builtin:service.errors.server.rate
La tasa de fallos en el servidor. Un aumento repentino tras un despliegue es el caso de uso típico de un evento de métrica o de una alerta de burn rate.
builtin:service.errors.server.rate:splitBy("dt.entity.service"):avg:sort(value(avg,descending)):limit(10)builtin:service.errors.fivexx.count
Las respuestas HTTP cuyo código está entre 500 y 599. Señalan un fallo del servicio o de una de sus dependencias.
builtin:service.errors.fivexx.count:splitBy("dt.entity.service")builtin:service.errors.fourxx.count
Las respuestas HTTP 4xx. Trampa clásica: un pico de 404 o de 401 suele venir de un cliente mal configurado, no del servicio. No lo integres tal cual en un presupuesto de error.
builtin:service.errors.fourxx.count:splitBy("dt.entity.service")builtin:service.successes.server.rate
La tasa de éxito en el servidor, en porcentaje. Es la forma más directa de un SLI de disponibilidad; el artículo sobre los SLO en Dynatrace Managed muestra cómo usarla.
builtin:service.successes.server.rate:splitBy("dt.entity.service"):avgConsumo y dependencias
builtin:service.cpu.time
El tiempo de CPU consumido por el servicio, en microsegundos. Permite relacionar un aumento de CPU en el host con un servicio concreto y comparar dos versiones de un mismo código.
builtin:service.cpu.time:splitBy("dt.entity.service"):sort(value(sum,descending)):limit(10)builtin:service.cpu.perRequest
La CPU consumida por petición. A diferencia del total, no sube con el tráfico: un aumento señala una petición que se ha vuelto más costosa, a menudo tras un cambio de código.
builtin:service.cpu.perRequest:splitBy("dt.entity.service"):avgbuiltin:service.dbChildCallCount
El número de llamadas a bases de datos que hace el servicio. Un ratio llamadas/petición que se dispara delata el patrón N+1, frecuente con los ORM.
builtin:service.dbChildCallCount:splitBy("dt.entity.service") / builtin:service.requestCount.total:splitBy("dt.entity.service")builtin:service.dbChildCallTime
El tiempo pasado en las llamadas a bases de datos, en microsegundos. Comparado con el tiempo de respuesta, dice si la lentitud viene de la base de datos o del código del servicio.
builtin:service.dbChildCallTime:splitBy("dt.entity.service")builtin:service.nonDbChildCallCount
El número de llamadas a otros servicios; nonDbChildCallTime da el tiempo correspondiente. Un aumento de ese tiempo orienta el análisis hacia una dependencia aguas abajo. En la misma familia, builtin:service.ioTime, lockTime y waitTime (microsegundos) detallan los tiempos de entrada/salida, de bloqueo y de espera.
builtin:service.nonDbChildCallCount:splitBy("dt.entity.service")builtin:service.dbconnections.failureRate
La tasa de intentos de conexión a una base de datos que fallan, respecto a todos los intentos. Un pool saturado o una base inalcanzable se ven aquí antes que los errores de aplicación.
builtin:service.dbconnections.failureRate:splitBy("dt.entity.service")Key requests
Una key request es un punto de entrada que marcas como crítico (pago, inicio de sesión). Dynatrace escribe entonces métricas dedicadas para cada una.
builtin:service.keyRequest.response.time
El tiempo de respuesta de una key request, en microsegundos. Es la granularidad adecuada para un SLO de latencia sobre un recorrido de negocio: evita que peticiones secundarias diluyan la señal.
builtin:service.keyRequest.response.time:splitBy("dt.entity.service_method"):percentile(95)builtin:service.keyRequest.count.total
El número de peticiones de una key request. Sirve de denominador a los SLO y de señal de negocio: aquí se ve una caída del volumen de pagos.
builtin:service.keyRequest.count.total:splitBy("dt.entity.service_method")builtin:service.keyRequest.errors.server.rate
La tasa de fallos en el servidor de una key request. Junto con el tiempo de respuesta, cubre los dos SLI más usados en un punto de entrada crítico.
builtin:service.keyRequest.errors.server.rate:splitBy("dt.entity.service_method"):avgCómo comprobar que funciona
- Lista las claves de servicio disponibles:
curl -s "$DT_URL/api/v2/metrics?metricSelector=builtin:service.*&fields=unit,aggregationTypes" \ -H "Authorization: Api-Token $DT_TOKEN" - Ejecuta una consulta del módulo:
curl -s -G "$DT_URL/api/v2/metrics/query" \ --data-urlencode 'metricSelector=builtin:service.response.time:splitBy("dt.entity.service"):percentile(90)' \ --data-urlencode 'from=now-2h' \ -H "Authorization: Api-Token $DT_TOKEN" - Compara un valor con el gráfico de la página del servicio: al dividir entre 1 000, los microsegundos deben corresponder a los milisegundos mostrados.
Las métricas keyRequest no devuelven nada mientras ninguna petición esté marcada como clave. La sintaxis del metric selector se detalla en el módulo de metric selector y API.
Buenas prácticas
- Lee los tiempos en microsegundos y conviértelos antes de compararlos con un objetivo en milisegundos.
- Usa un percentil para la latencia y un ratio éxitos/total para la disponibilidad.
- Separa 4xx y 5xx: solo los segundos reflejan, en general, la fiabilidad del servicio.
- Marca tus recorridos críticos como key requests para obtener métricas con la granularidad adecuada.
Preguntas frecuentes
¿Qué diferencia hay entre errors.total y errors.server?
La primera cuenta los fallos medidos en el servidor o en el cliente; la segunda, solo en el servidor. Para juzgar el servicio en sí, parte del lado servidor.
¿Dónde están las bases de datos en este módulo?
Vistas desde el servicio que llama: llamadas, tiempos y fallos de conexión. Las métricas internas de un motor de base de datos dependen de las extensiones (módulo 6).
¿Existen estas claves en Grail?
Existen equivalentes dt.service.* en Dynatrace SaaS con Grail, con nombres y unidades a veces distintos; el curso de métricas de SaaS los trata.
Con los hosts y los servicios ya tienes los dos escalones del lado servidor. El módulo siguiente pasa al lado de los usuarios: aplicaciones web y móviles, Apdex y monitores sintéticos.
← Módulo 2: hosts · Índice del curso · Módulo 4: aplicaciones →
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Las claves y unidades citadas proceden de la documentación oficial de Dynatrace Managed; compruébalas en la versión de tu clúster.