يوم الجمعة، في اجتماع الفريق، يُطرح السؤال: هل نستطيع استضافة نموذج مفتوح كبير على جهاز المكتب دون خادم بثمانية معالجات رسوميات؟ في حالة نموذج MoE محلي، لا يتوقف الجواب على قوة الحساب بقدر ما يتوقف على موازنة بين الذاكرة والقرص والصبر. يقترح Colibri، وهو مستودع استدلال مكتوب بلغة C على GitHub، أن يتولى هذه الموازنة عنك.
أنطلق من قرار التشغيل لا من التثبيت: ما الذي ينبغي معرفته قبل تنزيل 400 غيغابايت؟ توضيح منهجي: لم أشغّل Colibri بنفسي. كل ما يلي مأخوذ من مستودع JustVugg/colibri الذي قرأته في 10 نوفمبر 2026 (ملف README وسجل التغييرات ووثائق الواجهة). والسرعات المذكورة هي سرعات المشروع نفسه على أجهزته.
المستودع مرخّص برخصة Apache 2.0. صدر الإصدار 2.1.0 في 31 أكتوبر 2026، والنشاط فيه يومي. كانت GitHub تعرض نحو 49 500 نجمة و5800 فرع (أرقام مقرّبة من الصفحة وليست دقيقة). المشروع فتيّ وسريع التغيّر، فاعتبر أرقامه قياسات تحتاج إلى إعادة إنتاج.
نموذج MoE محلي: لماذا لم تعد الذاكرة العشوائية العائق الوحيد
نموذج MoE (مزيج الخبراء، mixture of experts) ضخم على القرص لكنه مقتصد في كل توكن. بحسب README، يضم GLM-5.2 744 مليار معامل، ويفعّل منها نحو 40 مليارًا لكل توكن (5.4%)، ولا يتغير من توكن إلى التالي سوى نحو 11 غيغابايت: الخبراء الموجَّهون.
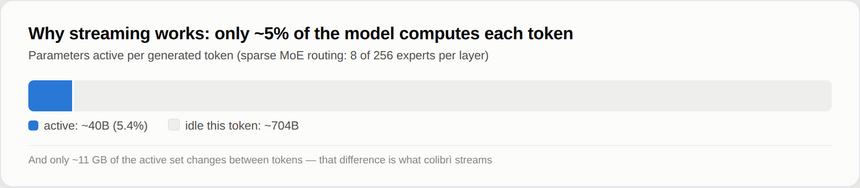
والنتيجة العملية بسيطة. لا يحتاج النموذج إلى أن يتسع في الذاكرة السريعة، بل إلى أن يوضع في مكانه الصحيح. يُبقي Colibri الجزء الكثيف (الانتباه والخبراء المشتركين والتضمينات) في الذاكرة العشوائية، ويقرأ الخبراء من القرص عند الطلب عبر ذاكرة مؤقتة تتعلم أيهم يستدعيه استخدامك. وإن وُجد معالج رسوميات، فإنه يستقبل الخبراء الأكثر طلبًا.
يؤكد المشروع على نقطة واحدة: موضع الوزن يؤثر في السرعة فقط لا في النتيجة. قد تكلّف الذاكرة السريعة الأقل وقتًا، لكنها لا تكلّف دقة النموذج أبدًا، كما يقول README. هذا وعد من المشروع لا أستطيع تأكيده دون قياس.
كم توكن في الثانية: اقرأ الجدول قبل أن تحلم
يعطي README لكل نموذج حدًّا أدنى للذاكرة العشوائية لا يعمل شيء دونه، وحدًّا ثانيًا تُبلَغ عنده السرعة المقيسة. فيما يلي بعض الأسطر كما نُشرت:
- Qwen3.6-35B-A3B (تنزيل 23 غيغابايت): 6.0 توكن/ث على المعالج، و30.0 مع CUDA على بطاقة RTX 3070؛
- DeepSeek V4 Flash (167 غيغابايت): 0.93 توكن/ث مع 32 غيغابايت من الذاكرة، على المعالج وحده؛
- GLM-5.2 (429 غيغابايت، حد أدنى 16 غيغابايت من الذاكرة): من 0.05 إلى 0.1 توكن/ث عند البدء البارد على حاسوب محمول بذاكرة 25 غيغابايت، و1.83 على جهاز بذاكرة 128 غيغابايت، و9.0 إلى 9.2 على ست بطاقات RTX 5090؛
- Kimi K3 (1.56 تيرابايت): نحو 9.4 ثانية لكل توكن.
اقرأ هذا كما يقرأ مهندس SRE اتفاقية مستوى الخدمة: حاسوب محمول يخرج توكنًا كل عشر إلى عشرين ثانية يجيب «بشكل صحيح»، لكنه لا يخدم أي مستخدم. وفي المعالجة الدفعية الليلية أو التقييم أو المساعد الفردي، قد تكفي سرعة أقل من توكن في الثانية. أما إذا كان الفريق يتحاور مباشرة، فاتجه إلى النماذج الصغيرة أو إلى معالج رسوميات.
القرص هو العامل الحاسم في النماذج الكبيرة. يذكر المشروع أن قرص NVMe سريعًا هو الأكثر نفعًا، وأن قرصي NVMe على متحكّمين مستقلين سجّلا زيادة 37.5% في معدل التوليد. القرص الواحد البطيء ليس تفصيلًا، بل هو سقفك.
تثبيت Colibri: ما يقوله README
العتاد الأدنى المعلن: 8 غيغابايت من الذاكرة (يُنصح بـ 16 أو أكثر)، و22 غيغابايت فارغة لأصغر نموذج، واتصال بالإنترنت. معالج الرسوميات اختياري، وتُدعم Vulkan وCUDA وMetal بحسب المحرك. وهذه الطريقة بخطوة واحدة على Linux:
sudo apt install git python3 build-essential
git clone https://github.com/JustVugg/colibri
cd colibri
./start-here.sh
على Windows يُفكّ ضغط الأرشيف ثم يُشغَّل START-HERE.bat؛ وعلى macOS تُثبَّت Xcode CLT وlibomp وgit وpython عبر Homebrew ثم يُشغَّل السكربت نفسه. يفحص البرنامج الجهاز، ويوصي بأقدر نموذج يتسع في الذاكرة، ويبني المحرك، وينزّل مع إمكانية الاستئناف، ثم يفتح لوحة المتابعة. ومن الخيارات المفيدة: --list يقارن كل النماذج بجهازك، و--model ID يفرض نموذجًا بعينه، و--dir يغيّر القرص الوجهة.
قبل الالتزام بتنزيل 400 غيغابايت، يوفّر المشغّل ثلاثة أوامر صُمّمت للحسم، وفق README دائمًا: يعرض coli plan أين سيعيش النموذج (VRAM أو الذاكرة أو القرص)، ويفحص coli doctor دون تعديل أي شيء، ويقيس coli tune ويحفظ أسرع الإعدادات الآمنة لجهازك.
مشاهدة الخبراء وهم يعملون
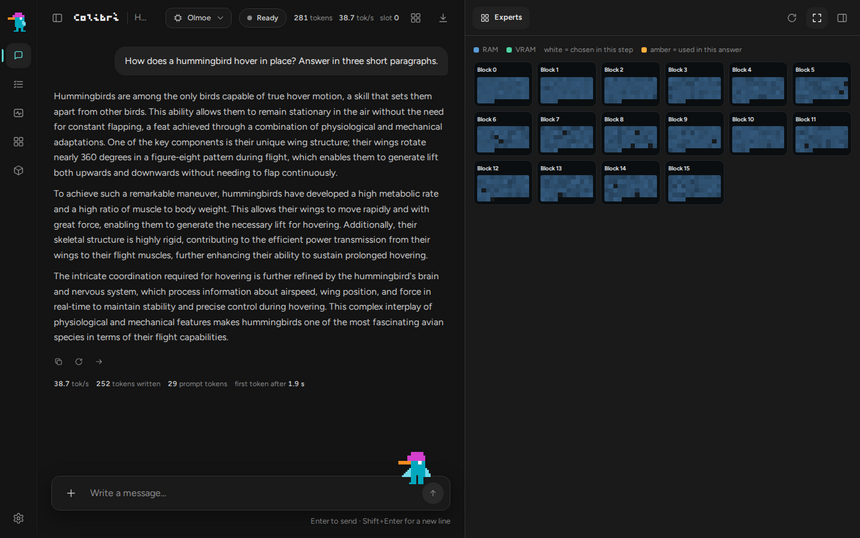
تعرض لوحة المتابعة (coli web) وواجهة coli ui خريطة للخبراء: خلية لكل خبير في كل كتلة، بيضاء حين يُختار في الخطوة الحالية، وعنبرية حين يساهم في الإجابة. تُظهر اللقطة التالية نموذج OLMoE، وهو النموذج الصغير بسبعة مليارات معامل الذي ينصح به المشروع لتعلّم الأدوات.
وتعرض شاشة ثانية، هي المراقب، حالة النموذج (خامل أو يقرأ أو يكتب) والسرعة وزمن قراءة الموجّه واستهلاك المحرك من الذاكرة والمعالج.
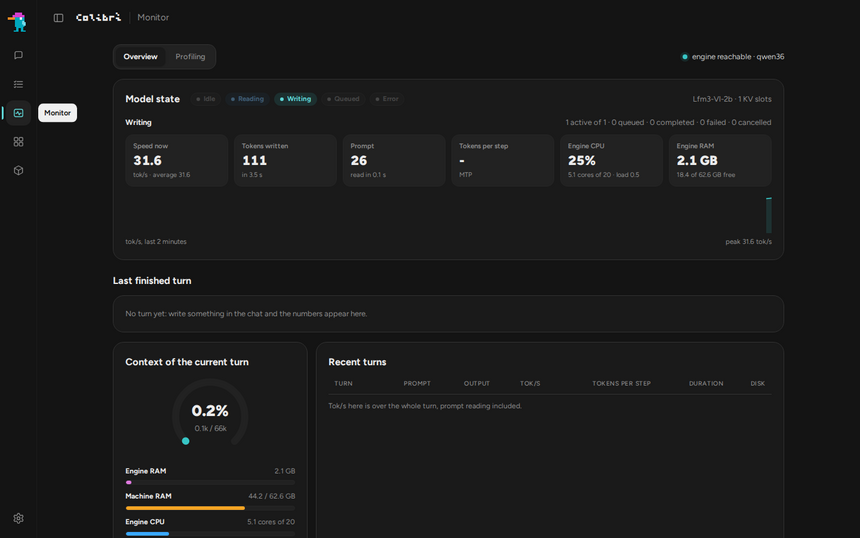
اللقطتان من مستودع المشروع (رخصة Apache 2.0). وهما لا تُظهران نموذجًا كبيرًا يعاني، بل نماذج صغيرة مرتاحة. فلا تعتبرهما دليلًا على السرعة مع نموذج بـ 744 مليار معامل.
كشف الخادم ومراقبته
يشغّل coli serve خادمًا متوافقًا مع OpenAI (/v1/chat/completions) ومع Anthropic (/v1/messages). وهو يستمع افتراضيًا على localhost. وبحسب الوثائق، يجب تعريف COLI_API_KEY قبل فتحه على الشبكة. افعل ذلك أولًا: خادم استدلال بلا مفتاح في شبكة مؤسسة هو باب دخول مجاني.
أما للمراقبة، فتصف وثائق الواجهة نقطتين مفيدتين. تعرض GET /health عدّادات الطلبات النشطة والمنتظرة في الطابور والمنتهية والمرفوضة، وتردّ بالرمز 503 مع {"status": "restarting"} أثناء إعادة تشغيل المحرك، وتحصي عمليات إعادة التشغيل في engine_restarts. وتعيد GET /metrics نص Prometheus تبدأ كل أسمائه بـ colibri_scheduler_، وفيه مقاييس لحظية (active وqueued) وعدّادات (completed_total وfailed_total وrejected_total وtimed_out_total) ومدرّجات تكرارية (queue_wait_seconds وfirst_output_seconds وengine_call_seconds). ولا تحتوي المقاييس على أي موجّه أو مسار نموذج.
يستطيع OpenTelemetry Collector جمعها عبر مستقبِل Prometheus. هذا مثال بسيط يلزم تكييفه (الهدف والمُصدِّر قيمتان توضيحيتان):
receivers:
  prometheus:
    config:
      scrape_configs:
        - job_name: colibri
          scrape_interval: 30s
          authorization:
            credentials: ${env:COLI_API_KEY}
          static_configs:
            - targets: ["127.0.0.1:8000"]
exporters:
  otlphttp:
    endpoint: ${env:OTLP_ENDPOINT}
service:
  pipelines:
    metrics:
      receivers: [prometheus]
      exporters: [otlphttp]
لم أجرّب هذا الإعداد مع Colibri ولم أتحقق من الاستيعاب في Dynatrace، سواء Managed أو SaaS، فهو Collector قياسي. أما الإشارات التي تستحق المتابعة فهي: queue_wait_seconds للتزاحم، وfirst_output_seconds لانتظار المستخدم، وfailed_total مع engine_restarts لاكتشاف محرك أنهاه مدير الذاكرة. وللتعمق أكثر في مراقبة محرك محلي، راجع مقالنا عن Ollama ومقال vLLM في الإنتاج.
الحدود والنقاط المفتوحة
- المستودع فتيّ ويتغير بسرعة: 387 طلب دمج (pull request) بين الإصدارين 2.0.0 و2.1.0 بحسب سجل التغييرات. ثبّت إصدارًا بعينه.
- يحفظ المشروع بنفسه مسارات التحسين في قائمة فرضيات تنتظر إعادة الإنتاج، مع إخفاقات منشورة؛ منها تخمين MTP قيس أبطأ بنسبة 32% عند نجاح الذاكرة المؤقتة بنحو 85%. هذه علامة أمانة جيدة، لكنها دليل أيضًا على أن الإعدادات تُقاس جهازًا بعد جهاز.
- كل السرعات مصدرها المشروع، ولم يُعد إنتاج أي منها هنا.
- لبعض النماذج رخصتها الخاصة (Qwen-Image غير تجارية، وMuse Spark Open بموجب اتفاق مع Meta): رخصة Apache 2.0 الخاصة بالمحرك لا تشمل الأوزان.
- قارنه بمحركات أكثر انتشارًا قبل أن تقرر: راجع مقارنة Ollama وvLLM وllama.cpp، ولنموذج كبير على معالج رسوميات راجع الاستضافة الذاتية لـ Mistral Large 4.
ممارسات جيدة
- ابدأ بنموذج صغير (OLMoE أو Qwen3.6) للتحقق من السلسلة كاملة قبل التنزيل الكبير.
- ضع النماذج على أسرع قرص NVMe، ولا تضعها أبدًا على مسار شبكي أو على
/mnt/cداخل WSL، وهو ما يحذّر منه README. - عرّف
COLI_API_KEYوأبقِ الاستماع على localhost إلى أن يتوفر وكيل عكسي مع مصادقة. - اجمع
/metricsمنذ اليوم الأول، مع تنبيه علىfailed_totalوآخر على مدةfirst_output_seconds. - دوّن قياساتك الخاصة (العتاد والأمر وحالة الذاكرة المؤقتة): يطلبها المشروع، وهي التي ستمنحك اتفاقية مستوى خدمة جديرة بالثقة.
الأسئلة الشائعة
هل أحتاج إلى معالج رسوميات لتشغيل نموذج MoE محلي مع Colibri؟
لا، بحسب README: كل المحركات تعمل على المعالج. معالج الرسوميات مجرد مكان أسرع لحفظ الأوزان. وفي النماذج الكبيرة يحدد القرص السرعة، وفي الصغيرة تحددها الذاكرة العشوائية.
ما السرعة المتوقعة على جهاز عادي؟
تتفاوت بأكثر من 100 ضعف بحسب النموذج: من بضعة توكنات في الثانية لنموذج بـ 35 مليار معامل، إلى أقل من توكن واحد في الثانية للنماذج الضخمة جدًا. قس باستخدام coli tune على عتادك بدل الاعتماد على جدول.
هل يناسب Colibri فريق عمل؟
يدير الخادم طابورًا وخانات ذاكرة مؤقتة ويرفض الطلبات بالرمز 429، لكنني لم أتحقق من سلوكه تحت الحمل. جرّب بحالات استخدامك وراقب الطابور قبل فتح الخدمة.
الخلاصة
يصبح نموذج MoE محلي واقعيًا لأن جزءًا صغيرًا فقط من المعاملات يعمل في كل توكن. ويمضي Colibri بهذه الفكرة إلى نهايتها: الذاكرة تحفظ نواة النموذج، والقرص يحفظ الباقي. قبل التنزيل، انظر إلى سطر جهازك في الجدول، وشغّل coli plan، ثم اربط /metrics لتتحول السرعة المعلنة إلى سرعة مقيسة.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC. Colibri مشروع تابع لطرف ثالث؛ المعلومات مأخوذة من مستودعه العام وقد تتغير، فتحقق منها قبل أي استخدام في الإنتاج.