Despliegas un DynaKube y el pod de ActiveGate se queda atascado: kubectl get pods muestra 0/1 en la columna READY, a veces durante horas. Los eventos hablan de un «Readiness probe failed» con código 503. Esta guía explica cómo diagnosticar un ActiveGate Kubernetes no listo, paso a paso y sin adivinar: qué comprueba la sonda, qué leer en los eventos y en los logs, qué causas descartar y en qué orden, y qué adjuntar a un ticket de soporte.
Objetivo: recuperar un ActiveGate listo (1/1), es decir, agentes OneAgent enrutados y la supervisión de la API de Kubernetes de nuevo en marcha. Cada minuto perdido con este pod alarga el MTTR.
Alcance: el comportamiento descrito vale para Dynatrace SaaS y para un clúster Dynatrace Managed gestionado con Dynatrace Operator. Las páginas de documentación consultadas son las de la documentación SaaS; en Managed, comprueba la compatibilidad entre la versión del clúster y la del Operator (consulta Dynatrace Operator en Managed).
ActiveGate Kubernetes no listo: qué comprueba realmente la sonda
Cuando el Operator crea el ActiveGate de un DynaKube, lo despliega como StatefulSet con dos sondas HTTPS en el puerto 9999. Los valores siguientes proceden del código fuente del repositorio Dynatrace/dynatrace-operator (licencia Apache 2.0, rama principal a 30 de octubre de 2026, archivo probe.go). Pueden cambiar de una versión a otra: relee el archivo de la versión que ejecutas.
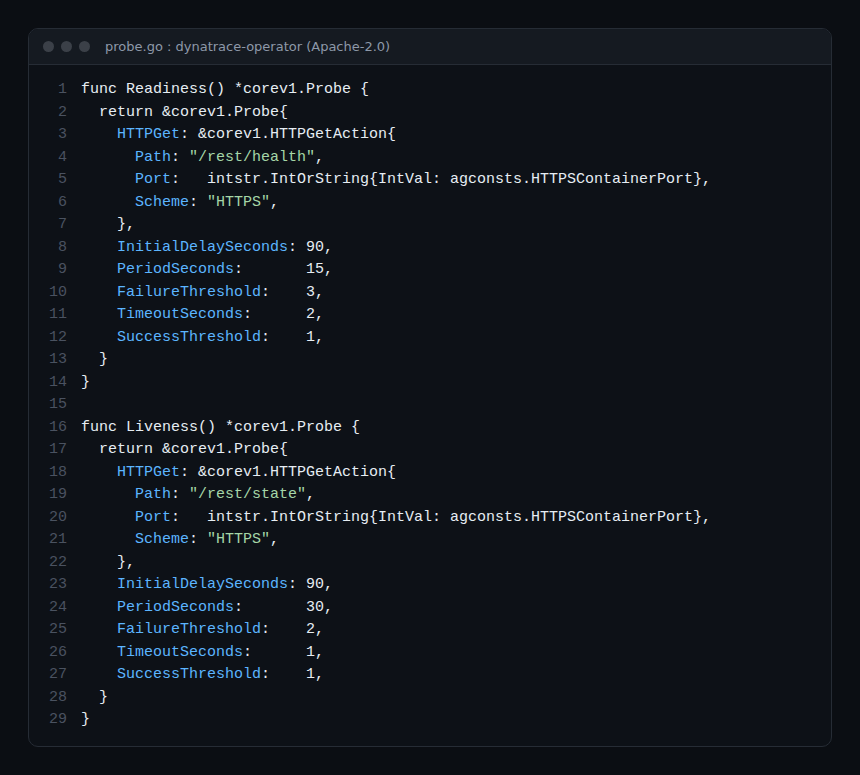
| Sonda | Ruta | Retraso inicial | Periodo | Fallos tolerados | Timeout |
|---|---|---|---|---|---|
| Readiness | /rest/health |
90 s | 15 s | 3 | 2 s |
| Liveness | /rest/state |
90 s | 30 s | 2 | 1 s |
Tres consecuencias prácticas. Primero, un pod en 0/1 durante los primeros 90 segundos es normal: la primera sonda todavía no se ha ejecutado. Segundo, según la documentación de Kubernetes, un código HTTP mayor o igual que 200 y menor que 400 es un éxito y cualquier otro código es un fallo: un 503 en /rest/health significa, por tanto, que el proceso ActiveGate responde pero todavía no se declara sano. Tercero, la sonda de vivacidad es más estricta: según esa misma documentación, un fallo de liveness hace que el kubelet mate y reinicie el contenedor. Un pod que se reinicia en bucle no tiene el mismo perfil que un pod estable en 0/1.
El nombre del pod sigue una convención visible en la salida de ejemplo del archivo de soporte del Operator: <nombre del dynakube>-activegate-0, con el StatefulSet <nombre del dynakube>-activegate. El contenedor se llama activegate (constante del código fuente).
Diagnosticar paso a paso
La página Troubleshooting de la documentación del Operator da los comandos básicos. Este es un orden que evita dar vueltas en círculo. Sustituye el nombre del pod por el tuyo.
- Comprobar el estado. Lista los pods del namespace
dynatracey el DynaKube. Anota el número de reinicios (columna RESTARTS): cero apunta más bien a un problema de salud interna; un número que sube apunta a una sonda de vivacidad o a una parada por falta de memoria. - Leer los eventos del pod.
kubectl describe podlos muestra al final de la salida. Busca las líneas Readiness probe failed y su código, después Liveness probe failed, Back-off, o los errores de planificación (FailedScheduling) y de montaje de volumen. - Leer los logs del contenedor con
kubectl logs; tras un reinicio, añade--previouspara obtener los de la instancia anterior. - Ejecutar el diagnóstico del Operator: subcomando
troubleshoot, detallado más abajo. - Recoger un archivo de soporte si nada explica el 503 (última sección).
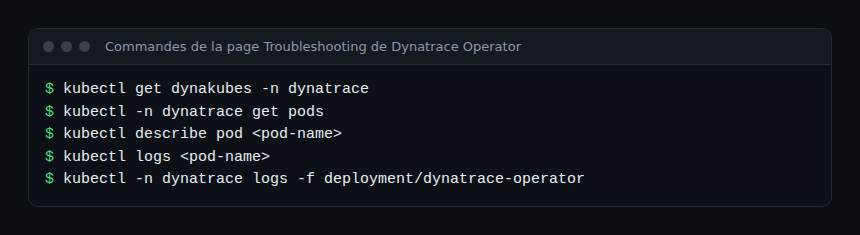
kubectl get dynakubes -n dynatrace
kubectl -n dynatrace get pods
kubectl describe pod <nom-du-pod> -n dynatrace
kubectl get events -n dynatrace --sort-by=.metadata.creationTimestamp
kubectl logs <nom-du-pod> -n dynatrace --previous
Los tres primeros comandos figuran en la documentación del Operator. --sort-by y --previous son opciones estándar de kubectl: confírmalas con --help en tu versión.
Las causas que hay que descartar, de la más probable a la más rara
1. Falta de memoria (OOMKilled)
El campo resources de la sección spec.activeGate del DynaKube lleva las solicitudes y los límites del contenedor; la documentación precisa que hay que adaptarlos a la carga supervisada y que no tiene valor por defecto. Un ActiveGate infradimensionado puede ser terminado y relanzado. Desde el Operator 1.10.0, según las notas de versión, el comando troubleshoot señala los pods ActiveGate terminados recientemente por este motivo (OOMKilled) en su archivo troubleshoot.txt.
2. Red y dependencias de arranque
Un ActiveGate que no consigue alcanzar la API del entorno no llega a estar sano. Desde un pod efímero, prueba la URL de la API como en el artículo sobre la instalación del Operator: un proxy, un cortafuegos o un certificado no reconocido son los sospechosos habituales. Para la lógica de elección entre ActiveGate de entorno y de clúster, consulta ActiveGate de entorno o de clúster.
3. Certificado TLS personalizado
Según la página de parámetros del DynaKube, tlsSecretName designa un secreto que contiene certificado, clave y contraseña; sin él se usa un certificado autofirmado. Las capacidades metrics-ingest y dynatrace-api exigen un certificado personalizado. Un secreto mal formado o ausente es, por tanto, una pista seria si has activado alguna de ellas.
4. Planificación y recursos del clúster
Un pod en Pending no es un fallo de sonda: es un problema de planificación (recursos, taints, selectores). Ten en cuenta también que, según las notas de versión 1.10.0, la restricción de distribución topológica del ActiveGate usa ahora ScheduleAnyway, lo que facilita las actualizaciones en clústeres pequeños pero reinicia el ActiveGate durante la actualización.
5. Dependencia entre componentes
Las mismas notas describen dos correcciones ligadas al orden de arranque: un bloqueo mutuo cuando KSPM está activado y el ActiveGate del clúster es el único de la zona de red, y, cuando networkZone está definido, una espera al registro del ActiveGate de enrutamiento antes de desplegar OneAgent. Si estás en una versión anterior, actualizar el Operator puede bastar.
Usar troubleshoot y el archivo de soporte
El comando siguiente ejecuta las comprobaciones del Operator (existencia del namespace, del CRD y del DynaKube, formato de la URL de la API, etc.):
kubectl exec deploy/dynatrace-operator -n dynatrace -- dynatrace-operator troubleshootLa verificación de los ActiveGate lista los pods con las etiquetas del DynaKube y emite una advertencia por cada contenedor cuyo último estado de parada es OOMKilled, con la hora y el código de salida. Un resultado sin alertas solo descarta la configuración básica y la memoria.
Para un ticket de soporte, la documentación describe dos archivos. El primero viene del Operator; incluye los logs del ActiveGate cuando está desplegado (archivo <nombre del dynakube>-activegate-0/activegate.log) y el manifiesto del StatefulSet:
kubectl exec -n dynatrace deployment/dynatrace-operator -- dynatrace-operator support-archive --stdout > operator-support-archive.zipLa documentación advierte de que, en un clúster grande, ejecutar este comando en el pod del Operator puede provocar la parada de su contenedor por falta de memoria; propone una variante con un pod autónomo. El segundo archivo viene del propio ActiveGate (agctl, ActiveGate 1.333 y posteriores para contenedores; antes se aplica el comando obsoleto create-support-archive):
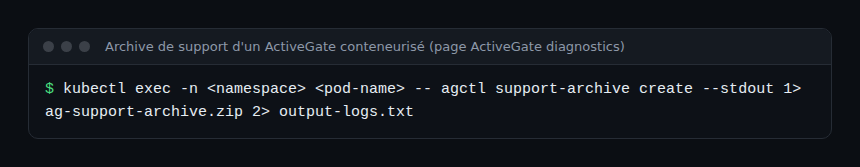
La documentación precisa que PowerShell no es compatible con esta redirección: usa cmd.exe en Windows. Revisa el archivo antes de enviarlo: puede contener nombres internos.
Cómo comprobar que funciona
kubectl -n dynatrace get podsmuestra1/1para<dynakube>-activegate-0y RESTARTS ya no cambia.kubectl describe podya no muestra ninguna línea nueva Readiness probe failed después de la hora de tu corrección.- El DynaKube está al día:
kubectl get dynakubes -n dynatraceya no muestra errores de fase. - En Dynatrace, los agentes vuelven a estar enrutados y la supervisión de Kubernetes se reanuda. Para recibir un aviso antes de la próxima vez, crea una alerta sobre pods no listos; consulta alertas de Kubernetes sobre nodos, pods y cuotas.
Buenas prácticas
- Define
resourcespara el ActiveGate en lugar de dejar el pod sin límite: es la primera palanca contra los reinicios. - Mantén una versión reciente del Operator y lee sus notas de versión antes de cada actualización.
- Recoge los eventos antes de eliminar el pod: un pod nuevo borra la pista.
Preguntas frecuentes
¿Por qué mi pod ActiveGate sigue en 0/1 después del arranque?
La sonda de disponibilidad consulta /rest/health por HTTPS en el puerto 9999 tras 90 segundos y después cada 15 segundos. Mientras la respuesta no sea un código de éxito, el pod no está listo. Lee los eventos y los logs para averiguar por qué el ActiveGate no se declara sano.
¿Un código 503 es un error de mi configuración?
No necesariamente. Indica que el servidor responde sin estar sano. La causa está en los logs del ActiveGate: memoria, acceso al entorno, certificado, arranque sin terminar. La documentación consultada no da una lista oficial de causas de un 503 en esta ruta: las pistas anteriores son un método, no un catálogo.
¿Hay que eliminar el pod para repararlo?
Solo después de recoger eventos y logs. Eliminar el pod lo recrea con la misma configuración: si la causa es un límite de memoria o un secreto TLS erróneo, el pod nuevo fallará igual.
Conclusión
Un ActiveGate Kubernetes no listo no es un misterio: una sonda precisa, eventos, logs y un comando de diagnóstico bastan para decidir entre memoria, red, certificado y planificación.
Este artículo procede de un blog independiente, no afiliado a Dynatrace LLC ni al proyecto Dynatrace Operator. Dynatrace es una marca de Dynatrace LLC. Los valores de las sondas proceden del código fuente público del repositorio Dynatrace Operator y pueden cambiar según la versión. Comprueba siempre los valores en la documentación oficial correspondiente a tu versión.