Un cliente avisa de que un pedido ha fallado. Soporte te da un número de pedido, no un identificador de traza. ¿Hace falta entonces un correlation ID de negocio, o basta con el trace_id de OpenTelemetry? La respuesta depende de lo que quieras unir: una petición técnica o una acción que dura varios días.
Este artículo compara los dos identificadores, explica qué garantiza cada uno y propone una regla de elección para un equipo SRE. El contenido vale para Dynatrace SaaS y para OpenTelemetry en general; en Dynatrace Managed, los nombres de los campos y las pantallas dependen de la versión, así que conviene comprobarlos en la documentación de tu clúster.
Para configurar el trace_id en los logs, consulta los logs de OpenTelemetry y el trace_id en Dynatrace. Aquí el foco está en la elección del identificador.
Correlation ID o trace ID: la diferencia
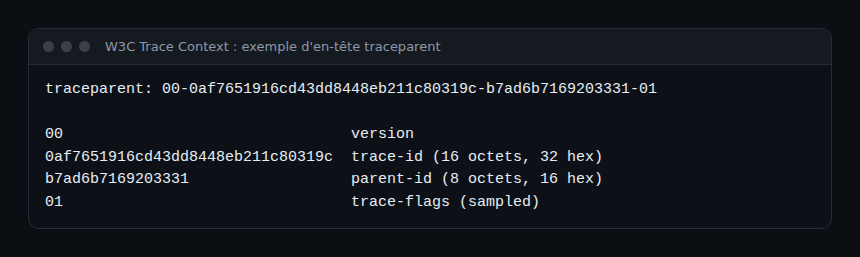
El trace_id es un estándar. Según la especificación W3C Trace Context, identifica «the whole trace forest»: una traza distribuida completa. Ocupa 16 bytes, es decir, 32 caracteres hexadecimales en minúsculas, y el valor completamente nulo no es válido. La especificación pide que sea globalmente único y prefiere un valor aleatorio.
El correlation ID no tiene una definición normativa equivalente. Es una convención de equipo: un identificador que tú eliges (a menudo la cabecera X-Request-ID o un número de pedido) y que copias en logs, mensajes y tickets. Su formato, su duración y su propagación dependen, por tanto, de tu código. Esa falta de norma es su defecto, pero también su fuerza: puede sobrevivir donde una traza se detiene.
Qué une cada identificador
| Criterio | trace_id | Correlation ID |
|---|---|---|
| Origen | Generado por el SDK o el agente al inicio de la petición | Elegido por la aplicación o leído de una cabecera |
| Formato | 32 caracteres hexadecimales (W3C) | Libre |
| Alcance | Una petición distribuida | Una acción de negocio, a veces varias peticiones |
| Propagación | Cabecera traceparent, gestionada por la instrumentación |
A tu cargo (cabecera, mensaje, baggage) |
| Legible para soporte | Raramente | Sí, si es un número conocido por el cliente |
| Muestreo | Puede desaparecer si la traza no se conserva | Permanece en los logs |
El punto decisivo es la duración. Una traza cubre una petición; un pago validado tras una llamada asíncrona, un correo de confirmación y un reintento nocturno cubren varias. El trace_id cambia en cada eslabón que inicia una nueva traza (proceso por lotes, consumidor de cola). El correlation ID, en cambio, se mantiene idéntico si lo transportas.
Cómo usa Dynatrace el trace ID
En OpenTelemetry, el modelo de datos de los logs prevé los campos opcionales TraceId, SpanId y TraceFlags. Un log emitido dentro de un span activo los recibe del SDK. La especificación precisa que, si SpanId está presente, TraceId debería estarlo también.
La documentación de Dynatrace sobre la ingesta OTLP de logs indica que TraceID y SpanID se asignan a los campos trace_id y span_id, convertidos a hexadecimal. Para los logs enriquecidos por OneAgent, la documentación menciona más bien dt.trace_id y dt.span_id. Existen, pues, dos nombres según la fuente: inspecciona un registro real antes de escribir tus consultas. Consulta también las Distributed traces y PurePath para leer una traza.
Propagar un correlation ID con el baggage
Si conservas un correlation ID, no lo copies a mano en cada servicio. OpenTelemetry prevé el baggage, definido como información contextual transmitida entre señales, que viaja con el contexto a través de las cabeceras HTTP.
- Crea el identificador en la entrada. Lee la cabecera entrante o genéralo en la frontera del sistema.
- Colócalo en el baggage.
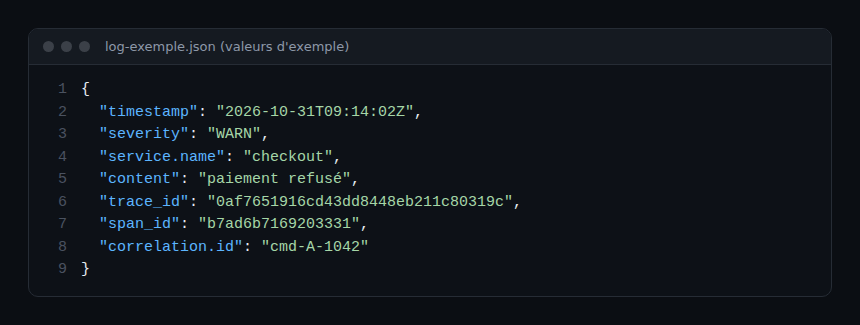
from opentelemetry import baggage, context ctx = baggage.set_baggage("correlation.id", "cmd-A-1042") token = context.attach(ctx) - Cópialo explícitamente como atributo. La documentación precisa que el baggage es «a separate key-value store» no asociado a los atributos: debes añadirlo tú mismo a los spans y a los logs, o usar un procesador de baggage cuando tu lenguaje lo ofrezca.
span.set_attribute("correlation.id", baggage.get_baggage("correlation.id")) - Escríbelo en los logs bajo una clave estable, junto al
trace_id.
Atención: la documentación de OpenTelemetry advierte de que el baggage puede quedar expuesto a terceros, visible en el tráfico de red, y de que no tiene control de integridad. No pongas nunca datos personales ni secretos en este campo, y no confíes en un valor recibido de un cliente externo.
Cómo comprobar que funciona
En un Notebook de Dynatrace SaaS, busca primero los logs de una acción de negocio y luego remonta a sus trazas. El nombre de los campos puede variar: compruébalo con fetch logs | limit 1.
fetch logs, from: now() - 2h
| filter correlation.id == "cmd-A-1042"
| summarize traces = countDistinct(trace_id), logs = count()
Si traces vale más de 1, la acción atraviesa varias trazas: es el caso en que el correlation ID aporta lo que el trace_id no da. Para una traza concreta:
fetch logs, from: now() - 2h
| filter trace_id == "<trace_id>"
| fields timestamp, loglevel, content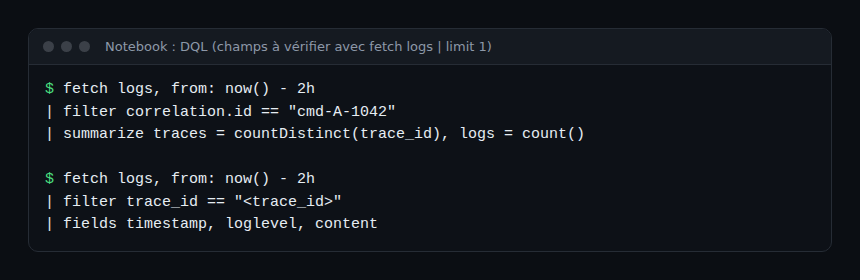
Regla de elección para un equipo SRE
- Diagnóstico técnico de una petición lenta o con error: el
trace_id. Es estándar, automático y une logs, spans y métricas. - Soporte al cliente y recorrido de negocio: el correlation ID, porque una persona puede facilitarlo y localizarlo.
- Procesos asíncronos: ambos. El correlation ID une las trazas, el
trace_idune cada traza con sus logs. - Fuentes sin instrumentación (sistema de terceros, archivo plano): el correlation ID, porque no existe ningún
trace_id.
Para el objetivo de fiabilidad, la combinación reduce el MTTR: soporte parte de un número legible y el ingeniero de guardia pasa a la traza. Esta elección afecta también al volumen; el tail sampling puede eliminar trazas, pero no los logs que llevan el correlation ID.
Buenas prácticas
- Un único nombre de campo para el correlation ID en toda la organización, documentado.
- Nunca datos personales como identificador (ni direcciones de correo ni números de tarjeta).
- No sustituyas el trace_id: no inventes un segundo formato de traza, usa
traceparent. - Cardinalidad: evita usar el correlation ID como dimensión de métrica; conviene a los logs y a los atributos de span.
- Retención: comprueba que los logs viven tanto como el plazo de reclamación de tus clientes.
Preguntas frecuentes
¿Se puede usar el trace ID como correlation ID?
Para una petición síncrona, sí. En cuanto un proceso asíncrono abre una nueva traza, el trace_id ya no es el mismo, y rara vez lo conoce el cliente.
¿Sustituye el correlation ID al trace_id en Dynatrace?
No. Dynatrace une logs y trazas mediante los campos de traza (trace_id, span_id). El correlation ID sigue siendo un atributo que filtras en DQL.
¿Es seguro el baggage para transportar un identificador?
Solo para un identificador sin valor sensible. Según la documentación de OpenTelemetry, es visible en el tráfico y carece de control de integridad.
Conclusión
El trace ID sirve al ingeniero, el correlation ID sirve al negocio: conserva ambos, cada uno en su papel. Empieza comprobando que tus logs ya llevan el trace_id y añade después un correlation ID donde una acción supere una petición. Para situar estas señales, lee la diferencia entre observabilidad y monitorización.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.