Hindsight memoria de agentes de IA: el repositorio vectorize-io/hindsight propone un sistema de memoria que se instala junto a un agente para que retenga lo que aprende de una sesión a otra. Su eslogan: «Agent Memory That Learns». Mostraba unas 50 500 estrellas a mediados de octubre de 2026, con licencia MIT, y la versión 1.0.0 apareció el 13 de octubre de 2026.
Una memoria de agente cambia la naturaleza del servicio que hay que supervisar. Conserva datos (a menudo personales), llama a un modelo de lenguaje en cada registro y en cada consolidación, y se inserta en la ruta de respuesta del agente. La latencia, el coste en tokens, la calidad de la recuperación y la confidencialidad pasan a ser asuntos de operación. Este artículo presenta el proyecto según su README, la instalación y después la supervisión: métricas de Prometheus, trazas de OpenTelemetry y alertas útiles.
La información procede del README y de la documentación del proyecto. span.observer no ha instalado Hindsight: los esquemas siguientes proceden del repositorio.
Hindsight memoria de agentes de IA: lo que dice el repositorio
- Editor: Vectorize AI, Inc. (mención de derechos de autor del archivo LICENSE, MIT). Hindsight™ es una marca; la misma empresa ofrece un servicio alojado, Hindsight Cloud, de pago por uso según el README.
- Tecnología: servidor Python (paquete PyPI
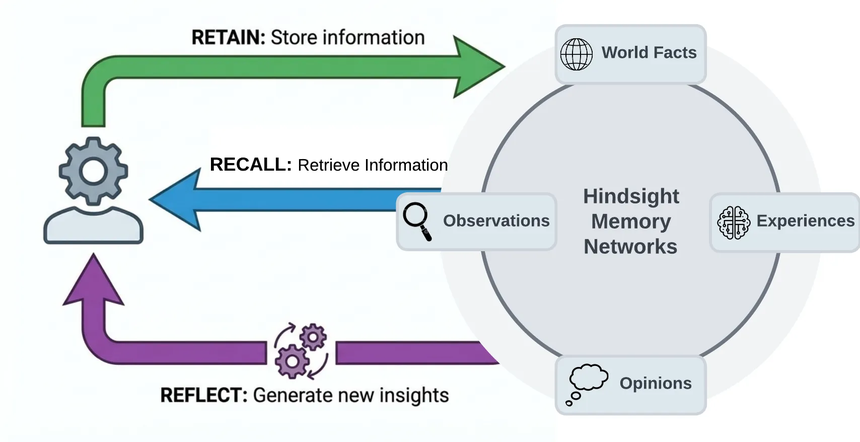
hindsight-api), clientes Python, Node.js, Go y CLI, almacenamiento en PostgreSQL con pgvector (u Oracle AI Database 23ai). - Principio: tres operaciones. Retain registra una información (un modelo de lenguaje extrae de ella hechos, entidades, relaciones y fechas), recall la recupera con cuatro estrategias en paralelo (semántica, palabras clave BM25, grafo, temporal), reflect produce un análisis más profundo de las memorias.
- Organización: las memorias viven en «banks»; tipos: hechos del mundo, experiencias, observaciones consolidadas y modelos mentales.
- Integraciones: el README anuncia más de sesenta (agentes de código, frameworks, herramientas sin código) y un servidor MCP integrado por bank, en la dirección
http://localhost:8888/mcp/{bank_id}/.
Instalar Hindsight según el README
Paso 1 — Arrancar el servidor
export OPENAI_API_KEY=sk-xxx

docker run -it --pull always --name hindsight --restart unless-stopped -p 8888:8888 -p 9999:9999 \
  -e HINDSIGHT_API_LLM_API_KEY=$OPENAI_API_KEY \
  -v hindsight-data:/home/hindsight/.pg0 \
  ghcr.io/vectorize-io/hindsight:latest
La API escucha en http://localhost:8888 y la interfaz en http://localhost:9999. La clave anterior es un valor de ejemplo. Hindsight funciona con más de 25 proveedores de modelos mediante HINDSIGHT_API_LLM_PROVIDER, incluidos modelos locales (Ollama, LM Studio, llama.cpp). Sin Docker: pip install hindsight-api y después hindsight-api. El README también propone un chart de Helm para Kubernetes.
Paso 2 — Conectar un cliente
pip install hindsight-client -Ufrom hindsight_client import Hindsight
client = Hindsight(base_url="http://localhost:8888")
client.retain(bank_id="my-bank", content="Alice works at Google as a software engineer")
client.recall(bank_id="my-bank", query="What does Alice do?")
client.reflect(bank_id="my-bank", query="Tell me about Alice")Para un agente ya existente, el README describe un «LLM Wrapper» en dos líneas (pip install hindsight-litellm y después wrap_openai): las memorias se recuperan antes de la llamada al modelo y la conversación se registra después.
Paso 3 — Aislar las memorias por usuario
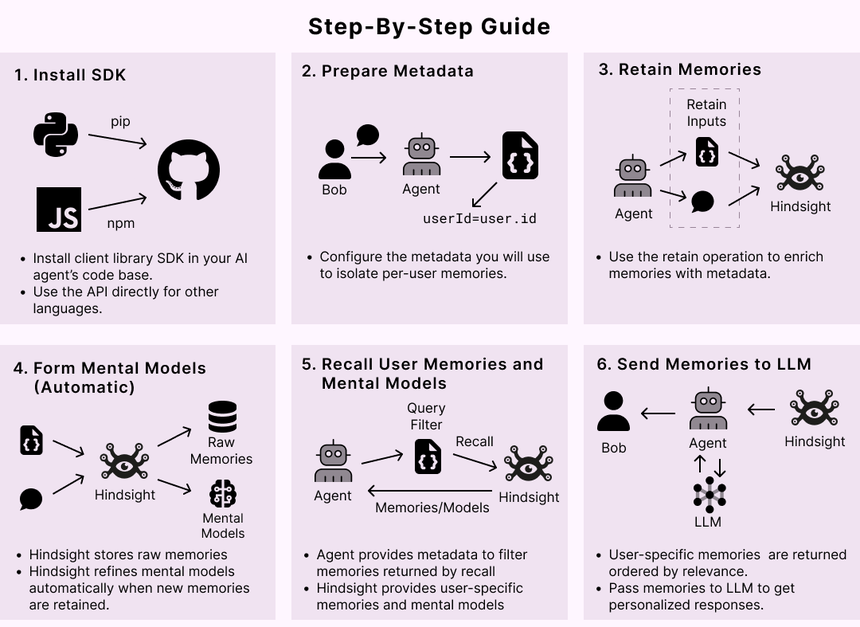
El README ilustra el aislamiento mediante metadatos (un identificador de usuario) y el flujo completo, desde el registro hasta el envío de las memorias al modelo.
Supervisar la memoria de un agente
Hindsight expone lo necesario para la operación: métricas de Prometheus en /metrics, trazas de OpenTelemetry y dos sondas de salud. El coste de la memoria se lee con el mismo método que el de el propio agente.
Trazas y métricas
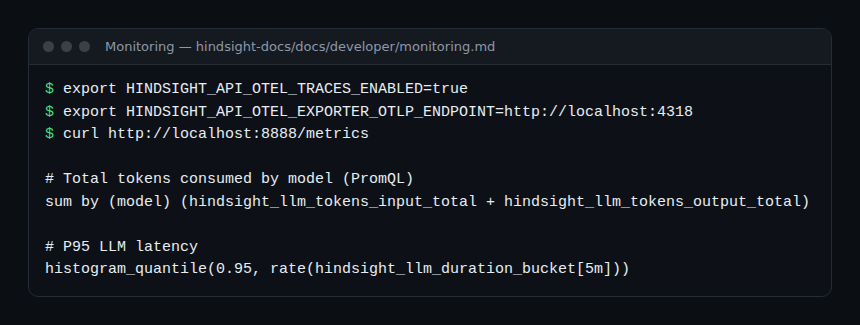
La documentación de monitorización describe un trazado conforme a las convenciones semánticas de GenAI (v1.37 y posteriores). Actívalo con dos variables y envía a cualquier backend OTLP:
- Spans de operación:
hindsight.retain,hindsight.recall(con sus subpasos de embedding, búsqueda, fusión y reranking),hindsight.reflect,hindsight.consolidation. - Spans de modelo: atributos
gen_ai.provider.name,gen_ai.request.model,gen_ai.usage.input_tokensygen_ai.usage.output_tokens, máshindsight.scope(memory,reflect,consolidation…). - Métricas de modelo:
hindsight.llm.calls.total,hindsight.llm.duration,hindsight.llm.tokens.inputyhindsight.llm.tokens.output, desglosadas por proveedor, modelo, ámbito y éxito. En Prometheus, los puntos se convierten en guiones bajos (hindsight_llm_tokens_input_total). - Operaciones:
hindsight.operation.durationyhindsight.operation.totalpor operación (retain,recall,reflect).
Los workers dedicados exportan sus propios spans (nombre de servicio por defecto hindsight-worker) y la documentación sitúa ahí la consolidación, el registro en segundo plano y la actualización de los modelos mentales, es decir, lo esencial del trabajo largo y del gasto en tokens; esos spans forman trazas separadas de la petición original. Las etiquetas bank_id y tenant están desactivadas por defecto para limitar la cardinalidad; HINDSIGHT_API_METRICS_INCLUDE_BANK_ID=true las activa.
Alertas útiles
- Tokens por ámbito: suma
hindsight_llm_tokens_input_totaly…_output_totalporscope: una consolidación que se dispara cuesta dinero sin que el agente responda más rápido. - Documentos sin memoria: la documentación da la proporción de
hindsight_retain_documents_total{outcome="no_facts"}sobre el total; un aumento señala un registro que tiene éxito pero no produce nada recuperable. - Fallos de consolidación:
hindsight_consolidation_batch_failures_total{failure_class="fail_fast"}indica que el modelo no produce un JSON conforme al esquema. - Latencia de recuperación: la recuperación se ejecuta en la ruta de respuesta del agente; sigue el percentil 95 de
hindsight_operation_durationpararecall.
Salud
Existen dos sondas: /health/live (sin acceso a la base de datos, para la vivacidad) y /health/ready o /health (con un SELECT 1, para la disponibilidad). La documentación advierte: no conectes nunca la sonda de vivacidad a una dependencia, o una base de datos lenta reiniciará todos los pods.
Cómo comprobar que funciona
curl http://localhost:8888/metricsdevuelve serieshindsight_*tras un primerretain.- Con el trazado activo, una operación
recallaparece con sus subspans, y los spans de modelo llevangen_ai.usage.input_tokens. - Un documento añadido y luego recuperado con
recallvuelve con su contenido; si no, consulta la proporciónno_facts.
Límites y puntos abiertos
- Afirmaciones de rendimiento. El README afirma que Hindsight es «el sistema de memoria de agentes más preciso jamás probado» en LongMemEval, con una reproducción independiente, y que las demás puntuaciones las declaran sus editores. Son afirmaciones del proyecto: span.observer no las ha reproducido.
- Versión 1.0.0 muy reciente (13 de octubre de 2026): espera ajustes y lee las notas de versión antes de actualizar.
- Datos sensibles. Una memoria contiene lo que han dicho tus usuarios. La documentación indica que los spans de modelo llevan los prompts y las respuestas completos en forma de eventos: decide qué puede conservar el backend de trazas. Los banks aíslan a los usuarios, pero el borrado y la retención los tienes que definir tú.
- Dependencia de un modelo. Cada registro llama a un modelo de lenguaje: el coste, la latencia y la calidad de extracción dependen de tu elección, consulta cómo elegir tu LLM.
- Oferta comercial. Hindsight Cloud existe junto al código MIT: comprueba qué queda en la versión autoalojada.
Buenas prácticas
- Un bank por usuario o por inquilino, nunca un bank común para datos privados.
- Usa un modelo local o un proveedor con contrato para la memoria de datos sensibles: consulta la pila de IA de código abierto autoalojada.
- Separa los workers de la API y da nombre a sus servicios en el backend de trazas.
- Crea alertas sobre los tokens de consolidación antes de descubrir la factura.
- Fija un límite al tamaño del contexto y de la memoria recuperada; el artículo sobre la ventana de contexto de los agentes detalla el asunto.
Preguntas frecuentes
¿Sustituye Hindsight a un RAG?
El proyecto afirma superar los límites del RAG y de los grafos de conocimiento; es su propio posicionamiento. En la práctica, ambos se complementan: un RAG consulta documentos, una memoria de agente conserva lo que el agente ha aprendido.
¿Hace falta un proveedor de modelos externo?
No: el README lista Ollama, LM Studio y llama.cpp entre los proveedores admitidos. Una clave de proveedor solo es necesaria para los modelos alojados.
¿Se puede observar Hindsight sin Grafana?
Sí. Las métricas están en formato Prometheus y las trazas en OTLP; la documentación cita Langfuse, OpenLIT, Datadog, New Relic y Honeycomb como destinos posibles.
Conclusión
Hindsight da una memoria persistente a los agentes y la dota de lo necesario para la operación: métricas, trazas GenAI, sondas de salud. Las cifras de precisión siguen siendo afirmaciones del proyecto; lo que sí puedes medir tú mismo es la latencia de recuperación, el gasto en tokens y la tasa de documentos sin memoria. Para un agente que actúa, consulta también OpenClaw.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a los proyectos citados. Las marcas citadas pertenecen a sus propietarios. Las herramientas evolucionan rápido: comprueba los comandos y las opciones en su documentación oficial (hindsight.vectorize.io).