Elegir un LLM en octubre de 2026 fiándose de las clasificaciones públicas equivale a elegir un servidor por su ficha comercial. Los benchmarks miden un modelo aislado, con preguntas que no son las tuyas, sin red, sin cuotas y sin restricciones de localización de los datos. Lo que tumba un servicio en producción está en otra parte: una latencia del primer token que se duplica en las horas punta, un proveedor que trata los datos fuera de la Unión Europea, una instrumentación imposible de conectar a la monitorización existente.
Este artículo propone una cuadrícula de decisión centrada en la operación: latencia, alojamiento, RGPD, observabilidad y coste. No ofrece ninguna clasificación y no cita ningún precio: las tarifas cambian con demasiada frecuencia y deben leerse en las páginas de los proveedores el día de la decisión. Las características citadas proceden de las documentaciones oficiales consultadas en octubre de 2026.
El método propuesto termina con un piloto instrumentado con OpenTelemetry, que compara los modelos candidatos con tus propias consultas. Para el marco general, consulta nuestro artículo principal sobre la observabilidad de la IA.
Por qué los benchmarks no bastan
Un benchmark responde a la pregunta «¿sabe hacerlo este modelo?». La operación plantea otras: ¿responde lo bastante rápido en el percentil 95?, ¿qué ocurre cuando el proveedor limita el caudal?, ¿dónde se tratan los datos?, ¿se puede ver cada llamada en una traza?, ¿cuánto cuesta una tarea completa y no solo un millón de tokens? Dos modelos cercanos en la clasificación pueden tener perfiles de operación muy distintos. Las exigencias SRE de las cargas de IA se aplican desde la elección del modelo.
Elegir un LLM: la cuadrícula de criterios de operación
1. Latencia: primer token, rendimiento, cola de espera
En una interfaz conversacional, el tiempo hasta el primer token (TTFT) cuenta más que la duración total. En un agente que encadena diez llamadas, lo que cuenta es la duración de extremo a extremo. Mide ambas, en el percentil 95, en hora punta.
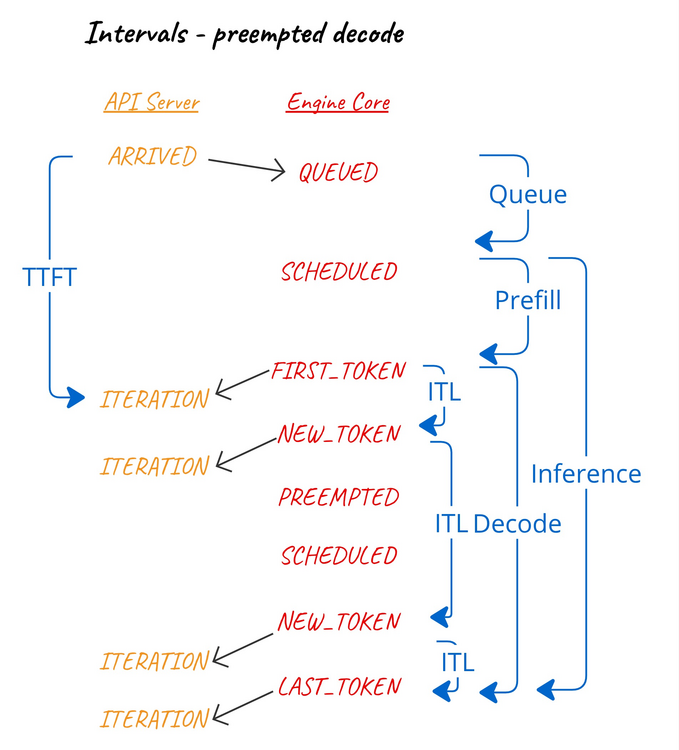
El esquema anterior, tomado de la documentación de diseño de vLLM, muestra lo que contiene un TTFT: cola de espera, prefill y después generación. En un modelo autoalojado, vLLM expone estos intervalos como métricas de Prometheus (vllm:time_to_first_token_seconds, vllm:inter_token_latency_seconds, vllm:request_queue_time_seconds, vllm:e2e_request_latency_seconds). Consulta vLLM en producción.
2. Alojamiento: API, nube o autoalojado
- API del proveedor: nada que operar en el lado de la GPU, pero una dependencia externa con sus cuotas y sus incidentes.
- Modelo a través de un hyperscaler: la región queda fijada por el punto de conexión. La documentación de Anthropic precisa, por ejemplo, que en Amazon Bedrock y Google Cloud la región de inferencia la determina la URL del punto de conexión o el perfil de inferencia.
- Autoalojado: requiere un modelo de pesos abiertos y una licencia compatible. Mistral publica, en su lista de modelos, la licencia de cada uno: Mistral Small 4 y la familia Ministral 3 (3B, 8B, 14B) están bajo Apache 2.0, y Mistral Medium 3.5 bajo una licencia MIT modificada. vLLM sirve estos modelos detrás de un servidor compatible con la API de OpenAI (
vllm serve), y Ollama cubre los usos más ligeros.
3. RGPD y localización de los datos
Los tres proveedores consultados ofrecen controles, con condiciones diferentes:
- Mistral AI: según su centro de ayuda, los datos se alojan por defecto en la Unión Europea; el uso explícito del punto de conexión estadounidense los aloja en Estados Unidos. Algunas funciones pueden transferir temporalmente datos fuera de la UE, hacia los subencargados listados en su Trust Center.
- OpenAI: los controles de residencia de datos son una opción de proyecto, sujeta a elegibilidad ante el equipo comercial. La región Europa (EEE + Suiza) usa
eu.api.openai.com. La documentación menciona un recargo del 10 % en estos puntos de conexión para los modelos elegibles lanzados a partir del 5 de marzo de 2026, y excluye los datos del sistema (cuenta, facturación, estadísticas de uso). - Anthropic: el parámetro
inference_geoelige dónde se ejecuta la inferencia (globalpor defecto, ous), en los modelos Claude 4.6 y posteriores; la geografía de almacenamiento del espacio de trabajo es hoy únicamenteus.
Comprueba estas condiciones en el contrato y en el acuerdo de tratamiento de datos (DPA): una página de documentación no sustituye el criterio de tu DPO.
4. Observabilidad
Un modelo que no se puede trazar es un modelo que no se puede operar. Preguntas que conviene hacerse: ¿existe una instrumentación de OpenTelemetry para su SDK (OpenLLMetry, OpenLIT, instrumentación del framework)? ¿La respuesta de la API devuelve el uso en tokens? Anthropic devuelve incluso, en el objeto usage, un campo inference_geo que indica dónde se ejecutó la inferencia: útil para demostrar la localización. Las convenciones GenAI de OpenTelemetry prevén valores conocidos para gen_ai.provider.name, entre ellos openai, anthropic, mistral, aws.bedrock, gcp.vertex_ai y azure.ai.openai. Por el lado de Dynatrace, la aplicación AI Observability cita OpenAI, Anthropic, Gemini, Amazon Bedrock, Azure AI Foundry y Vertex AI entre las plataformas cubiertas.
5. Coste por tarea, no por token
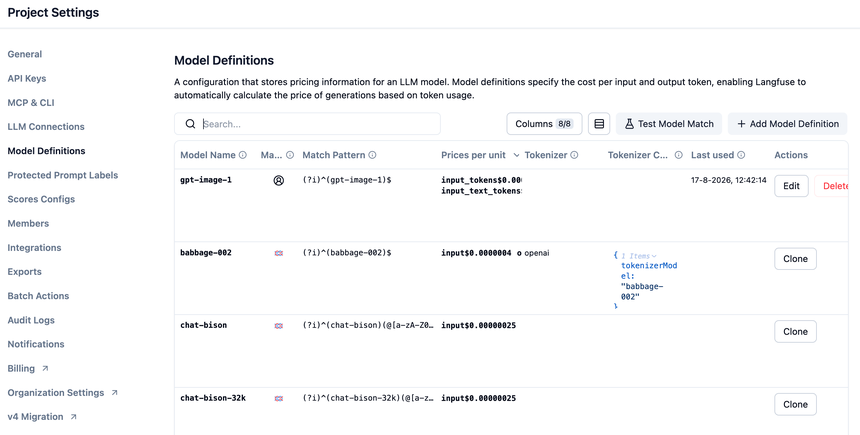
El precio público se expresa por millón de tokens; tu coste real depende del número de tokens que un modelo consume para completar una tarea, de los tokens de razonamiento, de la caché y de los recargos regionales. Una herramienta como Langfuse almacena los precios por modelo en definiciones y calcula el coste de cada generación a partir del uso real.
En la práctica: un piloto instrumentado en cinco pasos
Paso 1: reunir un conjunto de consultas reales
Extrae entre 100 y 300 consultas representativas de tu uso, anonimizadas. Ese es tu propio benchmark.
Paso 2: instrumentar una sola vez
Pasa las consultas por el mismo código, instrumentado con OpenTelemetry, cambiando únicamente el modelo. Cada span lleva gen_ai.request.model, gen_ai.provider.name y gen_ai.usage.input_tokens / output_tokens.
Paso 3: comparar los modelos en Dynatrace SaaS
fetch spans
| filter gen_ai.operation.name == "chat"
| summarize requetes = count(),
            p95 = percentile(duration, 95),
            erreurs = countIf(span.status_code == "error"),
            entree_moy = avg(gen_ai.usage.input_tokens),
            sortie_moy = avg(gen_ai.usage.output_tokens),
            by:{gen_ai.request.model}
Esta consulta DQL es válida para Dynatrace SaaS (Grail). En Dynatrace Managed, sin DQL, haz la misma comparación en una herramienta de código abierto como Langfuse o mediante las métricas de tu pila de Prometheus.
Paso 4: puntuar la calidad
Pide a los usuarios del negocio que revisen una muestra de respuestas, o usa una evaluación automática. Un modelo rápido y barato que responde mal no es una buena elección.
Paso 5: decidir con una cuadrícula ponderada
Asigna un peso a cada criterio según el servicio: cumplimiento eliminatorio para datos de salud, TTFT prioritario para un asistente, coste por tarea prioritario para un procesamiento por lotes. Deja constancia del resultado: la elección habrá que repetirla dentro de seis meses.
Cómo comprobar que el piloto es fiable
- Cada modelo ha recibido el mismo número de consultas (columna
requetes). - Los totales de tokens concuerdan con la consola de uso de cada proveedor.
- Las mediciones se han tomado en varios momentos, incluida la hora punta.
Buenas prácticas
- Mantén una capa de abstracción (API compatible con OpenAI, pasarela) para poder cambiar de modelo sin reescribir la aplicación.
- Prevé un modelo de respaldo y prueba el cambio.
- Fija la versión exacta del modelo en producción; vigila
gen_ai.response.model. - Relee la política de ciclo de vida del proveedor: un modelo retirado obliga a migrar.
- Repite el piloto con cada versión importante nueva.
Preguntas frecuentes
¿Hace falta un modelo autoalojado para cumplir el RGPD?
No. Varios proveedores ofrecen tratamiento en Europa, bajo ciertas condiciones. El autoalojamiento da el control total, pero traspasa la operación de las GPU a tu equipo: consulta una pila de IA autoalojada.
¿Por qué no dar precios?
Porque cambian a menudo y dependen de la región, de la caché y del volumen. Mide el coste por tarea durante el piloto, con los precios del día.
¿Cuántos modelos conviene comparar?
Dos o tres bastan: un modelo puntero, un modelo más ligero y, si los datos lo exigen, un modelo de pesos abiertos autoalojado.
Conclusión
Elegir un LLM es elegir un componente de producción. La latencia en el percentil 95, la localización de los datos, la capacidad de trazar cada llamada y el coste por tarea deciden con más seguridad que el puesto en una clasificación. Un piloto instrumentado con OpenTelemetry, con tus propias consultas, convierte esa elección en una decisión medida y fácil de repetir.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a los proyectos o proveedores citados. Las marcas citadas pertenecen a sus propietarios. Las ofertas evolucionan rápido: comprueba las condiciones y opciones en su documentación oficial.