El coste de un agente de IA no se lee en la factura del proveedor de modelos. La factura llega a final de mes, agregada por clave de API, sin decir qué agente, qué herramienta o qué bucle de razonamiento ha consumido los tokens. Para un equipo de explotación es demasiado tarde y demasiado difuso: un agente que vuelve a llamar diez veces a la misma herramienta cuesta caro mucho antes de que alguien lo note.
La respuesta es la misma que para cualquier servicio: instrumentar, medir, alertar. Las convenciones semánticas de OpenTelemetry para la IA generativa (atributos y métricas gen_ai.*) dan un vocabulario común para contar los tokens, las llamadas a herramientas y la latencia de cada invocación de un agente. Una vez disponibles esos datos, el coste se convierte en un indicador de explotación como cualquier otro, con su dashboard y su umbral de alerta.
Este artículo describe qué medir, con qué nombres, y cómo seguirlo en Dynatrace SaaS o en una pila de código abierto. Completa nuestro artículo pilar sobre la observabilidad de la IA y el enfoque orientado al valor de medir el ROI de la IA: aquí hablamos del lado de los gastos y la fiabilidad, no del de los beneficios.
Coste de un agente de IA: los tres componentes que medir
Un agente de IA encadena llamadas al modelo y llamadas a herramientas hasta producir una respuesta. Su coste real se descompone en tres partes:
- Los tokens: tokens de entrada (prompt, historial, resultados de herramientas reinyectados) y tokens de salida. Es la parte que factura el proveedor. Los tokens de entrada crecen en cada vuelta del bucle, porque el contexto se acumula.
- Las llamadas a herramientas: cada llamada cuesta tiempo, a veces dinero (API de pago, consulta a una base de datos) y sobre todo una nueva vuelta del modelo para aprovechar el resultado. El número de llamadas por invocación es la mejor señal de un agente que da vueltas en círculo.
- La latencia: un agente lento inmoviliza recursos (workers, conexiones, GPU si el modelo está autoalojado) y degrada la experiencia. La latencia forma parte del coste de explotación, aunque no aparezca en ninguna factura.
Lo que dicen las convenciones GenAI de OpenTelemetry
Las convenciones GenAI tienen el estado Development: los nombres aún pueden cambiar. Han salido del repositorio principal de convenciones semánticas (la página indica allí «Moved» desde la versión 1.42.0) hacia un repositorio dedicado, semantic-conventions-genai, que todavía no ha publicado ninguna versión. Hay que distinguir, pues, lo que se emite hoy de lo que está por llegar.
En los spans: los atributos que aprovechar desde ya
gen_ai.usage.input_tokensygen_ai.usage.output_tokens(enteros): tokens consumidos por la llamada. La convención precisa que los tokens de entrada incluyen los tokens servidos desde la caché del proveedor.gen_ai.request.model,gen_ai.response.modelygen_ai.provider.name: para desglosar el coste por modelo y por proveedor.gen_ai.operation.name:chat,invoke_agent,execute_tool… Un span de llamada a herramienta llevagen_ai.tool.name(obligatorio) y se llamaexecute_tool {gen_ai.tool.name}.gen_ai.agent.nameygen_ai.conversation.id: para agrupar por agente y por conversación.
En las métricas: lo existente y la nueva generación
En la última versión publicada que las contenía (v1.41.1), la métrica de tokens es gen_ai.client.token.usage, un histograma en {token} desglosado por el atributo gen_ai.token.type (input u output). Es la que emite hoy OpenLLMetry, por ejemplo. La latencia de una llamada se mide con gen_ai.client.operation.duration, un histograma en segundos.
El nuevo repositorio sustituye gen_ai.client.token.usage por contadores separados, gen_ai.client.inference.usage.input_tokens y gen_ai.client.inference.usage.output_tokens, presentados como los instrumentos de referencia para aproximar el coste. Añade métricas propias de los agentes: gen_ai.invoke_agent.duration (segundos), gen_ai.invoke_agent.inference_calls, gen_ai.invoke_agent.tool_calls y gen_ai.execute_tool.duration. Mientras no haya una versión publicada, comprueba lo que tu instrumentación emite realmente antes de construir alertas sobre ello.
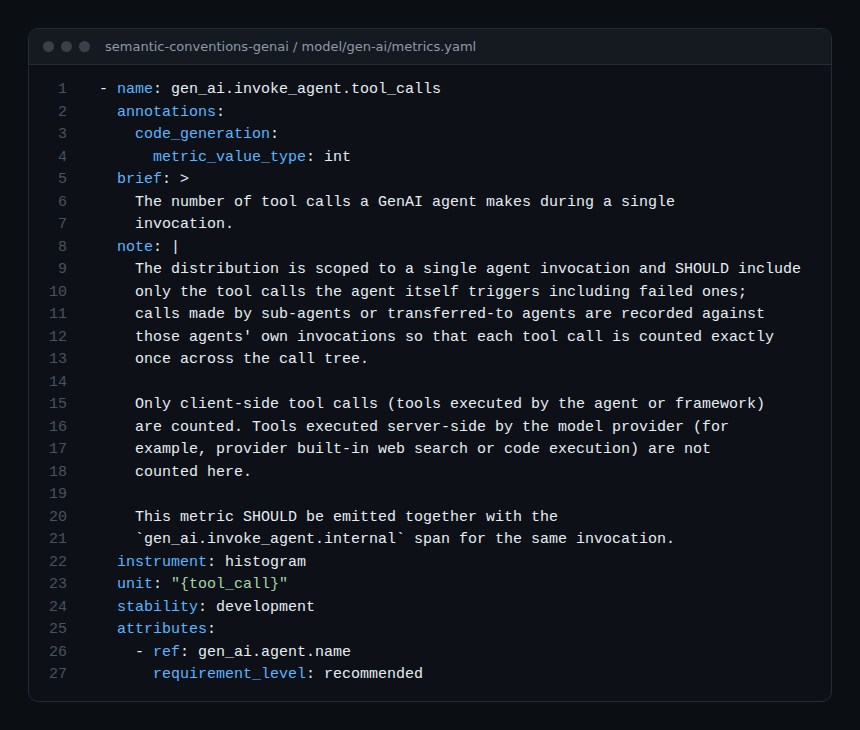
La definición anterior precisa un punto útil para el presupuesto: solo se cuentan las herramientas ejecutadas en el lado del cliente, no las ejecutadas por el proveedor (búsqueda web integrada, por ejemplo), y cada llamada se cuenta una sola vez en el árbol de subagentes.
En la práctica: seguir el coste de un agente de IA
Paso 1: verificar los atributos emitidos
Tanto si el agente está instrumentado con una biblioteca (OpenLLMetry, OpenLIT, la instrumentación de un framework) como a mano, abre una traza y comprueba la presencia de los atributos gen_ai.usage.*, gen_ai.request.model y gen_ai.tool.name. Sin ellos no es posible ningún cálculo de coste.
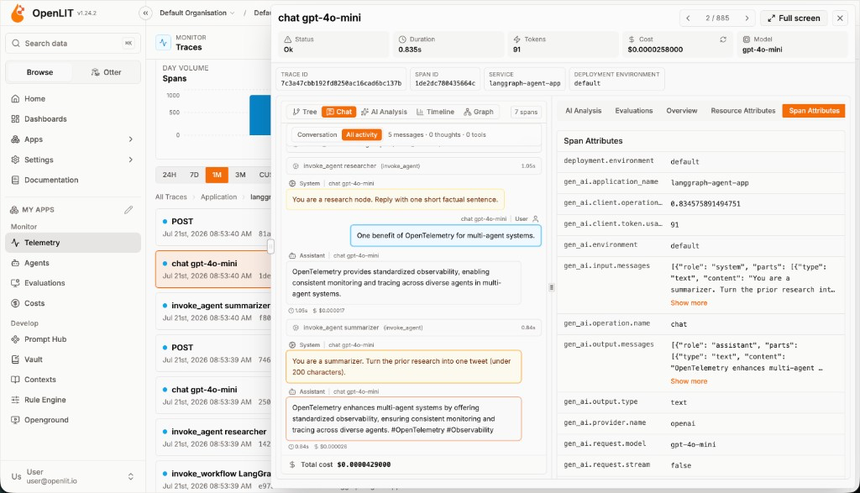
Si instrumentas a mano, la documentación de Dynatrace da el ejemplo de un span cliente que rellena estos atributos a partir de la respuesta del proveedor:
with tracer.start_as_current_span("chat gpt-5", kind=SpanKind.CLIENT) as span:
    span.set_attribute("gen_ai.operation.name", "chat")
    span.set_attribute("gen_ai.provider.name", "openai")
    span.set_attribute("gen_ai.request.model", "gpt-5.2")
    response = openai_client.chat.completions.create(...)
    span.set_attribute("gen_ai.response.model", response.model)
    span.set_attribute("gen_ai.usage.input_tokens", response.usage.prompt_tokens)
    span.set_attribute("gen_ai.usage.output_tokens", response.usage.completion_tokens)
Paso 2: enviar los datos a Dynatrace SaaS
La guía OpenTelemetry y AI Observability exige una licencia Dynatrace Platform Subscription con Traces, Metrics y Log Analytics powered by Grail, y un token con los scopes openpipeline:traces:ingest, openpipeline:metrics:ingest y openpipeline:logs:ingest (o, con token clásico, openTelemetryTrace.ingest, metrics.ingest y logs.ingest). Las trazas salen hacia https://<environnement>.live.dynatrace.com/api/v2/otlp/v1/traces. Para configurar un Collector intermedio, consulta Langfuse y OpenLLMetry.
Este recorrido vale para Dynatrace SaaS: la aplicación AI Observability y las consultas DQL se apoyan en Grail. En Dynatrace Managed no hay Grail ni DQL; la vía de código abierto descrita más abajo sigue siendo aplicable.
Paso 3: contar los tokens por modelo con DQL
fetch spans
| filter isNotNull(gen_ai.usage.input_tokens)
| makeTimeseries entree = sum(gen_ai.usage.input_tokens),
                 sortie = sum(gen_ai.usage.output_tokens),
                 by:{gen_ai.request.model}, interval:1h
Una curva de entrada que sube más deprisa que el número de peticiones señala un contexto que se hincha: historial que nunca se trunca, resultados de herramientas demasiado voluminosos que se reinyectan.
Paso 4: localizar las herramientas costosas y los bucles
fetch spans
| filter gen_ai.operation.name == "execute_tool"
| summarize appels = count(), p95 = percentile(duration, 95), by:{gen_ai.tool.name}
| sort appels desc
fetch spans
| filter gen_ai.operation.name == "execute_tool"
| summarize outils = count(), by:{trace.id}
| summarize p95_outils = percentile(outils, 95), max_outils = max(outils)La segunda consulta aproxima el número de llamadas a herramientas por petición. Un máximo muy alejado del percentil 95 señala las trazas que conviene abrir primero.
Paso 5: dashboard y alertas de presupuesto
En la aplicación AI Observability, la pestaña Overview resume la actividad (peticiones LLM, consumo de tokens, tendencia de costes) y la pestaña Explorer desglosa peticiones, tokens, duración media y coste por proveedor, modelo, servicio o agente. La documentación indica que se crea una alerta con New alert en los tiles basados en métricas, como Token count o Token usage forecast; el asistente se abre rellenado con el ámbito actual. Cuidado: algunos dashboards listos para usar consultan los spans y consumen Traces powered by Grail – Query, incluso sin datos; prefiere los tiles basados en métricas.
Fija el umbral a partir del presupuesto, no por intuición: el presupuesto mensual de tokens dividido por el número de días da un tope diario, y la previsión de consumo avisa antes de que se supere.
Paso 6: la vía de código abierto
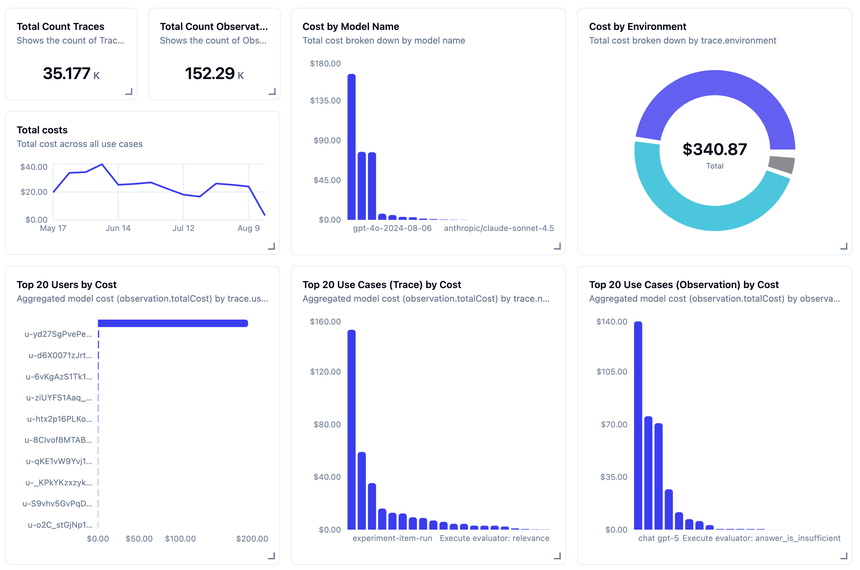
Sin Dynatrace, la misma instrumentación alimenta una herramienta de ingeniería LLM. Langfuse calcula el precio de cada generación a partir de definiciones de modelos (precio por token de entrada y de salida) y ofrece dashboards de coste por modelo, por entorno, por usuario y por caso de uso.
Cómo comprobar que funciona
- Una petición de prueba al agente produce una traza que contiene un span
invoke_agent, spanschatcongen_ai.usage.input_tokensrellenado y spansexecute_tool. - La consulta DQL del paso 3 devuelve una serie por modelo; el total de un día es coherente con el panel de uso de la consola del proveedor.
- Una alerta de prueba, con un umbral deliberadamente bajo, dispara efectivamente una notificación.
Buenas prácticas
- Desglosa siempre por agente y por modelo: un coste global no dice qué corregir.
- Limita el número de vueltas y de llamadas a herramientas en el código del agente; la métrica solo revela el problema.
- Relaciona el coste con un resultado (ticket resuelto, respuesta aceptada): es el vínculo con el ROI.
- Fija la versión de las instrumentaciones: los nombres
gen_ai.*aún evolucionan. - Trata una deriva de coste como un incidente, sin buscar culpables: cambio de prompt, modelo nuevo, herramienta lenta.
Preguntas frecuentes
¿Bastan los tokens para conocer el coste de un agente de IA?
Dan la parte que factura el proveedor. Añade las llamadas a herramientas de pago y el tiempo de ejecución para obtener el coste de explotación completo.
¿Hay que usar gen_ai.client.token.usage o los nuevos contadores?
Usa lo que tu instrumentación emite hoy, casi siempre gen_ai.client.token.usage, y prevé la migración cuando el repositorio GenAI publique una versión. Los atributos de span gen_ai.usage.* siguen siendo la base más estable para las consultas.
¿Funciona con un modelo autoalojado?
Sí para los tokens y la latencia en el lado del cliente. El coste pasa entonces a ser el de la infraestructura: consulta las métricas de vLLM en producción y la observación de los agentes MCP.
Conclusión
Medir el coste de un agente de IA es contar los tokens, las llamadas a herramientas y la latencia con un vocabulario estándar, y colocarlos después en un dashboard y detrás de una alerta. Las convenciones GenAI de OpenTelemetry aportan los nombres; Dynatrace SaaS o una pila de código abierto aportan la vista. El presupuesto deja entonces de ser una sorpresa de fin de mes para convertirse en un indicador que se sigue a diario.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a los proyectos citados. Las marcas citadas pertenecen a sus propietarios. Las herramientas evolucionan rápido: comprueba siempre los comandos y las opciones en su documentación oficial.