
¿Tu factura de logs se duplica cada trimestre y casi nadie lee lo que guardas? Con las etiquetas de Loki, Grafana Labs apuesta por lo contrario que un motor de texto completo: indexar solo unas pocas etiquetas por flujo y buscar el resto en el momento de leer. El repositorio grafana/loki mostraba unas 29 200 estrellas el 11 de noviembre de 2026 y se distribuye con licencia AGPL-3.0.
Esa decisión abarata el almacenamiento, pero te exige disciplina. Aquí partimos de la decisión de operación: qué etiquetas conservar, cuáles rechazar y qué hacer con los valores que cambian todo el rato. Los datos proceden de la documentación oficial y del repositorio, consultados el 11 de noviembre de 2026.
Una aclaración: span.observer no ha desplegado Loki para este artículo. Las dos capturas son fragmentos de ejemplo escritos por nosotros, sin ejecutar. Para situar Loki dentro de una pila completa, consulta nuestra comparativa entre Dynatrace y Grafana.
Por qué las etiquetas de Loki abaratan los logs
Un motor de texto completo construye un índice sobre el contenido de cada línea. Ese índice crece con el volumen y hay que almacenarlo y mantenerlo en memoria. Loki, según su documentación, no indexa el contenido de los logs: solo guarda metadatos en forma de etiquetas (labels) por flujo.
- Un flujo (stream) es la combinación única de todos los pares clave-valor de etiquetas.
- Las líneas de cada flujo se comprimen y se agrupan en chunks, que viven en un almacenamiento de objetos como S3 o GCS.
- El índice solo indica dónde están los chunks de un conjunto de etiquetas.
El almacenamiento de objetos es el único lugar donde se guardan los datos, así que Loki hereda su coste y su fiabilidad frente a los discos locales. Cuando el volumen crece, el ahorro viene de un índice pequeño y de chunks comprimidos.
El peaje se paga al leer. Loki primero localiza un flujo mediante las etiquetas y después recorre sus líneas. Una consulta incapaz de acotar los flujos acaba leyendo muchísimos datos.
La decisión: ¿qué etiquetas asignar a un flujo?
Todo gira en torno a la cardinalidad, es decir, el número de combinaciones únicas de etiquetas y valores. La documentación advierte de que una cardinalidad alta obliga a Loki a construir un índice enorme y a escribir miles de chunks diminutos en el almacenamiento de objetos. Cada valor nuevo de una etiqueta crea un flujo nuevo.
Esta es la clasificación que propongo, siguiendo las recomendaciones de la documentación.
- Conserva los valores estables y acotados: región, clúster, namespace, aplicación, entorno. Una etiqueta de host con 1000 valores sigue siendo aceptable.
- Rechaza los valores efímeros: identificadores de traza, de pedido o de petición, direcciones IP, marcas de tiempo.
- Rechaza las etiquetas que nadie consulta: engordan el índice y fragmentan los flujos sin motivo.
- Desconfía de
levelcomo etiqueta dinámica: un filtro|= "level=error"suele ser igual de rápido y no parte los flujos.
Hay órdenes de magnitud de referencia. Las etiquetas dinámicas deberían tener pocos valores, quizá unas decenas. Loki aplica por defecto un máximo de 15 etiquetas de índice, y la documentación aconseja no pasar de 10 a 15 etiquetas personalizadas.
El caso que duele: el identificador de petición como etiqueta
La documentación incluye un ejemplo muy claro. Un análisis con logcli series --analyze-labels mostraba una etiqueta requestId con 24 653 valores para 24 979 flujos. La guía la define como «el ejemplo perfecto de lo que no debe ser una etiqueta».
La solución pasa por quitar la etiqueta y filtrar dentro de la línea, por ejemplo con |= "requestId=32422355". El flujo vuelve a ser único, los chunks se llenan y la búsqueda sigue siendo razonable si el selector es preciso.
Hay un segundo efecto menos visible. Con demasiados flujos, los chunks se escriben antes de llenarse, por inactividad o por antigüedad máxima, y el resultado es una multitud de chunks pequeños. La métrica loki_ingester_chunks_flushed_total, agrupada por reason, indica por qué se envían.
Otra restricción que conviene conocer: dentro de un flujo, las entradas deben llegar en orden, con una ventana de dos horas por defecto. Pasado ese margen, Loki rechaza la línea con un error «too far behind». Separar dos orígenes con etiquetas distintas evita mezclarlos en un mismo flujo.
Structured metadata: conservar el valor sin indexarlo
¿Qué haces con un identificador de pod, de hilo o de proceso, útil pero nunca lo bastante estable para ser etiqueta? La documentación propone la structured metadata: metadatos adjuntos a la línea, sin índice y sin meterlos en el texto. Se recomienda sobre todo para datos de OpenTelemetry recibidos mediante Grafana Alloy o un OpenTelemetry Collector. Sobre Alloy, mira el artículo sobre el colector que sustituye a Promtail.
Tiene requisitos concretos:
- un esquema de versión 13 o superior (formato de chunk V4);
- el índice
tsdb: el antiguoboltdb-shipper, obsoleto, no la admite; allow_structured_metadata: truedentro delimits_config.
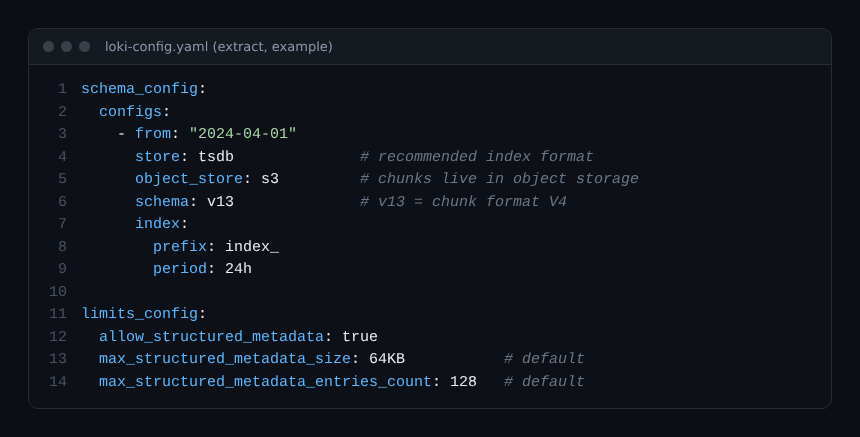
Los límites por defecto son 64 KB y 128 entradas por línea. Si se superan, la línea se rechaza con un error HTTP 400. Al leer, esos valores aparecen como etiquetas del resultado y se filtran igual. Ojo: en una consulta de métricas pueden disparar el número de series. Los pasos keep o drop eliminan lo que sobra.
La documentación que he leído no dice en qué versión de Loki apareció la función, así que no lo afirmo.
Consultar con LogQL
Una consulta LogQL tiene dos partes: un selector de flujo obligatorio y, después, una tubería opcional. El selector usa los operadores =, !=, =~ y !~. La tubería encadena filtros de línea (|=, !=, |~), analizadores como json o logfmt y, por último, filtros sobre los campos extraídos.
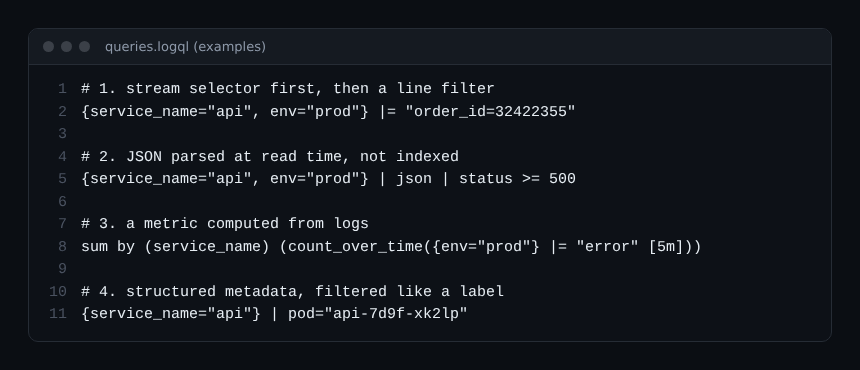
La regla práctica: primero un selector estrecho, luego un filtro de línea y al final un analizador. El analizador sale caro cuando hay muchas líneas; el selector, no. Si quieres ver otro enfoque para analizar logs, mira el análisis de patrones de logs.
Licencia AGPL-3.0: qué te impone
El README del repositorio indica que Loki se distribuye bajo AGPL-3.0-only, y el archivo LICENSE contiene el texto de la GNU Affero General Public License, versión 3. No he encontrado ninguna excepción en ese archivo.
La peculiaridad de la AGPL es su sección 13: si modificas el software y otros usuarios interactúan con él a distancia, debes ofrecerles el código fuente de tu versión modificada. Para un uso interno sin modificaciones, la obligación suele considerarse ligera. Esta lectura no es asesoramiento jurídico: que validen tu caso, sobre todo si modificas Loki o lo ofreces como servicio. No he comprobado las condiciones de las ofertas comerciales de Grafana Labs.
Buenas prácticas
- Haz una lista de las etiquetas que tus consultas usan de verdad y elimina las demás.
- Mide la cardinalidad antes de pasar a producción con
logcli series --analyze-labels. - Pasa los valores de cardinalidad alta a structured metadata, tras revisar el esquema y el índice.
- Vigila los motivos de vaciado de los chunks y el número de flujos activos por tenant.
- Mantén consultas con selector estrecho: es lo que acota el coste de lectura.
- Relee la licencia AGPL antes de modificar el código o exponerlo a terceros.
Preguntas frecuentes
¿Es Loki realmente más barato que un motor de texto completo?
La documentación lo afirma para la operación, gracias a un índice pequeño y a chunks comprimidos en almacenamiento de objetos. Yo no he medido ese ahorro: depende de tu volumen, de tus etiquetas y de tus consultas.
¿Se puede buscar un valor que no sea una etiqueta?
Sí, con un filtro de línea, con un analizador o mediante structured metadata. La búsqueda recorre entonces las líneas de los flujos seleccionados, de modo que un selector preciso sigue siendo imprescindible.
¿Qué límite no conviene superar?
Como referencia para tenants muy grandes, la documentación menciona menos de 100 000 flujos activos y menos de 1 millón de flujos en 24 horas. Un tenant más pequeño debería quedarse proporcionalmente por debajo.
Conclusión
Loki abarata los logs si aceptas una regla sencilla: pocas etiquetas, estables y elegidas pensando en las consultas. Lo que varía va en la línea o en la structured metadata. Repositorio y documentación: grafana/loki y grafana.com/docs/loki.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Grafana Labs. Las marcas citadas pertenecen a sus propietarios. Las herramientas cambian deprisa: comprueba siempre los comandos y las opciones en la documentación oficial correspondiente a tu versión.