
La cardinalidad de métricas no se ve en un dashboard: se ve en la factura del mes siguiente, o en un Prometheus que se reinicia en bucle por falta de memoria. Esta guía parte de una decisión de operación muy concreta: antes de que un equipo despliegue una métrica nueva, ¿qué hay que comprobar?, y ¿cómo se detecta una serie que se dispara cuando ya está en producción?
El método son cuatro gestos: calcular el coste de una métrica antes de entregarla, auditar un bloque de datos con promtool, alertar sobre el ritmo de creación de series y, por último, poner un tope en origen, dentro del SDK de OpenTelemetry. Complementa la guía sobre la cardinalidad de métricas en Kubernetes, centrada en la API de la TSDB y kube-state-metrics, y no la repite.
En resumen
- El número de series de una métrica es, como máximo, el producto de los valores posibles de cada label: se calcula antes de llegar a producción.
promtool tsdb analyzeaudita un bloque sin conexión y ordena los labels más costosos.scrape_series_addedsirve para alertar sobre series nuevas, ypromtool test rulesprueba la alerta sin necesidad de un servidor.- El SDK de OpenTelemetry puede filtrar atributos (
attribute_keys) y limitar los puntos, con un punto de desbordamiento.
Calcular la cardinalidad de métricas antes de la revisión de código
La documentación de Prometheus sobre buenas prácticas de instrumentación recomienda mantener la cardinalidad de una métrica por debajo de 10 y, si la supera, limitarla a un puñado de métricas en todo el sistema. Si una métrica pasa de 100, sugiere buscar otra solución. Son referencias, no prohibiciones, pero dan un orden de magnitud útil durante la revisión.
La cuenta es sencilla. Una métrica con los labels route (4 valores), status (3 valores) y user_id (1 000 valores) puede llegar a 4 × 3 × 1 000 = 12 000 series. Todo el coste lo pone el tercer label. Por eso conviene añadir una pregunta a la plantilla de pull request: ¿qué valores puede tomar cada label y qué acota su número?
La página de nomenclatura de Prometheus es explícita: no guardes en labels dimensiones de cardinalidad alta, como identificadores de usuario o direcciones de correo. Un identificador va en una traza o en un log, no en una métrica.
Auditar un bloque con promtool tsdb analyze
La API de estado de la TSDB consulta el servidor en marcha. promtool ofrece la otra opción: analizar un directorio de datos, por ejemplo la copia de un bloque sacada de un servidor o una instantánea, sin cargar la producción. El comando es tsdb analyze y su descripción oficial dice «Analyze churn, label pair cardinality and compaction efficiency».
Para que el ejemplo sea reproducible, preparé un conjunto de datos de laboratorio: una métrica http_requests_total con 12 series legítimas (4 rutas, 3 estados) y 400 series que llevan además un label user_id. El archivo OpenMetrics se convierte en bloques y después se analiza.
promtool tsdb create-blocks-from openmetrics m.om ./db
promtool tsdb analyze ./db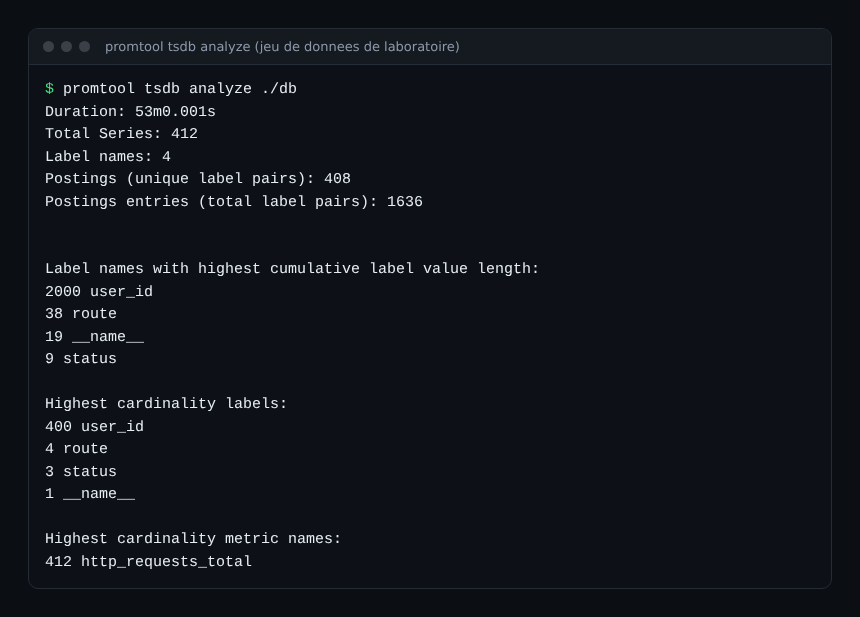
La salida se lee de abajo arriba. «Highest cardinality metric names» señala la métrica culpable, «Highest cardinality labels» el label (aquí user_id, con 400 valores frente a 4 de route), y «Label names with highest cumulative label value length» indica adónde se va la memoria, porque la longitud de los valores también cuenta. El mismo resultado incluye «Label pairs most involved in churning», útil para localizar valores que nacen y mueren sin parar. En mi conjunto todo vale 0: los datos son estables, algo que no ocurre en un clúster que se redespliega a menudo.
Detectar series que se disparan con scrape_series_added
Una auditoría puntual no basta: la explosión llega tras un despliegue, un jueves a las 17:00. Prometheus genera series de diagnóstico en cada scrape. Según la documentación «Jobs and instances», scrape_series_added es el número aproximado de series nuevas en ese scrape, scrape_samples_scraped el de muestras que expone el objetivo y scrape_samples_post_metric_relabeling las que quedan tras el relabeling.
Un job sano crea pocas series nuevas en cada scrape, salvo durante los redespliegues. Una alerta sobre esta señal avisa antes de que la memoria se agote:
groups:
  - name: cardinalite
    rules:
      - alert: SeriesNouvellesParScrape
        expr: scrape_series_added > 500
        for: 10m
        labels:
          severity: warning
El umbral de 500 es solo un ejemplo: mide el nivel normal de tus jobs antes de fijarlo. Después prueba la regla sin servidor, con un archivo de test que inyecta valores:
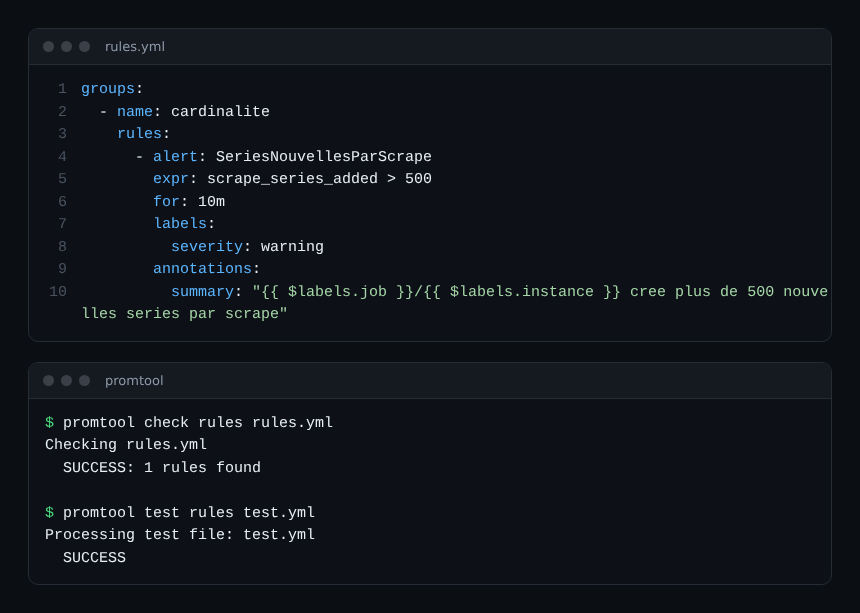
El test inyecta la serie scrape_series_added con valor 10 durante cinco minutos, luego con 900, y comprueba que la alerta está activa a los 30 minutos. Una alerta que nunca se ha probado es una apuesta, sobre todo con una cláusula for.
Limitar la cardinalidad de métricas en origen con OpenTelemetry
Corregir en Prometheus es reaccionar. El SDK de OpenTelemetry permite decidir antes de exportar. La especificación del SDK de métricas define un límite de cardinalidad de agregación: si no se indica otro valor, se usa 2 000. Por encima, las mediciones van a un conjunto de desbordamiento con el atributo booleano otel.metric.overflow en true. Una View también puede fijar aggregation_cardinality_limit para un instrumento, o filtrar atributos con attribute_keys. Según la especificación, el límite se aplica después del filtrado: filtrar primero evita llegar al tope.
Comprobé el comportamiento con el SDK de Python (opentelemetry-sdk 1.45.2): un contador recibe 3 000 mediciones, cada una con un atributo user.id distinto.
View(instrument_name="app.requests", attribute_keys={"http.route"})
View(instrument_name="app.requests", aggregation_cardinality_limit=100)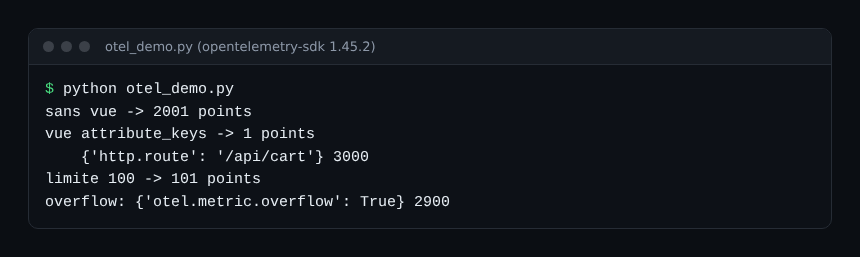
Sin vista se obtienen 2 001 puntos: el límite por defecto de 2 000 más el punto de desbordamiento. Con attribute_keys queda un solo punto, con todas las mediciones acumuladas (3 000). Con un límite de 100 salen 101 puntos y el desbordamiento acumula las 2 900 mediciones restantes. El desbordamiento no pierde el total, pierde el detalle. El tope limita los daños, pero solo eliminar el atributo resuelve el problema. No he verificado estas opciones en otros lenguajes: su disponibilidad depende del SDK.
Para situar ambos ecosistemas el uno respecto al otro, consulta OpenTelemetry y Prometheus, dos herramientas complementarias.
Buenas prácticas: una guardia de revisión en cinco líneas
- Listar en la pull request los valores posibles de cada label y multiplicar.
- Rechazar cualquier identificador (usuario, petición, sesión) como label o atributo de métrica.
- Poner
sample_limiten los jobs, sabiendo que al superarlo falla el scrape completo. - Alertar sobre
scrape_series_addedy probar la regla conpromtool test rules. - Repetir
promtool tsdb analyzecada trimestre sobre un bloque reciente.
El mismo razonamiento vale para los logs: el artículo sobre los labels y la cardinalidad en Loki describe el equivalente en el índice de logs, y el de las métricas custom de Datadog muestra cómo calcula la facturación un proveedor. En el plano operativo, la alerta sobre nodos, pods y cuotas sigue siendo un asunto aparte.
Fuentes: buenas prácticas de instrumentación de Prometheus, especificación del SDK de métricas de OpenTelemetry.
Preguntas frecuentes
¿Qué cardinalidad es aceptable para una métrica?
La documentación de Prometheus da referencias: menos de 10 valores por métrica, solo unas pocas por encima, y replantear las dimensiones más allá de 100. El umbral correcto depende de tu presupuesto de series, que hay que medir.
¿Qué ocurre cuando se alcanza el límite del SDK de OpenTelemetry?
Las combinaciones de atributos nuevas se agregan en un único punto con otel.metric.overflow=true. El total sigue siendo exacto, pero se pierde el detalle por atributo de esas mediciones.
¿Conviene usar sample_limit como protección?
Es una red de seguridad útil, pero drástica: según la documentación, si el número de muestras tras el relabeling supera el límite, el scrape completo se considera fallido. Lo mejor es combinarlo con la alerta sobre series nuevas.
Conclusión
Dominar la cardinalidad de métricas consiste en adelantar el control: calcular en la revisión, auditar con promtool, alertar sobre el ritmo de creación y poner tope en el SDK. Los resultados mostrados proceden de un conjunto de laboratorio, no de un entorno de producción: repite las mediciones con tus propios datos antes de fijar umbrales.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.