La elección entre NeMo Guardrails vs Guardrails AI suele decidirse por la API, pero un equipo SRE o de plataforma lo mira de otro modo: ¿qué se ve de cada guardarraíl una vez en producción? Las dos bibliotecas son de código abierto con licencia Apache 2.0 y se interponen entre la aplicación y el modelo. Sin embargo, no exponen las mismas señales de OpenTelemetry ni con el mismo nivel de madurez.
Este artículo no compara la calidad de detección, que ninguna fuente oficial permite zanjar aquí. Lee la documentación y el código de los dos repositorios para responder a tres preguntas de operación: qué spans y qué métricas salen, cómo relacionar un bloqueo con una petición y qué datos sensibles pueden viajar hacia el backend. Para el marco general de los controles, consulta el panorama de los guardarraíles de agentes de IA en producción.
Las versiones leídas: el README de NeMo Guardrails indica la versión publicada 0.24.1, mientras la rama de desarrollo muestra 0.25.0-rc1 en pyproject.toml; Guardrails AI está en 0.11.0 en su pyproject.toml (repositorios consultados el 31 de octubre de 2026). El contenido es válido con cualquier backend de OpenTelemetry, incluidos Dynatrace SaaS y Dynatrace Managed, sin una integración específica documentada por estos proyectos.
NeMo Guardrails vs Guardrails AI: dos modelos de integración
NeMo Guardrails se describe como una caja de herramientas de guardarraíles programables entre el código de la aplicación y el LLM. Se configura en una carpeta de configuración (archivo config.yml, rails de entrada, de salida y de diálogo) y después se llama a LLMRails o, para el nuevo motor, a Guardrails. También puede ejecutarse como servidor (nemoguardrails server).
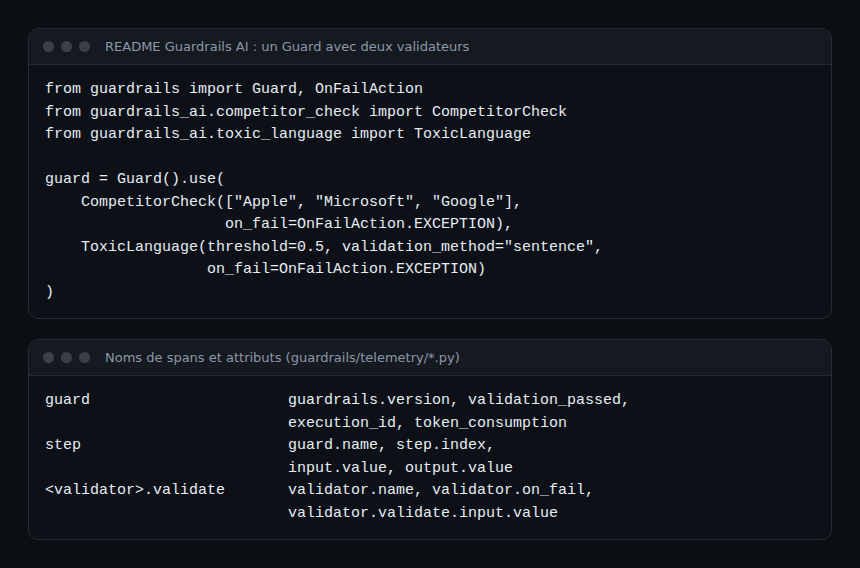
Guardrails AI se presenta como un framework de Python que ejecuta Guards de entrada y de salida y que también sabe producir datos estructurados. Se construye un objeto Guard en código y se le añaden validadores con .use(); cada validador elige una acción ante un fallo mediante OnFailAction (reask, fix, filter, refrain, noop, exception, fix_reask, custom, según el código fuente).
La consecuencia para la operación es simple. Con NeMo Guardrails, la política vive en archivos versionables, revisados como cualquier configuración. Con Guardrails AI, vive en el código Python de la aplicación: un cambio de umbral pasa por un despliegue.
Trazas: lo que emite cada biblioteca
NeMo Guardrails
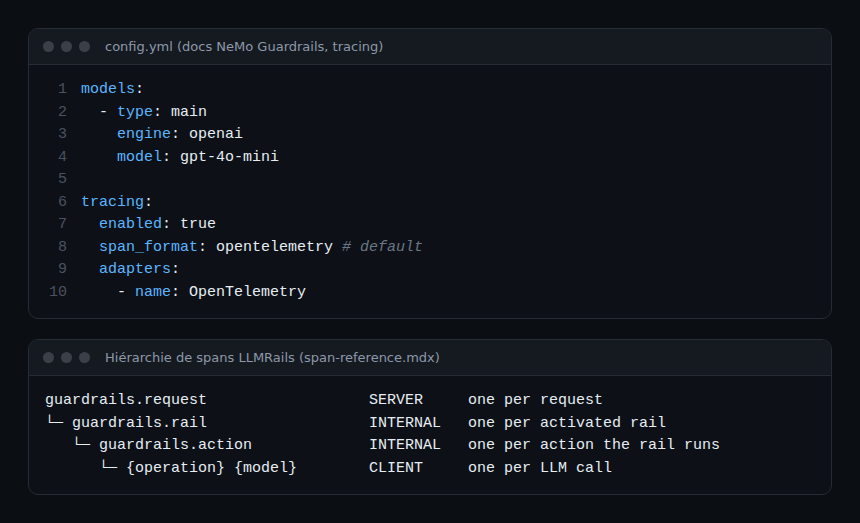
El tracing requiere el extra tracing (pip install nemoguardrails[tracing]), el SDK de OpenTelemetry configurado por la aplicación y un bloque tracing en la configuración. La biblioteca solo depende de la API de OpenTelemetry: sin un TracerProvider, los spans se ignoran en silencio, como precisa la documentación.
El motor por defecto, LLMRails, produce un árbol por petición: guardrails.request (SERVER), luego un span guardrails.rail por cada rail activado, un guardrails.action por acción y un span CLIENT por llamada al LLM. Los atributos útiles para un SRE son rail.type, rail.name, rail.stop y rail.decisions, además de los atributos GenAI de la llamada (gen_ai.usage.input_tokens, gen_ai.usage.output_tokens, gen_ai.request.model). Una petición bloqueada se localiza, por tanto, mediante rail.stop.
Un detalle que conviene conocer: LLMRails reconstruye sus spans después de terminar la petición, a partir del registro de interacción. Las duraciones reflejan el desarrollo real, pero los spans no existen durante la ejecución. El motor opt-in IORails, en cambio, crea los spans durante la petición; la documentación lo califica de función experimental cuyos nombres pueden cambiar.
Guardrails AI
El módulo guardrails/telemetry crea un span guard por llamada, un span step por iteración y un span <nombre del validador>.validate por validación, con el tracer llamado guardrails-ai. Los atributos incluyen validation_passed, validator.name y validator.on_fail. El código expone además un ajuste disable_tracing.
Para la exportación, una función default_otlp_tracer envía los spans por OTLP/HTTP cuando están definidos OTEL_EXPORTER_OTLP_PROTOCOL y un endpoint (OTEL_EXPORTER_OTLP_ENDPOINT u OTEL_EXPORTER_OTLP_TRACES_ENDPOINT); si no, escribe en la consola (stderr). Una aplicación que ya configura su propio TracerProvider puede prescindir de ella: el código obtiene el tracer mediante trace.get_tracer.
Métricas: la diferencia más clara
NeMo Guardrails documenta un catálogo de métricas de OpenTelemetry, con una reserva importante: solo existen en el motor IORails, experimental, y LLMRails no emite ninguna. Activación: metrics.enabled: true y un MeterProvider configurado antes de crear el motor. La página de referencia enumera, entre otras:
guardrails.requests.blocked(contador, etiquetarail.typecon valorInputuOutput): la base de una tasa de bloqueo;guardrails.request.duration(histograma en segundos, con límites de 5 ms a 10 s);guardrails.requests.errorscon la etiquetaerror.type;- métricas de saturación: cola de admisión, peticiones activas, rechazos (
guardrails.nonstream.rejections).
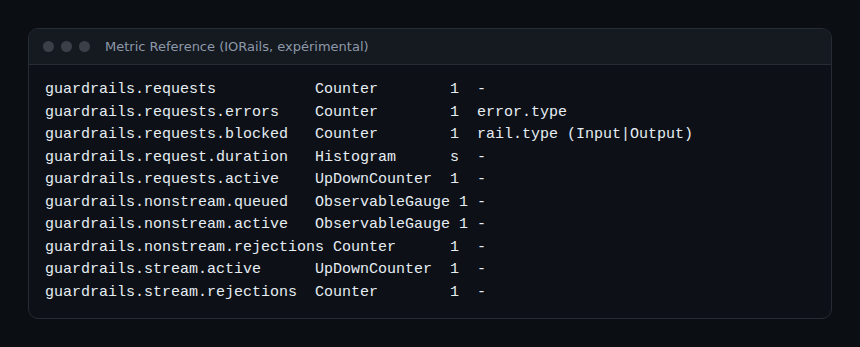
El servidor nemoguardrails server puede exponer un punto de scrape de Prometheus, pero la documentación precisa que solo publica tres métricas de admisión (cola en espera, activas, rechazos) y descarta las demás. Para exportarlo todo, hay que configurar la exportación en la aplicación.
Guardrails AI, en los archivos leídos, no define contadores ni histogramas propios: solo se emiten spans. La tasa de fallos por validador se calcula, por tanto, a partir de las trazas (atributo validation_passed, nombre del validador), mediante un pipeline que convierta los spans en métricas, por ejemplo en el Collector contrib. Este punto es una lectura del código, no una afirmación de ausencia en toda la documentación del proyecto.
Datos sensibles en la telemetría
Es el criterio que más debería pesar en la revisión de seguridad. NeMo Guardrails no registra el contenido de los prompts y las respuestas por defecto: la captura es opt-in, mediante tracing.enable_content_capture o la variable OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT, que prevalece sobre la configuración en ambos sentidos. La documentación advierte de que ese contenido puede incluir datos personales y describe un comportamiento particular con los rails de enmascaramiento.
En el código de Guardrails AI, los atributos de span recogen el valor validado: validator.validate.input.value para el validador, input.value y output.value para el step. En los archivos leídos no aparece ninguna opción de captura opt-in. Un Collector configurado para eliminar o aplicar un hash a esos atributos antes de exportar se convierte entonces en el lugar adecuado para aplicar la política de retención.
A esto se suma la telemetría propia del proyecto: Guardrails AI contiene una telemetría «Hub» cuya activación depende de allow_metrics_collection o del ajuste de guardrails configure; el código la describe como métricas anónimas. El README anuncia además, el 6 de julio de 2026, que los validadores pasan a ser paquetes de PyPI instalables con pip y que la inferencia remota alojada se detiene, con una fecha de corte prevista el 25 de agosto de 2026. Los validadores que dependían de ese servicio requieren, por tanto, una comprobación antes de pasar a producción.
Cómo comprobar que funciona
- Ejecutar el script de inicio rápido de la documentación de NeMo Guardrails con
ConsoleSpanExportery comprobar la presencia deguardrails.requestyguardrails.rail. - Para Guardrails AI, provocar un fallo a propósito (ejemplo del README con
OnFailAction.EXCEPTION) y buscar el span…validatecuyovalidation_passedvale falso. - Pasar después a una exportación OTLP hacia el Collector y verificar que ni prompt ni respuesta aparecen en el backend mientras no se quiera la captura de contenido.
Buenas prácticas
- Fijar un presupuesto de latencia para la capa de guardarraíles (SLO) y medirlo con las duraciones de los spans, no con una prueba única.
- Calcular la tasa de bloqueo por tipo de rail o de validador, nunca como agregado global.
- Tratar los spans como datos sensibles: filtrado en el Collector y retención corta.
- Fijar las versiones y leer el registro de cambios: IORails es experimental en NeMo y los nombres de las métricas pueden cambiar.
- Vincular los spans de guardarraíles con los costes en tokens, ver el coste de un agente de IA en tokens con OpenTelemetry.
Preguntas frecuentes
¿Qué biblioteca elegir para un equipo de plataforma?
Las fuentes leídas no permiten designar un ganador. NeMo Guardrails ofrece una configuración en archivos y un catálogo de métricas (experimental); Guardrails AI ofrece validadores en código y spans detallados. La elección correcta depende de la necesidad de configuración centralizada y del nivel de control deseado sobre los datos exportados.
¿Se pueden usar las dos juntas?
Nada en la documentación leída lo prohíbe, pero tampoco se describe ninguna integración común: este punto no está verificado. Cada capa añade latencia y sus propios spans, que conviene medir por separado.
¿Cómo seguir la tasa de bloqueo?
Con NeMo Guardrails IORails, mediante guardrails.requests.blocked dividido entre guardrails.requests. Con Guardrails AI, mediante los spans de validadores cuyo validation_passed es falso, contados en el Collector. Las convenciones semánticas GenAI aún evolucionan: los nombres pueden cambiar.
Conclusión
Los dos proyectos hablan OpenTelemetry, pero uno entrega métricas en un motor experimental y el otro spans ricos en contenido. Para un equipo SRE, la decisión depende menos de la detección que de tres puntos: dónde vive la política, qué métricas salen sin un pipeline y qué datos abandonan la aplicación. Para un agente de código en la empresa, consulta también la supervisión de un agente de código. Fuentes: NVIDIA-NeMo/Guardrails y guardrails-ai/guardrails.
Este blog es independiente y no está afiliado a Dynatrace LLC, ni a NVIDIA, ni a Guardrails AI. Los nombres de productos pertenecen a sus propietarios; los contenidos técnicos proceden de los repositorios oficiales citados.