Lunes por la mañana, tras el despliegue del viernes. El equipo de plataforma ha conectado un asistente interno a un LLM, los spans llegan a Dynatrace y, aun así, la pantalla de AI Observability sigue vacía. Con OpenInference Dynatrace el motivo suele ser prosaico: cada lado habla un dialecto distinto de atributos. El instrumentor escribe llm.model_name; la herramienta busca gen_ai.request.model.
Este tutorial parte de ese problema de operaciones y responde a dos preguntas: dónde conviene hacer la traducción y cómo demostrar que funciona. Me baso en la página Get started with OpenInference and AI Observability (consultada el 8 de noviembre de 2026), en la especificación de OpenInference de Arize y en una entrada de la comunidad. El alcance es solo Dynatrace SaaS: de Managed no se dice nada.
Una aclaración antes de seguir: no he ejecutado esta cadena en ningún entorno. Todo lo que es montaje propio lleva la etiqueta «nuestro» o «sin ejecutar».
Por qué unos spans correctos se quedan mudos
OpenInference modela una aplicación de IA como una secuencia de spans con tipo: openinference.span.kind puede ser LLM, EMBEDDING, AGENT, TOOL, RETRIEVER o GUARDRAIL. Son spans de OpenTelemetry de pleno derecho, es decir, trazas y no métricas. Lo único que cambia es el vocabulario de los atributos respecto a la convención gen_ai.*.
Para quien está de guardia, la consecuencia es clara: sin el modelo ni los contadores de tokens en su sitio no puedes seguir el coste ni la latencia por modelo, ni relacionar una deriva con un SLO. La traza existe, pero no cuenta nada útil.
OpenInference Dynatrace: tres sitios donde traducir
Antes de tocar un solo archivo, decide dónde va a vivir la traducción. Yo veo tres opciones.
- En el instrumentor. Algunos pueden emitir las dos familias de atributos si activas
OPENINFERENCE_ENABLE_GENAI_SEMCONV=true. La documentación menciona OpenAI y Cohere. Es lo más sencillo, pero la cobertura cambia de un paquete a otro. - En el Collector. El procesador
genainormalizerconvierte los atributos antes del envío. Una única configuración sirve a todas las aplicaciones y ninguna necesita un token de Dynatrace. - En Dynatrace. Es posible en teoría, pero pierdes el control sobre lo que sale de tu red, prompts incluidos.
Mi opción por defecto es el Collector: concentra el token, permite enmascarar contenido antes de la salida y cubre los huecos de los instrumentors. Es la que desarrollo a partir de aquí.
Qué debes tener a mano
- Un entorno SaaS con licencia Dynatrace Platform Subscription (DPS), con Traces powered by Grail y la ingesta OTLP activadas.
- Un token: platform token con el ámbito
openpipeline:traces:ingest, o Classic access token con «Ingest OpenTelemetry traces» (openTelemetryTrace.ingest). - Docker y un Collector que incluya
genainormalizer: Dynatrace Collector 0.53.1 o posterior, o Dynatrace Bindplane OTel Collector 1.1.2 o posterior. - Una aplicación en Python y el paquete de OpenInference de su proveedor, por ejemplo
openinference-instrumentation-openai.
Bastan dos variables: DT_ENDPOINT (la URL base, del tipo https://<id-environnement>.live.dynatrace.com, sin /api/v2/otlp) y DT_API_TOKEN. El archivo .env que las guarda no debe entrar nunca en Git.
El archivo del Collector, bloque a bloque
La documentación describe el comportamiento esperado, pero no publica el YAML completo. El archivo de abajo es, por tanto, nuestro ensamblaje: receptor y exportador siguen los ejemplos oficiales, y el bloque de normalización sale de la entrada de la comunidad (versión upstream del Collector de OpenTelemetry 0.153.0 o posterior). Comprueba el nombre exacto del componente en la lista de tu distribución.
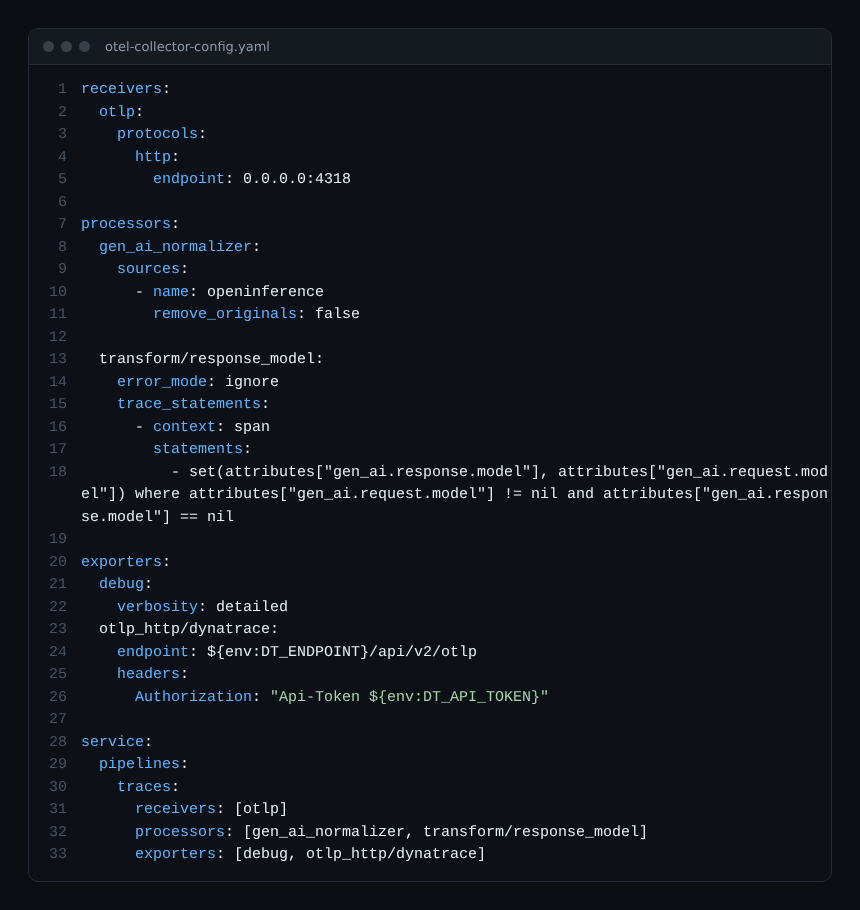
Tres detalles merecen una explicación.
remove_originals: false. Al principio conserva los dos juegos de atributos en el mismo span: así la comparación entre antes y después es inmediata. La documentación lo pone entruepara quedarse solo congen_ai.*.transform/response_model. OpenInference no tiene un «modelo de respuesta». El procesador copia entonces el modelo solicitado engen_ai.response.model; la instrucción OTTL que ves es mía.- Solo pipelines de trazas. Según la entrada de la comunidad, enganchar este procesador a métricas o logs impide que el Collector arranque.
Primera prueba: un contenedor y una frase al modelo
Se levanta el Collector y después se lanza una aplicación mínima. Los comandos proceden de la documentación, abreviados; la imagen es ghcr.io/dynatrace/dynatrace-otel-collector/dynatrace-otel-collector:0.53.1.
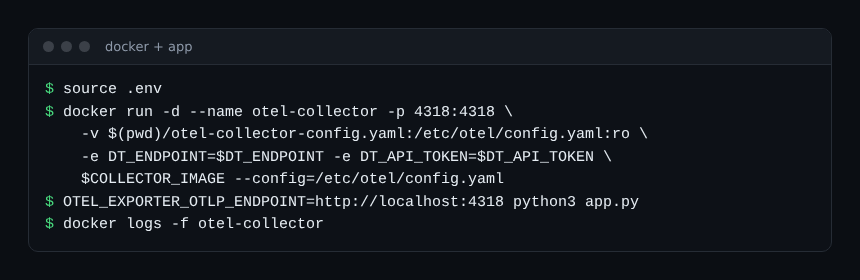
El script de la documentación crea un TracerProvider, un exportador OTLP/HTTP y el instrumentor de OpenAI, y pide un haiku sobre observabilidad. Mi variante, sin volver a verificar: deja el exportador sin argumentos para que lea OTEL_EXPORTER_OTLP_ENDPOINT, como prevé el SDK. Así la aplicación solo conoce localhost:4318.
exporter = OTLPSpanExporter()  # lee OTEL_EXPORTER_OTLP_ENDPOINT
tracer_provider.add_span_processor(BatchSpanProcessor(exporter))
OpenAIInstrumentor().instrument(tracer_provider=tracer_provider)
Ojo con la privacidad: los instrumentors de Python basados en TraceConfig capturan prompts y respuestas por defecto. Para evitarlo, pon a true las variables OPENINFERENCE_HIDE_INPUTS, OPENINFERENCE_HIDE_OUTPUTS, OPENINFERENCE_HIDE_INPUT_MESSAGES y OPENINFERENCE_HIDE_OUTPUT_MESSAGES.
Lo que el procesador sabe convertir de verdad
La tabla de equivalencias de la documentación supera la decena de filas. Lo esencial: el tipo de span pasa a gen_ai.operation.name (chat, embeddings, invoke_agent, execute_tool), el nombre del modelo a gen_ai.request.model y los contadores de tokens a gen_ai.usage.*.
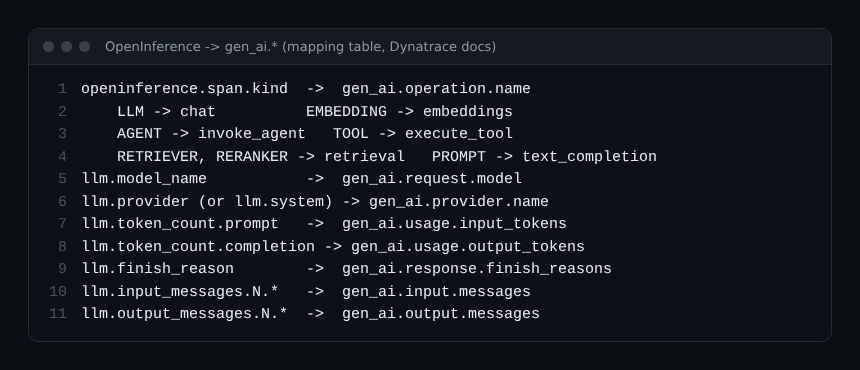
Los mensajes numerados (llm.input_messages.N.*) se reúnen en un historial JSON dentro de gen_ai.input.messages, siempre que el instrumentor emita datos suficientes.
Tres comprobaciones para fiarse de lo que se ve
- En el Collector. Ejecuta
docker logs -f otel-collectorcon el exportadordebugen verbosidaddetailedy buscagen_ai.request.modelen cada span. - En la interfaz. Ctrl+K, «AI Observability», pestaña Explorer: deben aparecer el modelo, los tokens y el contenido. La misma consulta está en Distributed Traces.
- Con DQL. La documentación no trae un ejemplo propio de OpenInference. La primera consulta sale de su tutorial RAG; la segunda es mía y no se ha ejecutado.
fetch spans
| summarize models = collectDistinct(gen_ai.request.model)
| expand models
| sort models

fetch spans
| filter isNotNull(gen_ai.request.model)
| summarize input = sum(gen_ai.usage.input_tokens),
            output = sum(gen_ai.usage.output_tokens),
            by: { gen_ai.request.model }
¿No aparece nada? Mira primero la URL: el Collector ya añade por su cuenta /api/v2/otlp a DT_ENDPOINT.
Puntos ciegos que conviene conocer
- Una transformación no reconstruye lo que el instrumentor nunca emitió.
- Temperatura,
top_p,max_tokens, motivos de finalización, caché de prompt ygen_ai.systemrequieren tus propiostransform; el procesador sí rellenagen_ai.provider.name. - Los spans GUARDRAIL no tienen un conjunto estándar de atributos: el valor pasa tal cual a
gen_ai.operation.name. - De Managed no hay ninguna información verificada.
Buenas prácticas
- Mantén un Collector central: el token vive en un solo lugar y se renueva sin tocar las aplicaciones.
- Limita el token a la ingesta de trazas.
- Decide qué pasa con el contenido antes de producción: un prompt puede llevar datos personales.
- Una vez validado, cambia
remove_originalsatruepara evitar atributos duplicados. - Después relaciona latencia y tokens por modelo con tus objetivos, como en el artículo sobre la fiabilidad de las cargas de IA.
Para ampliar: el contexto con Dynatrace y Arize, y luego los agentes MCP, la supervisión de un agente de código y OpenTelemetry de extremo a extremo. Sobre los atributos: la especificación de OpenInference y la entrada GenAI Normalizer de la comunidad.
Preguntas frecuentes
¿Sigue siendo útil el Collector si el instrumentor ya emite gen_ai.*?
Muchas veces sí. OPENINFERENCE_ENABLE_GENAI_SEMCONV=true añade los gen_ai.*, pero la cobertura varía. El Collector hace de red de seguridad para los atributos que faltan y de punto único para enmascarar contenido.
¿Qué token y con qué ámbitos?
Un platform token con openpipeline:traces:ingest o un Classic access token con openTelemetryTrace.ingest. En los scripts de la documentación, la cabecera es Bearer para el primero y Api-Token para el segundo. Nuestro YAML usa Api-Token: con un platform token, cambia la cabecera.
¿Y en Dynatrace Managed?
La página consultada se refiere a SaaS (DPS, Grail). No puedo afirmar nada sobre Managed.
Conclusión
Con OpenInference Dynatrace quédate con una decisión y un hábito. La decisión: traducir en un Collector central. El hábito: validar primero con remove_originals: false y el contenido enmascarado, y leer los spans en los logs antes de buscarlos en AI Observability.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Arize. Las marcas citadas pertenecen a sus propietarios. Las herramientas cambian deprisa: comprueba siempre los comandos y las opciones en la documentación oficial.