Poner barreras de seguridad para agentes de IA en producción es añadir una capa de control entre el agente, el modelo y las herramientas a las que llama. Esa capa bloquea una petición peligrosa, filtra una respuesta o rechaza una conexión de red. También tiene un coste para el equipo de explotación: cada control añade latencia, puede caerse y produce decisiones que hay que poder explicar después.
Este panorama no compara la calidad de detección de las herramientas. Mira lo que le interesa a un SRE: dónde se sitúa cada barrera, cuánto tiempo añade a una petición, qué métricas y qué trazas expone y cómo calcular una tasa de bloqueo fiable. Tres familias de código abierto sirven de hilo conductor: NVIDIA NeMo Guardrails, los modelos de clasificación de Meta (Llama Guard, Prompt Guard, LlamaFirewall) y NVIDIA OpenShell, la pieza de software de la Open Agent Safety Platform anunciada a finales de septiembre de 2026.
El contenido no depende de Dynatrace: las señales descritas salen en OpenTelemetry o en Prometheus hacia cualquier backend compatible, incluidos Dynatrace SaaS y Dynatrace Managed.
Barreras de seguridad para agentes de IA: tres niveles de control
Un agente hace tres cosas: recibe texto, llama a un modelo y actúa (herramienta, archivo, red). Las barreras se clasifican según el punto donde intervienen.
- El contenido: un clasificador lee el prompt o la respuesta y contesta «seguro» o «no seguro». Es el papel de Llama Guard 4 (12 000 millones de parámetros, multimodal) y de Llama Prompt Guard 2 (22M y 86M de parámetros, especializado en inyección de prompt y jailbreak).
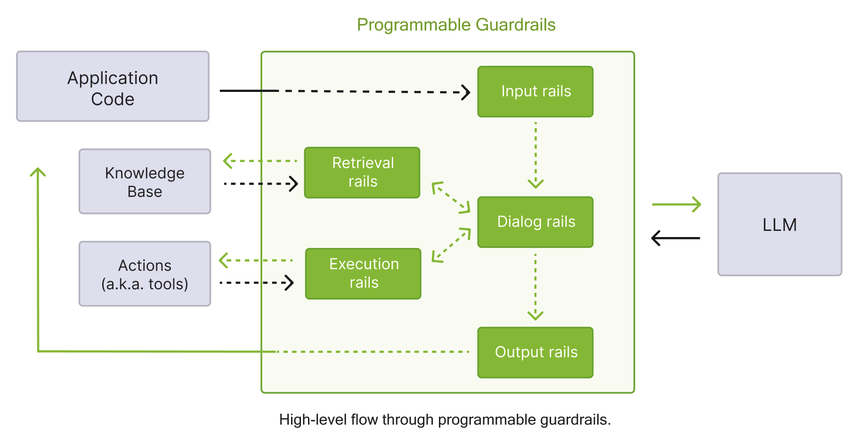
- La orquestación: un framework encadena varios controles antes y después de la llamada al modelo. NeMo Guardrails habla de input rails, dialog rails, retrieval rails, execution rails y output rails. LlamaFirewall combina por su parte varios escáneres (PromptGuard 2, AlignmentCheck, CodeShield, expresiones regulares).
- La ejecución: un runtime aísla al agente y aplica una política sobre los archivos, las llamadas al sistema y la red. Es el terreno de OpenShell.
Estos niveles se complementan. Un clasificador de contenido no ve que un agente abre una conexión hacia un host desconocido; un runtime de aislamiento no lee el sentido de una respuesta. Para enmarcar el resto de la cadena, consulta también cómo proteger un servidor MCP.
Lo que se ha publicado sobre la Open Agent Safety Platform
El comunicado de NVIDIA del 28 de septiembre de 2026 describe una plataforma en dos partes: OpenShell, software de código abierto presentado como disponible, y Sentry, un diseño de referencia (reference system design) que vigila el comportamiento de los agentes fuera de banda en DPU BlueField-4. El comunicado no da fecha de disponibilidad para Sentry. Por tanto, hoy solo se puede instalar OpenShell.
El repositorio NVIDIA/OpenShell tiene licencia Apache 2.0. Su README describe una sandbox por agente, controles a nivel de kernel sobre los archivos y las llamadas al sistema, una verificación de política para cada conexión de red saliente y credenciales inyectadas solo hacia los puntos de acceso aprobados. La serie 0.1.x es la primera que sigue un ritmo de publicación estable: el proyecto sigue siendo joven y conviene probarlo antes de generalizarlo.
Latencia añadida: medirla en lugar de adivinarla
Cada barrera que llama a un modelo añade un viaje de ida y vuelta de inferencia. Un clasificador de 12 000 millones de parámetros colocado en la entrada y en la salida duplica ese coste. La única estimación fiable es la que mides sobre tu tráfico, span por span.
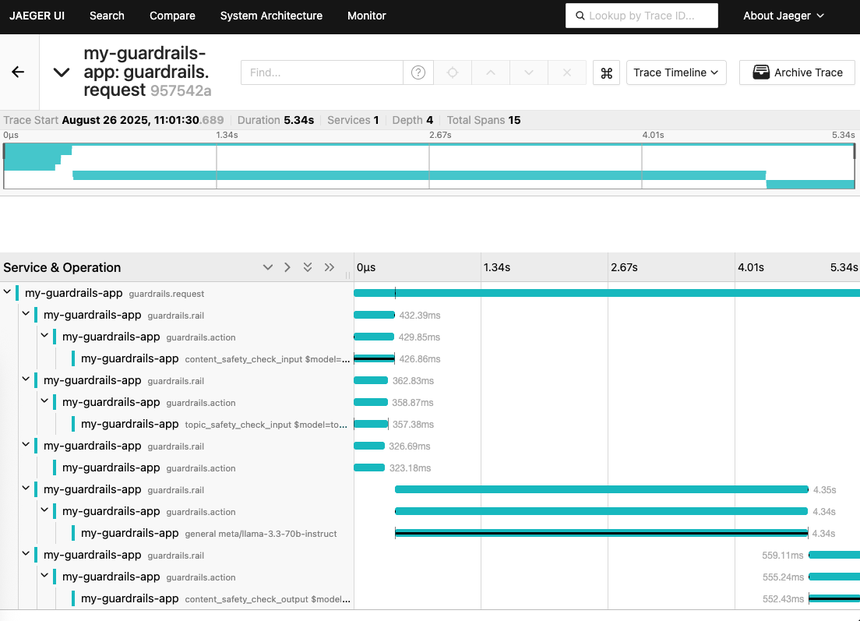
NeMo Guardrails produce spans de OpenTelemetry cuando se activa el trazado. La traza siguiente, tomada de su documentación, muestra una petición de 5,34 s: tres rails de entrada lanzados en paralelo (unos 430 ms el más lento), la llamada al modelo principal (4,34 s) y después un rail de salida (unos 560 ms).
Dos palancas reducen este sobrecoste. La primera: ejecutar en paralelo los rails independientes, con parallel: True bajo rails.input y rails.output. La documentación lo reserva a los rails ligados a entradas y salidas y desaconseja este modo cuando un rail de entrada modifica el mensaje, por las condiciones de carrera. La segunda: elegir un clasificador a su medida. Meta indica que Prompt Guard 2 22M reduce la latencia y el coste de cómputo en un 75 % respecto a la versión 86M, con una pérdida de rendimiento mínima.
En la práctica: instrumentar una barrera de seguridad
Paso 1: activar las trazas de NeMo Guardrails
Instala el extra de trazado (pip install "nemoguardrails[tracing]" opentelemetry-sdk), configura un TracerProvider con el exportador que prefieras y añade después al config.yml:
tracing:
  enabled: true
  adapters:
    - name: OpenTelemetry

rails:
  input:
    parallel: True
    flows:
      - content safety check input $model=content_safety
      - topic safety check input $model=topic_control
Cada petición produce entonces un span guardrails.request y, por cada control, un guardrails.rail y un guardrails.action. El tiempo de barrera se lee directamente: duración de la petición menos duración de la llamada al modelo principal.
Paso 2: exportar las métricas de bloqueo
Las métricas de OpenTelemetry de NeMo Guardrails requieren el motor IORails (Guardrails(config, use_iorails=True) o la variable NEMO_GUARDRAILS_IORAILS_ENGINE=1) y la clave metrics: enabled: true. La documentación las presenta como experimentales: los nombres aún pueden cambiar. Las más útiles:
guardrails.requests(contador): peticiones procesadas;guardrails.requests.blocked(contador, atributorail.type=InputuOutput): peticiones bloqueadas por un rail;guardrails.requests.errors(contador, atributoerror.type): peticiones terminadas con error;guardrails.request.duration(histograma, en segundos): duración de extremo a extremo;gen_ai.client.operation.duration(histograma, en segundos): duración de cada llamada al modelo, según las convenciones GenAI de OpenTelemetry.
Si tu backend es Dynatrace, ajusta la temporalidad de los contadores antes de la exportación: consulta la temporalidad de las métricas OTLP.
Paso 3: calcular una tasa de bloqueo con sentido
La tasa de bloqueo se calcula por tipo de rail: guardrails.requests.blocked{rail.type="Input"} dividido por guardrails.requests, sobre la misma ventana. Sepárala de la tasa de errores. Una barrera que falla no ha bloqueado un ataque: ha fallado. El registro de cambios de la versión 0.24.0 indica precisamente que IORails distingue ahora los bloqueos de política de los fallos de ejecución de un rail. Por último, sigue la tasa en el tiempo: una subida repentina señala una campaña de abuso o un falso positivo introducido por un cambio de configuración.
Paso 4: monitorizar la capa de ejecución de OpenShell
OpenShell produce tres señales: trazas OTLP (pasarela y supervisores de sandbox), métricas Prometheus servidas por la pasarela y eventos de seguridad en formato OCSF. El endpoint de métricas está desactivado mientras no se defina metrics_bind_address en gateway.toml. No tiene ninguna autenticación: limita su acceso a tu herramienta de monitorización.
[openshell.gateway]
metrics_bind_address = "0.0.0.0:9090"

[openshell.gateway.otlp]
endpoint = "https://backend:4317"

[openshell.gateway.otlp.ocsf]
enabled = true
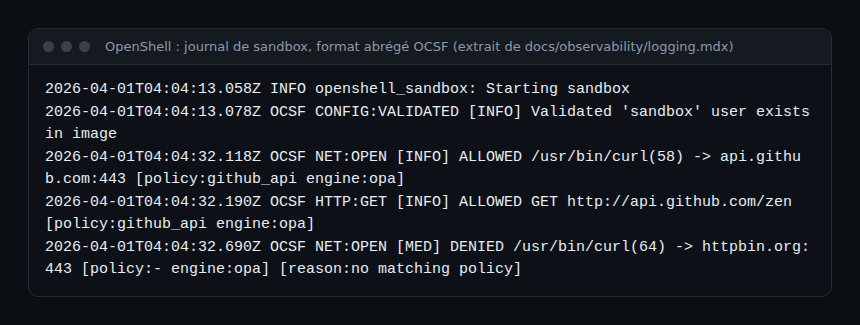
En cuanto a métricas, vigila openshell_gateway_interceptor_latency_seconds (duración de los interceptores), openshell_gateway_interceptor_evaluations_total (decisiones, por atributo decision) y los dos contadores openshell_gateway_interceptor_fail_open_total y openshell_gateway_interceptor_fail_closed_total. El primero cuenta los fallos de interceptor que dejaron pasar la petición: es el indicador sobre el que alertar en primer lugar. Los rechazos de red aparecen en los logs de la sandbox:
Cómo comprobar que funciona
- Envía un prompt inocuo y después un prompt que tu política deba rechazar. En el backend de trazas, la segunda petición debe mostrar un
guardrails.railde entrada y ninguna llamada al modelo principal. - Comprueba que
guardrails.requests.blockedha aumentado en 1 conrail.type="Input". - En una sandbox de OpenShell, lanza
curlhacia un host no autorizado: debe aparecer una líneaNET:OPEN [MED] DENIEDenopenshell logs.
Buenas prácticas
- Fija un presupuesto de latencia para las barreras (por ejemplo, una parte del SLO de tiempo de respuesta) y síguelo como un SLI.
- Decide de antemano el comportamiento ante un fallo: fail open o fail closed, rail por rail, y alerta en cada cambio.
- No registres el contenido de los prompts por defecto: la captura de contenido de NeMo Guardrails es una opción que hay que activar explícitamente.
- Reproduce un conjunto de prompts de referencia en cada cambio de política para medir los falsos positivos.
- Mantén los clasificadores en la misma infraestructura de inferencia que tus modelos y monitorízalos igual, como se describe para vLLM en producción.
Preguntas frecuentes
¿Hace falta una barrera en la entrada y en la salida?
La ficha de Llama Guard 4 resume el equilibrio: filtrar la entrada detiene un contenido peligroso antes de cualquier llamada al modelo, filtrar la salida deja al modelo la oportunidad de responder correctamente. Las dos juntas protegen mejor, con una latencia mayor.
¿Las barreras sustituyen al aislamiento del agente?
No. Un clasificador a veces se equivoca y no ve las acciones del sistema. Una sandbox como OpenShell limita los daños cuando falla el control de contenido.
¿Los modelos Llama Guard son de código abierto?
Se publican con sus pesos, bajo la licencia comunitaria de Llama (Llama 4 Community License para Llama Guard 4). Las herramientas de evaluación de Purple Llama y LlamaFirewall tienen licencia MIT. Comprueba las condiciones antes de un uso comercial.
Conclusión
Una barrera de seguridad es un componente de producción como cualquier otro: tiene latencia, tasa de errores y un modo de fallo. Traza cada rail, cuenta por separado bloqueos y errores y aísla la ejecución de los agentes. Para relacionar estas señales con las trazas de tus agentes, continúa con la observación de los agentes MCP con OpenTelemetry y Langfuse y OpenLLMetry. Fuentes: NeMo Guardrails, OpenShell y Purple Llama.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a los proyectos citados. Las marcas citadas pertenecen a sus propietarios. Las herramientas evolucionan rápido: comprueba siempre los comandos y las opciones en su documentación oficial.