Todos sus logs siguen el mismo camino, y la misma regla de procesamiento se aplica al servicio de pagos y a un job de pruebas. Este tutorial muestra cómo crear un pipeline de OpenPipeline y enrutarlo: un pipeline propio de un servicio, una ruta que le envía sus logs y un plan para el resto del flujo.
Para un equipo SRE o de plataforma, es el punto de partida del control del volumen, de la retención y de los permisos sobre los logs. OpenPipeline se apoya en Grail: el contenido es válido para Dynatrace SaaS. No se aplica a Dynatrace Managed, que no tiene ni Grail ni OpenPipeline.
Objetivo: al final, un pipeline de logs personalizado recibe únicamente los logs de un deployment de Kubernetes, sin tocar el resto. Los casos de uso (enmascaramiento, métricas, volumen) se añaden después sobre esta base; se tratan en otros artículos enlazados más abajo.
Requisitos previos
- Un entorno Dynatrace SaaS (Grail y AppEngine) con acceso de nivel administrador: la documentación precisa que es necesario para crear rutas y pipelines.
- Logs ya ingeridos con atributos aprovechables, por ejemplo
k8s.namespace.nameyk8s.deployment.name(véase el módulo de logs y OpenPipeline). - Cierta familiaridad con DQL: la condición de la ruta es una consulta DQL.
- Opcional: un bucket de Grail personalizado, si este servicio requiere una retención o unos permisos particulares. Créelo antes del pipeline.
Entender el pipeline de OpenPipeline y su ruta
Un registro llega por una fuente de ingesta y después se enruta hacia un pipeline. El enrutamiento es dinámico (decide una condición DQL) o estático (una fuente personalizada designa un pipeline fijo). La documentación insiste en un punto: el orden de la lista de rutas fija el orden de ejecución. Si ninguna ruta coincide, el registro sigue la ruta por defecto (Default route).
Coexisten dos familias de pipelines. Los pipelines integrados (built-in) reciben los datos sin configuración y los envían al bucket de Grail integrado. Los pipelines personalizados son los suyos; la documentación recomienda enrutar hacia ellos todos los datos posibles con condiciones explícitas.
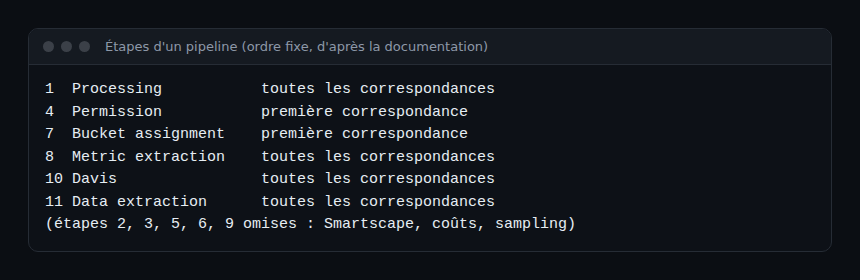
Cada pipeline atraviesa etapas en un orden fijo. Cada procesador de una etapa tiene una condición de coincidencia (matcher) en DQL, y la salida de un procesador alimenta al siguiente.
Paso 1: localizar lo que hay que enrutar
Antes de crear nada, busque en un Notebook los atributos que identifican sus servicios. La documentación propone esta consulta:
fetch logs
| filter k8s.namespace.name == "prod"
| summarize by:{k8s.deployment.name}, count()
El resultado indica el número de rutas útiles y la condición de cada una. Prefiera un atributo estable (deployment, namespace) a un fragmento de mensaje que cambia con el código.
Paso 2: crear el pipeline
- Abra Settings > Process and contextualize > OpenPipeline, elija el configuration scope Logs y después la pestaña Pipelines.
- Seleccione Pipeline e introduzca un nombre, por ejemplo «Checkout service pipeline».
- Para cada etapa útil, añada un procesador: un nombre, una condición de coincidencia y después los campos propios del procesador.
- Haga clic en Save.
Un pipeline creado así empieza vacío: no hace nada mientras no se le añada un procesador. Es intencional, de modo que puede crear primero la ruta y añadir después las reglas de procesamiento, por ejemplo las del enmascaramiento de datos sensibles.
Paso 3: crear la ruta dinámica
Abra la pestaña de enrutamiento dinámico (Dynamic routing) y después Dynamic route. Defina tres elementos: un nombre, una condición de coincidencia y el pipeline de destino.
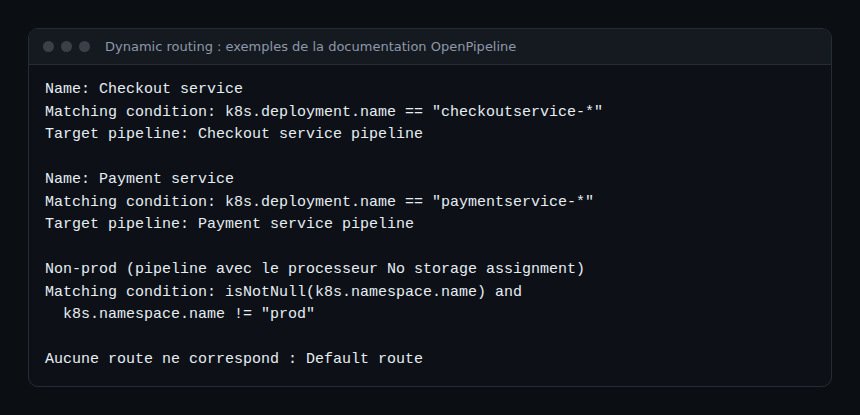
Name: Checkout service
Matching condition: k8s.deployment.name == "checkoutservice-*"
Target pipeline: Checkout service pipeline
Los logs que cumplen la condición van al pipeline de destino. El carácter comodín * procede del ejemplo de la documentación: cubre los nombres de pods o de deployments con sufijo.
Paso 4: decidir qué pasa con el resto
Los logs de producción que no coinciden con ninguna condición nueva siguen hacia la ruta por defecto, es decir, hacia el pipeline clásico. Es útil para migrar servicio por servicio sin romper lo existente.
La documentación da también un caso para fuera de producción: una condición isNotNull(k8s.namespace.name) and k8s.namespace.name != "prod", asociada a un pipeline que usa el procesador No storage assignment para no almacenar esos logs. Mida primero su utilidad: una ruta que descarta logs es una decisión de retención, que debe validarse con los equipos afectados.
Cómo comprobar que funciona
Espere unos minutos tras guardar: el enrutamiento solo se aplica a los registros ingeridos después, no a los logs ya almacenados (comportamiento esperado de un procesamiento en la ingesta). Genere o espere tráfico y después compruebe el volumen en un Notebook:
fetch logs, from:now()-30m
| filter matchesValue(k8s.deployment.name, "checkoutservice-*")
| summarize count()
Para ver el efecto del propio pipeline, añada un procesador sencillo (por ejemplo un campo de su elección mediante el procesador Add fields) y busque ese campo en los nuevos logs. Si falta, verifique en este orden: la condición de la ruta, la posición de la ruta en la lista, la condición del procesador.
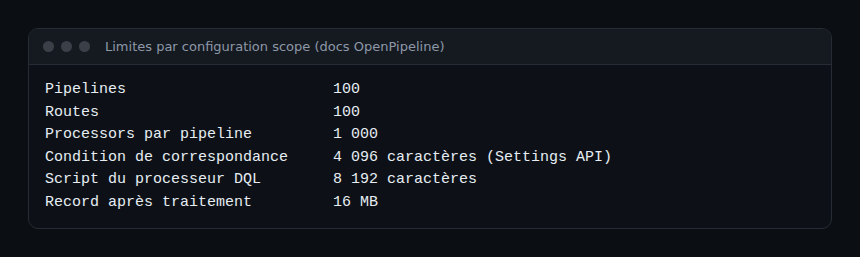
Tenga presentes los límites por configuration scope, según la documentación.
Buenas prácticas
- Un pipeline por servicio o por equipo: el propietario de un pipeline puede gestionar su acceso, lo que no ocurre con el enrutamiento (la documentación precisa que el control por propietario afecta a los pipelines y a las fuentes de ingesta, no a las rutas).
- Condiciones explícitas, nunca «todo»: la documentación lo recomienda para los pipelines personalizados.
- Vigile el orden de las rutas: la posición en la lista fija el orden de ejecución. La documentación no describe qué ocurre cuando varias rutas coinciden; evite las condiciones que se solapan.
- Versione pipelines y rutas con la configuración como código (véase el mismo reflejo para las métricas) y siga la ingesta con la supervisión de los logs.
- Permisos: para los pipelines, la documentación cita
settings:objects:readysettings:objects:write(propietario) ysettings:objects:admin(administrador).
Preguntas frecuentes
¿Cuál es la diferencia entre enrutamiento dinámico y estático?
El enrutamiento dinámico se apoya en una condición DQL. El enrutamiento estático envía todo a un pipeline fijo, pero solo para una fuente de ingesta personalizada; para esas fuentes, la coincidencia de otra ruta se ignora.
¿Qué ocurre con los logs que no coinciden con ninguna ruta?
Pasan por la ruta por defecto. En el ejemplo de la documentación, los logs de producción no cubiertos siguen hacia el pipeline clásico.
¿Y con Dynatrace Managed?
OpenPipeline no existe en Managed. La clasificación puede hacerse antes, por ejemplo en el Collector de OpenTelemetry antes del envío (véase la ingesta de logs por API).
Conclusión
Crear un pipeline de OpenPipeline se resume en tres gestos: localizar los atributos, crear el pipeline y escribir la ruta con una condición explícita. Lo demás (enmascaramiento, métricas, buckets) se añade al pipeline sin tocar los otros servicios. Empiece por un servicio, verifique con un Notebook y después amplíe.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Los nombres de las pantallas y los límites evolucionan: compruébelos en la documentación oficial de OpenPipeline.