Grafana Tempo almacena tus trazas distribuidas, y kube-prometheus-stack ya ofrece Prometheus y Grafana en el clúster. Ambos se complementan: Tempo guarda las trazas, Prometheus guarda las métricas obtenidas de esas trazas y Grafana las une en una sola interfaz. Esta guía instala Grafana Tempo junto a kube-prometheus-stack, activa el metrics-generator y configura la fuente de datos Tempo en Grafana.
Para un equipo SRE, el interés es concreto. Cuando un SLO se degrada, partes de una métrica RED en Prometheus y pasas a la traza que lo explica. El camino es más corto, y el MTTR también. La guía complementa nuestra comparativa de Dynatrace y Grafana con la puesta en práctica de la parte «trazas» de la pila Grafana.
Este contenido trata sobre la pila de código abierto Grafana y Prometheus. No depende de Dynatrace SaaS ni de Dynatrace Managed.
En resumen
- Grafana Tempo recibe las trazas por OTLP (puertos 4317 en gRPC y 4318 en HTTP en el chart) y las almacena.
- Su metrics-generator produce métricas a partir de los spans y las envía a Prometheus por
remote_write. - En kube-prometheus-stack bastan dos ajustes:
enableRemoteWriteReceivery el descubrimiento de los ServiceMonitors. - En Grafana, la fuente Tempo apunta a Prometheus con
serviceMapytracesToMetrics.
Requisitos previos y versiones
Los valores siguientes se leyeron en los archivos de los charts en el momento de la redacción (31 de octubre de 2026). Cambian rápido: relee el values.yaml de la versión que instales.
- Un clúster de Kubernetes y Helm 3. El chart kube-prometheus-stack indica la versión 92.16.1 (appVersion v0.94.2) y
kubeVersion >=1.25.0-0. - El chart
tempo(modo monolítico, «single binary»), publicado por el repositoriografana-community/helm-charts, versión 3.2.1 para Tempo 3.1.1. Requiere Kubernetes ^1.25.0-0. - Un namespace
monitoringpara todos los componentes. Adapta las direcciones si usas otro.
Según la documentación de Tempo, existen dos charts: tempo-distributed (microservicios) y tempo (monolítico). Este tutorial usa el segundo, más sencillo para un primer despliegue. Ten en cuenta también que el antiguo chart tempo-distributed del repositorio grafana/helm-charts está marcado como deprecated: true: los charts actuales proceden de grafana-community.
Arquitectura: el camino de una traza hasta Grafana
El flujo tiene cinco pasos. La aplicación (o un Collector de OpenTelemetry) envía sus spans a Tempo por OTLP. Tempo los almacena. Su metrics-generator calcula métricas de service graph y de span metrics. Las envía a Prometheus. Grafana consulta Tempo para las trazas y Prometheus para las métricas.
Este esquema se suma a un Collector ya desplegado. Nuestra guía sobre el Collector de OpenTelemetry en Kubernetes muestra cómo desplegar ese componente; basta con añadirle Tempo como destino OTLP.
Paso 1: preparar kube-prometheus-stack para recibir el remote write
Por defecto, Prometheus no acepta escrituras remotas. El values.yaml del chart documenta el ajuste: prometheus.prometheusSpec.enableRemoteWriteReceiver activa la opción --web.enable-remote-write-receiver del servidor. Otro punto importante: mientras serviceMonitorSelectorNilUsesHelmValues siga en true, Prometheus solo descubre los ServiceMonitors que llevan la etiqueta de la release. El README del chart indica ponerlo en false para descubrirlos todos.
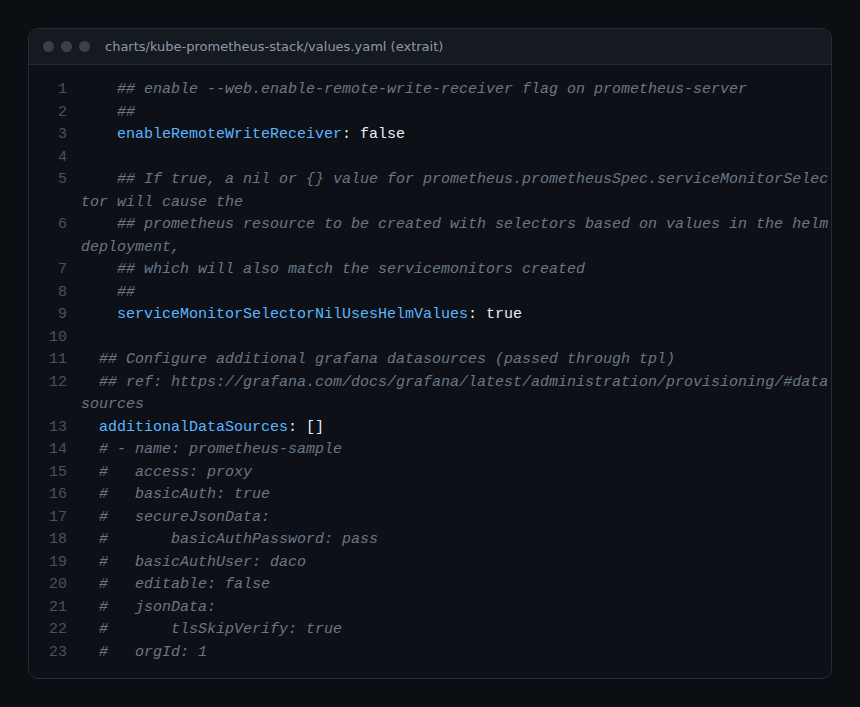
Este es el archivo de valores completo. La fuente Tempo se declara en grafana.additionalDataSources, como prevé el chart.
# kps-values.yaml
prometheus:
  prometheusSpec:
    enableRemoteWriteReceiver: true
    serviceMonitorSelectorNilUsesHelmValues: false

grafana:
  additionalDataSources:
    - name: Tempo
      uid: tempo
      type: tempo
      access: proxy
      url: http://tempo.monitoring:3200
      jsonData:
        serviceMap:
          datasourceUid: prometheus
        nodeGraph:
          enabled: true
        tracesToMetrics:
          datasourceUid: prometheus
          tags:
            - key: service.name
              value: service
          queries:
            - name: Latence p95
              query: histogram_quantile(0.95, sum(rate(traces_spanmetrics_latency_bucket{$$__tags}[5m])) by (le))
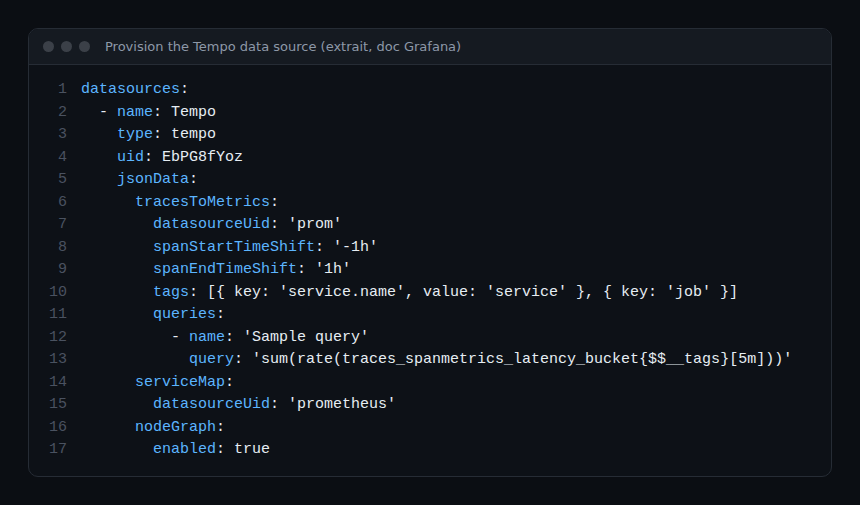
El UID prometheus es el que el chart da a su fuente Prometheus por defecto. El puerto 3200 es el puerto HTTP por defecto de Tempo, según la documentación de Grafana. Las claves serviceMap, nodeGraph y tracesToMetrics siguen el ejemplo de provisioning de la documentación.
Instala la pila:
helm install kube-prometheus-stack \
  oci://ghcr.io/prometheus-community/charts/kube-prometheus-stack \
  -n monitoring --create-namespace -f kps-values.yaml
Paso 2: instalar Grafana Tempo con el metrics-generator
En el chart tempo, el metrics-generator está desactivado por defecto (enabled: false). El valor remoteWriteUrl sirve como punto de escritura cuando storage.remote_write está vacío. La documentación de Tempo precisa que los procesadores están desactivados por defecto: hay que activarlos en los overrides.
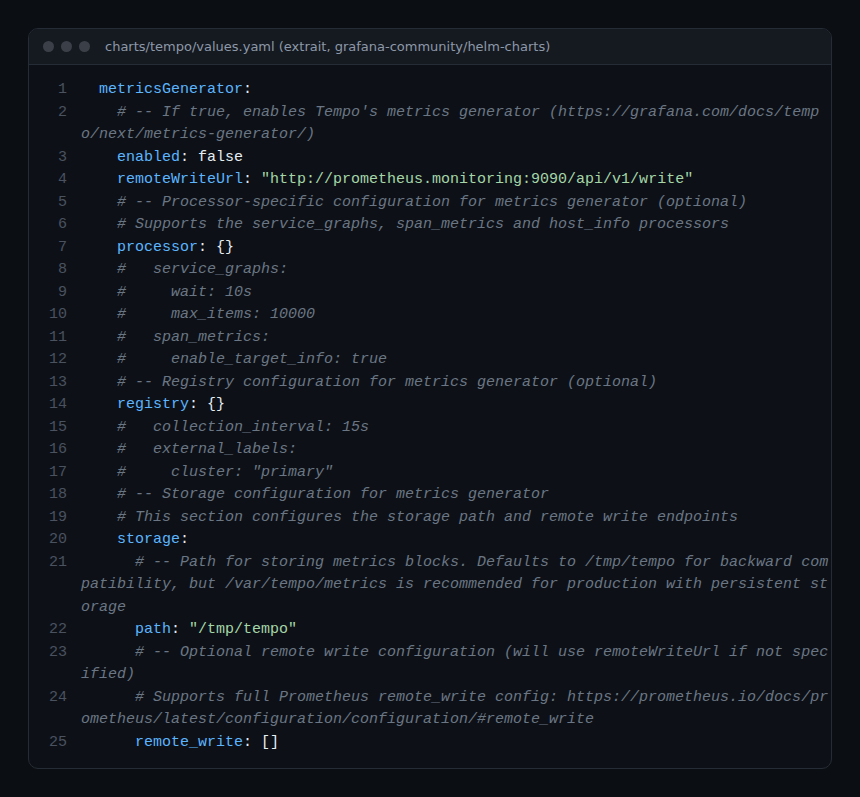
# tempo-values.yaml
tempo:
  metricsGenerator:
    enabled: true
    remoteWriteUrl: "http://kube-prometheus-stack-prometheus.monitoring:9090/api/v1/write"
  overrides:
    defaults:
      metrics_generator:
        processors:
          - service-graphs
          - span-metrics

serviceMonitor:
  enabled: true
Tres precisiones sobre este archivo.
service-graphsyspan-metricsson los nombres de procesadores de la documentación de Tempo. El primero produce las métricas de grafo de servicios, el segundo las métricas RED.serviceMonitor.enabledexiste en el chart. Permite que Prometheus recoja las métricas del propio Tempo, siempre que el paso 1 haya levantado el filtro de etiquetas.- El nombre del Service de Prometheus (
kube-prometheus-stack-prometheus) sigue la convención<release>-prometheusque el chart usa en su ejemplo. Confírmalo conkubectl -n monitoring get svc.
helm install tempo \
  oci://ghcr.io/grafana-community/helm-charts/tempo \
  -n monitoring -f tempo-values.yaml
La release se llama tempo: la plantilla del chart nombra entonces el Service tempo, lo que coincide con la URL de la fuente de datos del paso 1.
Paso 3: enviar trazas a Tempo
El chart abre los receptores OTLP en 0.0.0.0:4317 (gRPC) y 0.0.0.0:4318 (HTTP). Un Collector solo necesita un exportador OTLP hacia tempo.monitoring:4317. Para una primera prueba, la documentación de Tempo sugiere usar telemetrygen de OpenTelemetry o la aplicación de ejemplo «Intro to MLTP».
exporters:
  otlp/tempo:
    endpoint: tempo.monitoring:4317
    tls:
      insecure: true
Aquí, insecure: true sirve para una prueba dentro del clúster. En producción, activa TLS. Para no almacenar todas las trazas, consulta también nuestro artículo sobre el tail sampling con OpenTelemetry.
Cómo comprobar que funciona
- Comprueba los pods:
kubectl -n monitoring get podsdebe mostrar Tempo, Prometheus y Grafana enRunning. - En Grafana, abre Connections, luego Data sources, luego Tempo, y pulsa «Save & test». La documentación indica que un éxito muestra «Data source is working».
- En Explore, elige Tempo y busca una traza enviada en el paso 3.
- En Explore con la fuente Prometheus, consulta
traces_spanmetrics_calls_totalytraces_service_graph_request_total. Si esas series existen, el remote write funciona.
Los nombres de métricas proceden de la documentación de Tempo: traces_spanmetrics_latency (histograma), traces_spanmetrics_calls_total y traces_spanmetrics_size_total para las span metrics, con las etiquetas service, span_name, span_kind y status_code. Para los grafos de servicios, la misma documentación cita, entre otras, traces_service_graph_request_total y traces_service_graph_request_failed_total.
Buenas prácticas
- Vigila la cardinalidad. La documentación advierte de que más dimensiones activadas significan más cardinalidad. La etiqueta
status_messageestá desactivada por defecto por este motivo. - Persiste los datos. El chart declara
persistence.enabled: falsepor defecto y la retención por defecto (retention) es de 24 h. Adapta ambos a tus necesidades. - Relee la retención antes de una actualización. El README del chart describe una corrección en la aplicación de la retención en la versión 3.2.0.
- Mantén un único camino de métricas. Si tu Collector ya genera span metrics, evita producirlas dos veces. Nuestro artículo OpenTelemetry y Prometheus ayuda a repartir los papeles.
- Prueba antes de producción. Los valores por defecto (almacenamiento en
/tmp/tempo) sirven para probar, no para operar.
Preguntas frecuentes
¿Hace falta el chart tempo o tempo-distributed?
El chart tempo despliega Tempo en un solo binario, lo que conviene a volúmenes modestos. El chart tempo-distributed despliega los microservicios para escalar. La documentación de Tempo presenta ambos sin recomendar solo uno.
¿Por qué Prometheus rechaza las escrituras del metrics-generator?
Casi siempre, enableRemoteWriteReceiver se quedó en false, su valor por defecto en el chart. Comprueba también la URL remoteWriteUrl y los logs de Tempo.
¿Se puede usar Tempo además de Dynatrace?
OpenTelemetry separa la producción de las trazas de su destino. Un Collector puede, en teoría, enrutar hacia varios exportadores OTLP. Esta configuración doble no se detalla aquí y requiere una prueba en tu entorno. Para Dynatrace, consulta nuestra guía de Prometheus y Dynatrace.
Conclusión
Con dos archivos de valores, Grafana Tempo se une a kube-prometheus-stack: las trazas van a Tempo, las métricas RED y los grafos de servicios a Prometheus, y Grafana relaciona ambos. Después, amplía la pila con alertas sobre las span metrics y SLO.
Fuentes
- Chart kube-prometheus-stack (README, values.yaml, Chart.yaml)
- Chart tempo, repositorio grafana-community/helm-charts
- Tempo: desplegar con Helm, documentación de Grafana
- Metrics-generator, documentación de Tempo
- Provision the Tempo data source, documentación de Grafana
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Grafana Labs. Dynatrace es una marca de Dynatrace LLC. Los nombres de productos citados pertenecen a sus propietarios; las versiones y los valores son los leídos en la documentación y en los charts en la fecha indicada, y las direcciones de ejemplo son ficticias. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.