تمر كل سجلاتكم في المسار نفسه، وتُطبَّق قاعدة المعالجة نفسها على خدمة الدفع وعلى job اختبار. يوضح هذا الدرس كيفية إنشاء pipeline OpenPipeline وتوجيه السجلات إليه: pipeline خاص بخدمة، ومسار يرسل إليه سجلاتها، وخطة لبقية التدفق.
بالنسبة لفريق SRE أو المنصة، هذه نقطة البداية للتحكم في الحجم والاحتفاظ والصلاحيات على السجلات. يعتمد OpenPipeline على Grail، لذا ينطبق المحتوى على Dynatrace SaaS. ولا ينطبق على Dynatrace Managed الذي لا يملك Grail ولا OpenPipeline.
الهدف: في النهاية يستقبل pipeline سجلات مخصص سجلات deployment واحد في Kubernetes فقط، من دون المساس بالباقي. وتُضاف حالات الاستخدام (الإخفاء والمقاييس والحجم) لاحقًا فوق هذا الأساس؛ وتُعالَج في مقالات أخرى مرتبطة أدناه.
المتطلبات
- بيئة Dynatrace SaaS (Grail وAppEngine) مع صلاحية بمستوى مسؤول: تذكر الوثائق أنها ضرورية لإنشاء المسارات والـ pipelines.
- سجلات مُستوعَبة بالفعل بسمات قابلة للاستخدام، مثل
k8s.namespace.nameوk8s.deployment.name(راجع وحدة السجلات وOpenPipeline). - إلمام بلغة DQL: شرط المسار استعلام DQL.
- اختياري: bucket مخصص في Grail إذا كانت هذه الخدمة تتطلب مدة احتفاظ أو صلاحيات خاصة. أنشئه قبل الـ pipeline.
فهم pipeline OpenPipeline ومساره
يصل السجل عبر مصدر استيعاب، ثم يُوجَّه إلى pipeline. التوجيه ديناميكي (يقرره شرط DQL) أو ثابت (يحدد مصدر مخصص pipeline ثابتًا). تؤكد الوثائق نقطة مهمة: ترتيب قائمة المسارات يحدد ترتيب التنفيذ. وإذا لم يطابق أي مسار، يتبع السجل المسار الافتراضي (Default route).
توجد عائلتان من الـ pipelines. تستقبل الـ pipelines المدمجة (built-in) البيانات من دون ضبط وترسلها إلى bucket Grail المدمج. أما الـ pipelines المخصصة فهي ملكك؛ وتوصي الوثائق بتوجيه أكبر قدر ممكن من البيانات إليها بشروط صريحة.
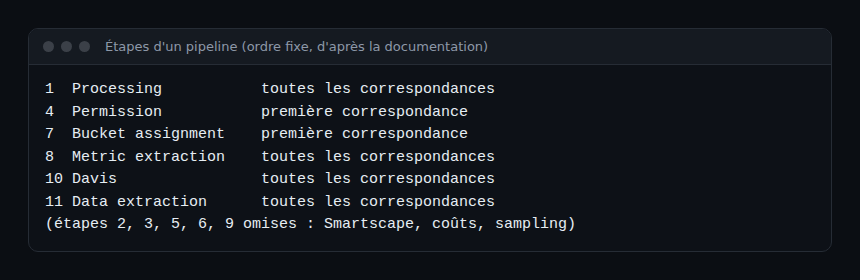
يمر كل pipeline بمراحل بترتيب ثابت. لكل معالج (processor) في مرحلة شرط مطابقة (matcher) بلغة DQL، ويغذي خرج المعالج المعالج التالي.
الخطوة 1: تحديد ما يجب توجيهه
قبل إنشاء أي شيء، ابحث في Notebook عن السمات التي تعرّف خدماتك. تقترح الوثائق هذا الاستعلام:
fetch logs
| filter k8s.namespace.name == "prod"
| summarize by:{k8s.deployment.name}, count()
تعطي النتيجة عدد المسارات المفيدة وشرط كل منها. فضّل سمة ثابتة (deployment أو namespace) على جزء من رسالة يتغير مع الشيفرة.
الخطوة 2: إنشاء الـ pipeline
- افتح Settings > Process and contextualize > OpenPipeline، واختر configuration scope الخاص بـ Logs، ثم تبويب Pipelines.
- اختر Pipeline وأدخل اسمًا، مثل «Checkout service pipeline».
- لكل مرحلة مفيدة، أضف معالجًا: اسمًا وشرط مطابقة ثم الحقول الخاصة بالمعالج.
- انقر على Save.
يبدأ الـ pipeline المنشأ بهذه الطريقة فارغًا: لا يفعل شيئًا ما دمت لم تضف إليه معالجًا. وهذا مقصود، فيمكنك إنشاء المسار أولًا وإضافة قواعد المعالجة لاحقًا، مثل قواعد إخفاء البيانات الحساسة.
الخطوة 3: إنشاء المسار الديناميكي
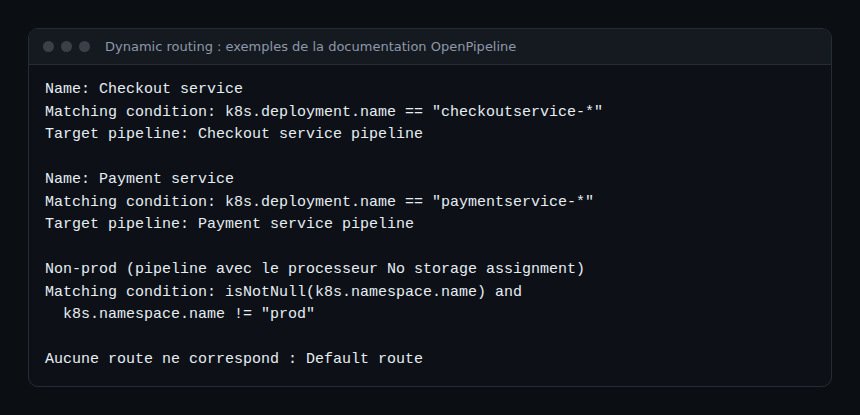
افتح تبويب التوجيه الديناميكي (Dynamic routing) ثم Dynamic route. حدد ثلاثة عناصر: اسمًا وشرط مطابقة وpipeline الهدف.
Name: Checkout service
Matching condition: k8s.deployment.name == "checkoutservice-*"
Target pipeline: Checkout service pipeline
تذهب السجلات التي تستوفي الشرط إلى pipeline الهدف. وحرف البدل * مأخوذ من مثال الوثائق: يغطي أسماء pods أو deployments ذات اللاحقة.
الخطوة 4: تقرير مصير الباقي
تواصل سجلات الإنتاج التي لا تطابق أي شرط جديد طريقها إلى المسار الافتراضي، أي إلى الـ pipeline الكلاسيكي. وهذا مفيد للانتقال خدمة بخدمة من دون كسر الموجود.
تعطي الوثائق أيضًا حالة لما هو خارج الإنتاج: شرط isNotNull(k8s.namespace.name) and k8s.namespace.name != "prod"، مقترن بـ pipeline يستخدم المعالج No storage assignment كي لا تُخزَّن هذه السجلات. قِس أولًا فائدتها: المسار الذي يستبعد سجلات قرار يخص الاحتفاظ، ويجب التحقق منه مع الفرق المعنية.
كيف تتحقق من أن الأمر يعمل
انتظر بضع دقائق بعد الحفظ: لا ينطبق التوجيه إلا على السجلات التي تُستوعَب بعد ذلك، وليس على السجلات المخزنة سابقًا (وهذا سلوك متوقع لمعالجة تتم عند الاستيعاب). أنشئ حركة مرور أو انتظرها، ثم تحقق من الحجم في Notebook:
fetch logs, from:now()-30m
| filter matchesValue(k8s.deployment.name, "checkoutservice-*")
| summarize count()
لرؤية أثر الـ pipeline نفسه، أضف إليه معالجًا بسيطًا (مثل حقل من اختيارك عبر المعالج Add fields) وابحث عن هذا الحقل في السجلات الجديدة. إذا كان مفقودًا، تحقق بهذا الترتيب: شرط المسار، وموضع المسار في القائمة، وشرط المعالج.
ضع في اعتبارك الحدود لكل configuration scope، وفق الوثائق.
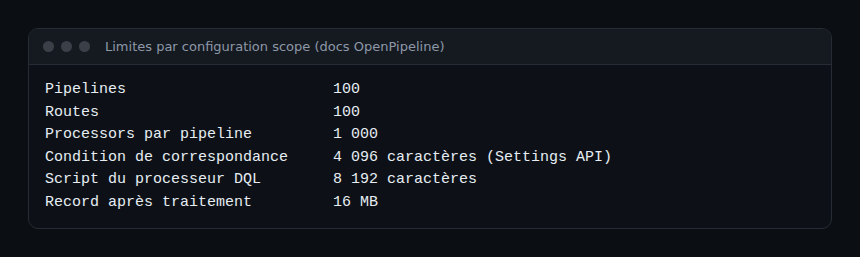
أفضل الممارسات
- pipeline لكل خدمة أو لكل فريق: يستطيع مالك الـ pipeline إدارة الوصول إليه، وهذا غير متاح للتوجيه (تذكر الوثائق أن التحكم بحسب المالك يخص الـ pipelines ومصادر الاستيعاب، لا المسارات).
- شروط صريحة لا «كل شيء»: توصي الوثائق بذلك للـ pipelines المخصصة.
- راقب ترتيب المسارات: الموضع في القائمة يحدد ترتيب التنفيذ. لا تصف الوثائق ما يحدث عندما تتطابق عدة مسارات؛ تجنب الشروط المتداخلة.
- أدِر الإصدارات للـ pipelines والمسارات عبر الضبط ككود (راجع الأسلوب نفسه للمقاييس)، وتابع الاستيعاب عبر مراقبة السجلات.
- الصلاحيات: بالنسبة للـ pipelines، تذكر الوثائق
settings:objects:readوsettings:objects:write(المالك) وsettings:objects:admin(المسؤول).
الأسئلة الشائعة
ما الفرق بين التوجيه الديناميكي والثابت؟
يعتمد التوجيه الديناميكي على شرط DQL. أما التوجيه الثابت فيرسل كل شيء إلى pipeline ثابت، لكن فقط لمصدر استيعاب مخصص؛ وبالنسبة لهذه المصادر تُتجاهل مطابقة أي مسار آخر.
ماذا يحدث للسجلات التي لا تطابق أي مسار؟
تمر عبر المسار الافتراضي. في مثال الوثائق، تواصل سجلات الإنتاج غير المشمولة طريقها إلى الـ pipeline الكلاسيكي.
وماذا عن Dynatrace Managed؟
OpenPipeline غير موجود في Managed. يمكن إجراء الفرز في مرحلة سابقة، مثلًا في OpenTelemetry Collector قبل الإرسال (راجع استيعاب السجلات عبر API).
الخلاصة
يتلخص إنشاء pipeline OpenPipeline في ثلاث خطوات: تحديد السمات، وإنشاء الـ pipeline، وكتابة المسار بشرط صريح. أما الباقي (الإخفاء والمقاييس والـ buckets) فيُضاف إلى الـ pipeline من دون المساس بالخدمات الأخرى. ابدأ بخدمة واحدة، وتحقق عبر Notebook، ثم وسّع النطاق.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC. Dynatrace علامة تجارية لشركة Dynatrace LLC. تتغير أسماء الشاشات والحدود: تحقق منها في الوثائق الرسمية لـ OpenPipeline.