Le métier demande un SLO sur les commandes validées, l’équipe paiement veut suivre les refus par motif, l’exploitation veut compter les erreurs d’un batch qui n’écrit que des logs. Aucune de ces valeurs n’existe dans les métriques intégrées. Il faut créer une métrique custom Dynatrace, et le choix de la méthode compte autant que la métrique elle-même : il détermine la cardinalité possible, le coût, et ce qu’il faudra modifier le jour où la source change.
Ce guide compare les quatre façons de créer une métrique custom Dynatrace : les calculated service metrics (à partir des traces), les log metrics (à partir des logs), l’ingestion par la Metrics API (depuis un script ou une application), et le OneAgent SDK, qui ne crée pas de métrique mais fournit la matière première. Chaque méthode est illustrée par un exemple et une vérification.
Le contenu couvre Dynatrace Managed et Dynatrace SaaS. Les différences sont signalées : en SaaS sur Grail, OpenPipeline devient la voie recommandée pour extraire des métriques des logs et des spans, et la syntaxe de requête passe du metric selector à DQL.
Quelle méthode pour créer une métrique custom Dynatrace
| La donnée est dans… | Méthode | Préfixe de clé | Plateformes |
|---|---|---|---|
| Les requêtes d’un service (traces) | Calculated service metric | calc:service. |
Managed, SaaS (OpenPipeline recommandé sur Grail) |
| Les logs | Log metric | log. |
Managed, SaaS (OpenPipeline Metric extraction sur Grail) |
| Un script, un job, une application | Metrics API ingest | Libre (sauf dt.) |
Managed, SaaS |
| Une technologie non instrumentée | OneAgent SDK, puis calculated metric | calc:service. |
Managed, SaaS |
Règle simple : si la donnée passe déjà par Dynatrace (traces, logs), dérivez la métrique de cette donnée plutôt que de l’envoyer une seconde fois. Réservez l’ingestion aux valeurs que Dynatrace ne voit pas. Pour les bases (types de métriques, dimensions, résolution), voir le module « comprendre les métriques ».
Méthode 1 — Calculated service metrics (traces)
Dynatrace capture déjà chaque requête de service. Une calculated service metric en extrait une valeur (temps de réponse, nombre de requêtes, valeur d’un request attribute…) pour les requêtes qui remplissent des conditions, avec un découpage optionnel par dimension.
Étapes
- Allez dans Settings > Server-side service monitoring > Calculated service metrics > Create new metric.
- Donnez un nom : Dynatrace préfixe automatiquement la clé par
calc:service.. - Choisissez la Metric source. Pour un request attribute, sélectionnez l’unité.
- Option : management zone, et Ignore muted requests.
- Ajoutez les conditions (toutes doivent être vraies), par exemple service = checkout et request attribute orderStatus = VALIDATED. L’aperçu liste les services concernés.
- Option : Split by dimension, avec un placeholder (ou un custom placeholder extrait par délimiteur ou regex) et le nombre de top values.
- Relisez la source et les noms de dimensions : ils ne pourront plus être modifiés. Save metric.
Limites à connaître
- Seules les nouvelles données alimentent la métrique : aucun calcul rétroactif.
- 500 calculated metrics actives par environnement, 100 par service.
- Règle « top X » : au plus 100 valeurs de dimension ; le reste est agrégé dans une dimension remainder.
Sur SaaS, la documentation recommande désormais d’extraire ces métriques des spans avec OpenPipeline : pas de limite de 500 métriques ni de règle top X, cardinalité complète, routage vers des buckets Grail. Pour les request attributes eux-mêmes, voir Distributed traces et PurePath.
Méthode 2 — Log metrics (logs)
Managed et Log Monitoring Classic
- Allez dans Settings > Log Monitoring > Metrics extraction et sélectionnez Add log metric (ou, depuis le log viewer, Create metric sur une requête).
- Metric key : complétez après
log., par exemplelog.paiement_refus. - Matcher : la requête qui filtre les logs, par exemple
status="error". - Measure : Occurrence of log records (comptage) ou Attribute value (moyenne, somme, min, max, médiane, percentiles d’un attribut numérique).
- Add dimension : par exemple le process group instance, pour savoir où se produisent les erreurs.
Deux pièges. La métrique n’existe qu’à partir des logs ingérés après sa création. Et modifier la clé crée une nouvelle métrique : l’historique reste sous l’ancienne clé. Sur Managed, la documentation cite une limite de 1 000 000 de dimensions par métrique et 50 000 000 pour l’ensemble ; la création de métriques à partir de logs supprimés (dropped logs) n’y est pas disponible.
SaaS sur Grail : OpenPipeline
Dans OpenPipeline, l’étape Metric extraction propose les processeurs Counter metric (compte les enregistrements), Value metric (gauge à partir d’un champ numérique) et Histogram metric (distribution), plus des variantes pour spans échantillonnés. Chaque processeur a une condition DQL, une clé et des dimensions ; l’enregistrement source n’est pas modifié.
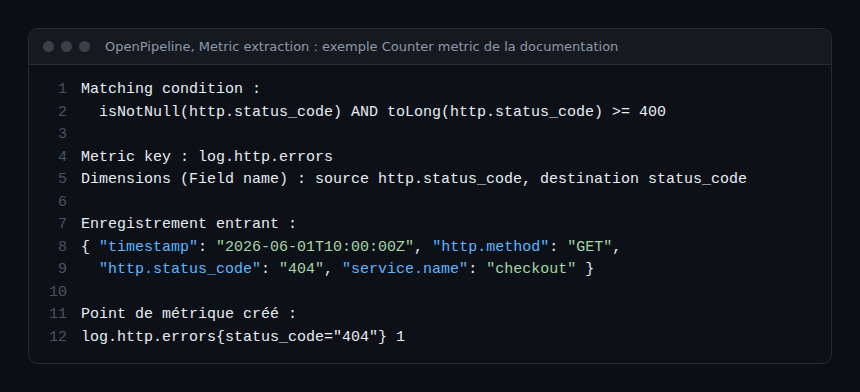
Pour les histogrammes, voir métriques histogrammes avec OpenPipeline.
Méthode 3 — Ingestion par la Metrics API
Pour une valeur que Dynatrace ne voit pas (résultat d’un job, compteur métier, mesure d’un équipement), envoyez-la avec POST /api/v2/metrics/ingest. Pas besoin de déclarer la métrique avant.
Le protocole
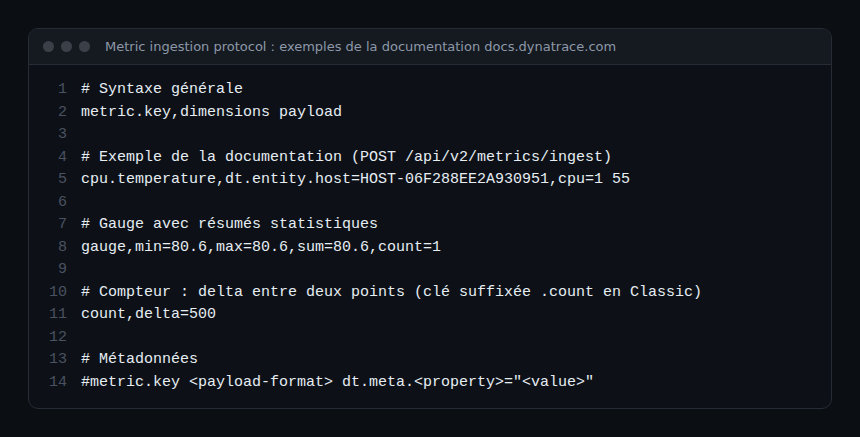
- Clé : sections séparées par des points, 3 à 255 caractères, lettres, chiffres, tirets et underscores ; pas de début par un chiffre ou un tiret. Le préfixe
dt.est réservé. - Jusqu’à 50 dimensions
clé="valeur"par ligne ;dt.entity.host=HOST-…rattache la mesure à un host. - Format
gauge(valeur ou min/max/sum/count) oucount,delta=…. En métriques Classic (Managed), une clé de type count reçoit le suffixe.count; les métriques Grail n’appliquent pas ce suffixe. - Horodatage optionnel en millisecondes UTC, accepté entre 1 heure dans le passé et 10 minutes dans le futur.
- Charge utile
text/plainlimitée à 1 Mo.
Exemple
# Jeton avec le scope metrics.ingest (Managed : https://{votre-domaine}/e/{id-environnement})
curl -s -X POST "https://{votre-domaine}/e/{id-environnement}/api/v2/metrics/ingest" \
  -H "Authorization: Api-Token {token}" \
  -H "Content-Type: text/plain; charset=utf-8" \
  --data-binary $'#shop.orders.validated gauge dt.meta.displayName="Commandes validées"\nshop.orders.validated,channel="web",country="fr" 42'
La réponse 202 renvoie linesOk et linesInvalid ; un 400 signale des lignes invalides, les lignes valides étant tout de même acceptées. Lisez toujours ces compteurs dans vos scripts.
Sur un host équipé de OneAgent, le module EEC expose aussi http://localhost:14499/metrics/ingest (port par défaut), sans jeton : la dimension dt.entity.host est ajoutée automatiquement. C’est la solution la plus simple pour un cron local. En SaaS, la même API accepte un platform token ; l’exemple de la documentation indique le scope openpipeline:metrics:ingest.
Méthode 4 — OneAgent SDK : instrumenter d’abord
Le OneAgent SDK (Java, C/C++, Node.js, .NET, Python, PHP) sert à tracer ce que OneAgent ne voit pas seul : appels distants, requêtes de base de données, requêtes web, files et messages, exécution asynchrone, et capture de request attributes. Il ne crée pas de métrique directement. Le chemin est donc : instrumenter avec le SDK, capturer la valeur comme request attribute, puis créer une calculated service metric (méthode 1). Prérequis : OneAgent en mode full-stack sur le host et redémarrage de l’application après l’installation de OneAgent.
Comment vérifier que ça fonctionne
- Managed : ouvrez Data Explorer et cherchez la clé (
calc:service.…,log.…oushop.orders.validated). Une requête de contrôle :shop.orders.validated:splitBy("channel"):sum - SaaS : dans un Notebook, interrogez la métrique en DQL :
timeseries total = sum(shop.orders.validated), by:{channel} - Ingestion : vérifiez
linesInvalid = 0dans la réponse de l’API. - Log metric et calculated metric : générez un événement connu (une erreur de test) et vérifiez qu’il apparaît dans la minute suivante.
Une fois la métrique en place, transformez-la en alerte : voir créer une alerte Dynatrace pas à pas.
Bonnes pratiques
- Dériver des données existantes avant d’ingérer en double.
- Convention de nommage (
équipe.domaine.mesure) et métadonnéesdt.meta.displayNameetdt.meta.descriptiondès la première ligne. - Cardinalité maîtrisée : pas d’ID de commande, d’utilisateur ou d’URL complète en dimension.
- Clés figées : un renommage casse l’historique, les dashboards et les alertes.
- Jetons d’ingestion limités au scope
metrics.ingest.
Questions fréquentes
Pourquoi ma métrique ingérée s’appelle-t-elle soudain « .count » ?
En métriques Classic, une ligne au format count ajoute automatiquement le suffixe .count à la clé. Interrogez ma.cle.count, ou envoyez des gauges si vous voulez garder la clé telle quelle.
Ma calculated service metric est vide pour le mois dernier. Est-ce normal ?
Oui. Elle ne s’alimente qu’avec les requêtes postérieures à sa création. Pour une analyse rétroactive, utilisez Multidimensional analysis sur les traces conservées.
Log metric ou ingestion par API pour un batch qui écrit des logs ?
Si les logs sont déjà ingérés, la log metric évite une seconde chaîne à maintenir. Si le batch peut appeler une API et que ses logs ne sont pas collectés, l’ingestion directe est plus fiable qu’un parsing de texte.
Conclusion
Créer une métrique custom Dynatrace, c’est surtout choisir la bonne source : traces pour les services, logs pour ce qui n’existe que dans les logs, API pour le reste, SDK pour combler un trou d’instrumentation. Une métrique bien nommée, à cardinalité maîtrisée, devient un SLI fiable, une alerte et une ligne de dashboard.
Références : Metric ingestion protocol et Calculated metrics for services (documentation Managed), Metric extraction in OpenPipeline (documentation SaaS).
span.observer est un blog indépendant, non affilié à Dynatrace LLC. Dynatrace est une marque de Dynatrace LLC. Les informations proviennent de la documentation publique ; vérifiez limites et options sur votre version avant toute mise en production.