Un circuit breaker Elasticsearch est un garde-fou mémoire : quand une opération risque de saturer le heap de la JVM, Elasticsearch la rejette au lieu de laisser le nœud tomber en OutOfMemory. Le plus redouté est le breaker parent. Selon la documentation Elastic, il rejette les opérations quand sa limite est atteinte. Pour une équipe SRE, ce rejet est un signal utile, mais il se traduit par des erreurs côté clients : il faut savoir le lire.
Cet article montre comment reconnaître l’erreur, mesurer la pression mémoire, corriger les causes fréquentes, puis exporter les métriques JVM et breaker vers Dynatrace avec OpenTelemetry. Le contenu vaut pour Dynatrace SaaS ; les réglages Elasticsearch ne dépendent pas de Dynatrace.
Circuit breaker Elasticsearch : ce que dit le parent breaker
Elasticsearch utilise plusieurs breakers. Chaque breaker enfant surveille un type de consommation (fielddata, requêtes, requêtes réseau en vol), et le breaker parent surveille l’ensemble. D’après la page des réglages, voici les valeurs par défaut citées :
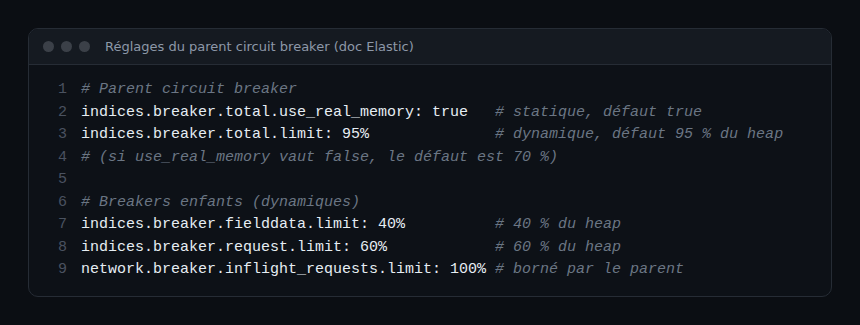
indices.breaker.total.use_real_memory: réglage statique,truepar défaut. Le parent tient alors compte de l’utilisation réelle de la mémoire, pas seulement de ce que réservent les breakers enfants.indices.breaker.total.limit: réglage dynamique. Défaut : 95 % du heap de la JVM siuse_real_memoryvauttrue, 70 % sinon.- Breakers enfants :
fielddataà 40 %,requestà 60 %,inflight_requestsà 100 % (borné par la limite du parent).
Le breaker request couvre les structures par requête, comme la mémoire des agrégations ; ES|QL partage ce breaker. Retenez surtout ceci : le parent se déclenche sur la mémoire réellement utilisée du nœud, donc un breaker enfant peut rester sous sa limite pendant que le parent bloque.
Reconnaître une CircuitBreakingException
La page de dépannage décrit l’erreur : Elasticsearch répond avec le statut HTTP 429, le type de l’erreur est circuit_breaking_exception et la reason commence par [parent] Data too large. Côté serveur, elasticsearch.log consigne une CircuitBreakingException. Ce dernier point aide quand un processus automatique, comme l’allocation de shards, déclenche le breaker sans qu’aucun client ne reçoive d’erreur.
Un 429 ne dit pas quelle requête a causé la saturation : celle qui échoue est souvent seulement la dernière arrivée. Traitez donc l’erreur comme un symptôme de pression mémoire, pas comme un défaut de la requête rejetée.
Étape 1 : mesurer la pression mémoire du heap
Le heap instantané oscille en dents de scie ; la page « high JVM memory pressure » recommande de suivre la pression mémoire JVM, une moyenne glissante liée au ramasse-miettes de l’ancienne génération. Le calcul par nœud est jvm.mem.pools.old.used_in_bytes divisé par max_in_bytes, multiplié par 100. La page fournit une commande jq sur une réponse de l’API node stats enregistrée. Voici le principe, avec des identifiants d’exemple :
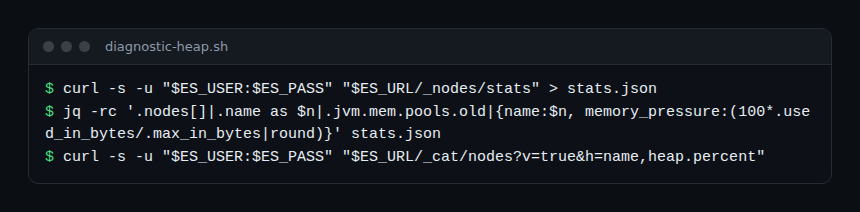
curl -s -u "$ES_USER:$ES_PASS" "$ES_URL/_nodes/stats" > stats.json
jq -rc '.nodes[]|.name as $n|.jvm.mem.pools.old|{name:$n, memory_pressure:(100*.used_in_bytes/.max_in_bytes|round)}' stats.json
Les seuils cités par Elastic : le breaker parent se déclenche par défaut à 95 % d’utilisation mémoire JVM, et la documentation conseille d’agir si l’utilisation dépasse durablement 85 %. Sur Elastic Cloud, les indicateurs passent au rouge à 75 %. La commande _cat/nodes avec la colonne heap.percent donne un coup d’œil rapide, mais c’est un pourcentage instantané.
Étape 2 : voir quel breaker a sauté
L’API node stats expose, pour chaque breaker, l’utilisation estimée, la limite, le nombre de déclenchements et le facteur de surcharge. Comparez le compteur de déclenchements du parent à ceux des enfants. Selon la page de dépannage, à partir de la version 9.3 une API dédiée, cat circuit breaker, donne une sortie tabulaire par breaker et par nœud. La page ne détaille pas la requête exacte : consultez la référence de votre version avant de l’automatiser.
Gardez en tête une limite que la documentation reconnaît : les breakers reposent sur des estimations ponctuelles. Des opérations parallèles, des agrégations, des requêtes complexes ou de la mémoire hors heap (piles de threads) peuvent encore provoquer un OOM.
Étape 3 : corriger les causes fréquentes
Avant de relever une limite, cherchez la cause. Relever indices.breaker.total.limit déplace le problème vers l’OOM. Les causes et pistes listées par Elastic :
- Fielddata sur un champ
text: désactivé par défaut. Si vous l’avez activé, passez par un champkeyword(multi-field). Sinon, l’API clear cache vide le cache, au risque de perturber les recherches en cours qui l’utilisent. - Taille du heap :
Xmségal àXmx, et pas plus de la moitié de la RAM du système ; vérifier les compressed OOPs (jvm.using_compressed_ordinary_object_pointers), souvent perdus au-delà d’environ 30 Go. - Swap : à désactiver ; contrôlez
os.swap.used_in_bytes. - Trop de shards ou de segments : chaque shard consomme de la mémoire ; moins de shards plus gros sont en général plus efficaces. Un force merge après la fin des écritures réduit les segments.
- Recherches coûteuses : activez les slow logs, puis envisagez
index.max_result_window,search.max_buckets,search.allow_expensive_queriesousearch.default_search_timeout(la page donne 5000, 20000,falseet"1m"comme exemples, pas comme valeurs recommandées). - Bulk et multi-search trop gros : envoyez des requêtes plus petites, plus espacées.
Si le heap reste haut malgré ces corrections, la documentation suggère une capture de heap dump pendant que la mémoire est élevée, ou d’augmenter la mémoire des nœuds.
Étape 4 : exporter les métriques JVM et breaker vers Dynatrace
Le receiver elasticsearch du Collector OpenTelemetry (distribution contrib, métriques en beta, Elasticsearch 7.9 minimum selon son README) interroge l’API du cluster. Son fichier de métriques liste, activées par défaut : elasticsearch.breaker.memory.estimated, elasticsearch.breaker.memory.limit, elasticsearch.breaker.tripped, jvm.memory.heap.used, jvm.memory.heap.max, ainsi que jvm.memory.pool.used et jvm.memory.pool.max. La métrique jvm.memory.heap.utilization existe mais est désactivée par défaut. Avec la sécurité active, l’utilisateur a besoin du privilège de cluster monitor ou manage.
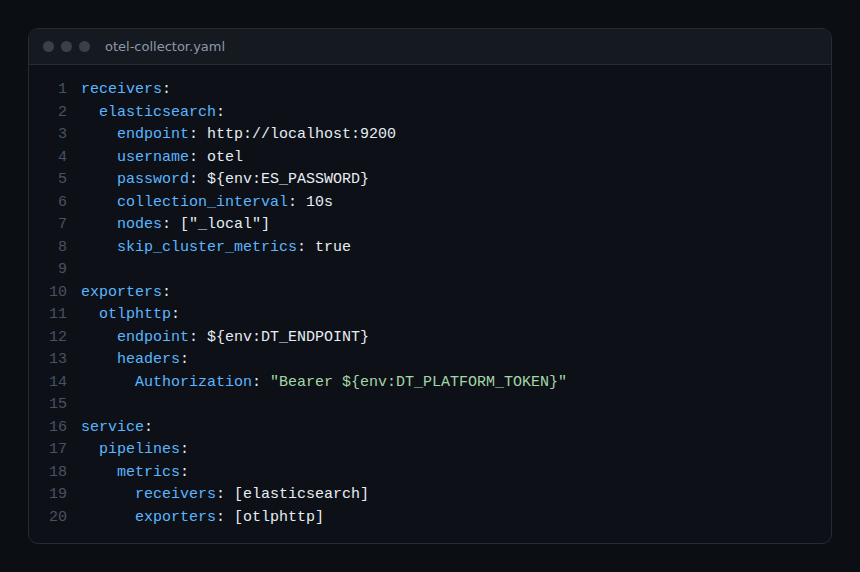
La configuration reprend les paramètres du README (nodes: ["_local"] pour un receiver par nœud ; skip_cluster_metrics à true évite les métriques de cluster en double). L’envoi vers Dynatrace, le token et le processeur cumulativetodelta sont détaillés dans notre guide du Collector vers Dynatrace ; voir le tutoriel sur le receiver elasticsearch. Adaptez les variables DT_ENDPOINT et DT_PLATFORM_TOKEN et ne commitez jamais le token.
Comment vérifier que ça fonctionne
- Ajoutez l’exporteur
debugau pipeline : les métriqueselasticsearch.breaker.*etjvm.memory.*doivent apparaître dans les logs du Collector. - Dans Dynatrace, cherchez ces noms de métriques et construisez une série par nœud ; la requête DQL est décrite dans l’article sur les requêtes DQL timeseries.
- Créez une alerte sur la hausse de
elasticsearch.breaker.trippedet une autre sur l’utilisation du heap proche du seuil de 85 % cité par Elastic. Ajoutez une alerte d’absence de données : un nœud qui ne répond plus ne produit plus de point.
Ce que ça change pour une équipe SRE
Un 429 de breaker consomme de l’error budget d’un SLI de disponibilité des recherches ou de l’ingestion. Mettez les seuils sur la tendance de la pression mémoire plutôt que sur l’erreur, pour agir avant le rejet. Écrivez le runbook en mode blameless : la requête qui échoue est rarement la seule responsable. Pour comparer cette approche à une solution intégrée, voir le comparatif Dynatrace et Datadog ; pour la différence entre mesurer et comprendre, voir observabilité et monitoring.
Bonnes pratiques
- Corrigez la cause (fielddata, shards, requêtes) avant de modifier une limite de breaker.
- Suivez la pression mémoire de l’ancienne génération, pas seulement le heap instantané.
- Alertez avant 95 % : la documentation propose 85 % comme seuil d’action.
- Épinglez la version du Collector : le receiver est en beta.
Questions fréquentes
Quelle limite par défaut pour le breaker parent ?
95 % du heap de la JVM quand indices.breaker.total.use_real_memory vaut true (le défaut), 70 % sinon, d’après la documentation Elastic.
Faut-il augmenter indices.breaker.total.limit ?
Rarement. La documentation oriente vers la réduction de la pression mémoire. Relever la limite laisse moins de marge avant un OutOfMemory.
Quel code HTTP renvoie un breaker déclenché ?
Un statut 429, avec une erreur circuit_breaking_exception dont la raison commence par [parent] Data too large.
Conclusion : le breaker parent protège le nœud, mais il révèle un heap sous tension. Mesurez la pression mémoire, trouvez la cause, puis exportez les métriques en OTLP pour être alerté avant le 429.
Sources officielles : réglages des circuit breakers, circuit breaker errors, high JVM memory pressure, receiver elasticsearch.
Cet article provient d’un blog indépendant, non affilié à Dynatrace LLC ni à Elastic N.V. Les noms de produits appartiennent à leurs propriétaires ; les identifiants et URL des exemples sont fictifs.