Module 1 du parcours Formation aux métriques Dynatrace Managed : comprendre les métriques avant de les interroger, c’est-à-dire savoir lire une clé, ses dimensions, son unité, ses agrégations et sa durée de vie.
Parcours : Formation aux métriques Dynatrace Managed · Module 1/7 · Durée : ~35 min · Niveau : Débutant à intermédiaire
Objectifs :
- Lire une clé de métrique et reconnaître son préfixe (builtin:, ext:, calc:)
- Distinguer dimensions, unité et agrégations d’une métrique
- Différencier les données de type gauge et count
- Savoir quelle résolution et quelle rétention s’appliquent aux séries temporelles
Prérequis : un accès en lecture à un environnement Managed et un jeton d’API avec le scope metrics.read pour l’exercice.
Un graphique de CPU qui montre 40 % alors que l’équipe système voit 90 % sur la machine : ce genre d’écart fait perdre une heure en plein incident. Il vient presque toujours d’une métrique mal lue, une moyenne prise pour un maximum ou une série fusionnée sur plusieurs hôtes. Pour comprendre les métriques de Dynatrace Managed, il faut savoir ce que contient une clé et comment Dynatrace agrège ses points.
Ce module pose ces bases. Il vaut pour Dynatrace Managed et pour les métriques dites « classiques » de Dynatrace SaaS ; les métriques stockées dans Grail (clés dt.*, commande DQL timeseries) sont traitées dans le parcours Métriques Dynatrace SaaS.
Comprendre les métriques : anatomie d’une clé
Chaque métrique a une clé unique, en minuscules, avec des points pour la hiérarchie. Le préfixe indique son origine :
| Préfixe | Origine | Exemple |
|---|---|---|
builtin: |
Métriques fournies par OneAgent et la plateforme | builtin:host.cpu.usage |
ext: |
Extensions OneAgent ou ActiveGate (et métriques classiques de l’intégration AWS) | selon l’extension |
calc: |
Métriques calculées que vous créez | module 7 |
uscm. / uacm. |
Métriques personnalisées USQL (sessions, actions utilisateur) | selon votre définition |
| aucun préfixe fixe | Métriques ingérées (protocole d’ingestion) | cpu.temperature |
Lisez la clé de gauche à droite : builtin:host.disk.avail se lit « métrique intégrée, famille hôte, sous-famille disque, espace disponible ». La liste complète figure dans la page Built-in metrics de la documentation Managed ; l’appel GET /api/v2/metrics donne celles réellement présentes dans votre environnement.
Le descripteur : dimensions, unité, agrégations
Chaque clé possède un descripteur, que l’API Metrics v2 renvoie. Voici l’exemple que donne la documentation pour l’espace disque disponible :
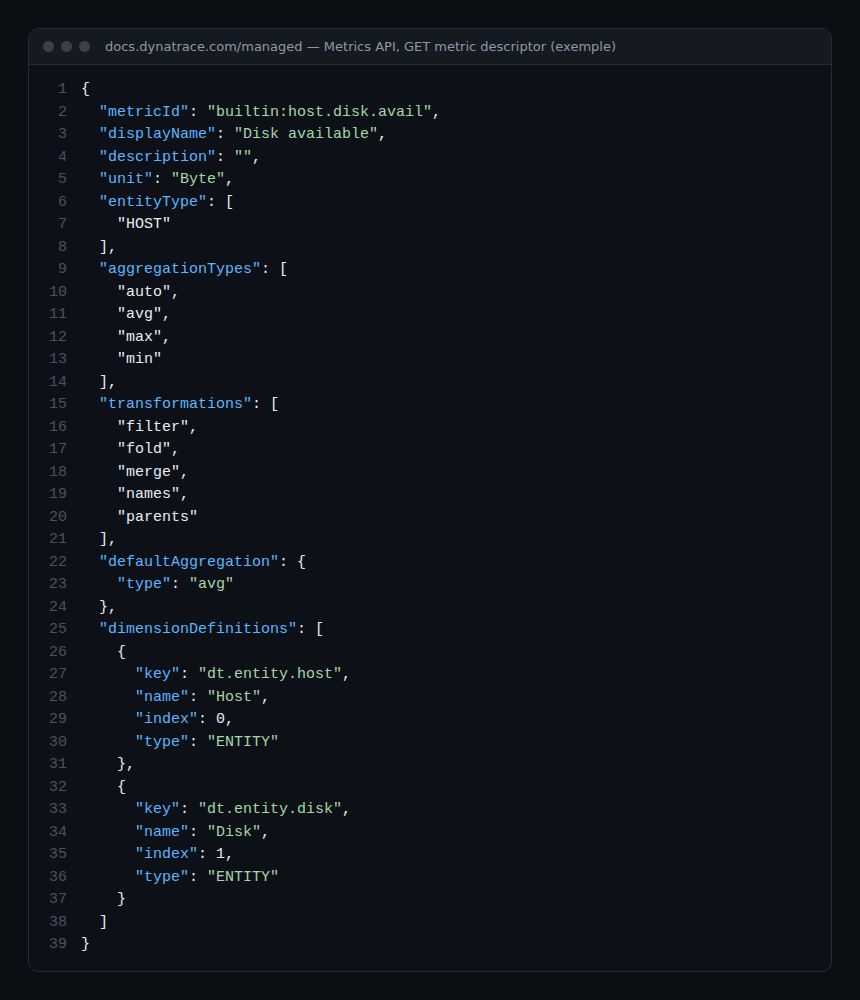
Quatre champs méritent votre attention :
unit: ici des octets. Les temps de réponse de service sont en microsecondes, ce qui surprend souvent la première fois.dimensionDefinitions: la découpe de la métrique. Une série existe par combinaison de valeurs, ici par hôte et par disque. La première dimension est une entité, ce qui permet de cibler la requête avec unentitySelector.aggregationTypes: les agrégations autorisées (auto,avg,max,min, et selon la métriquecount,sum,median,percentile,value).defaultAggregation: celle qu’on obtient sans rien préciser, ici la moyenne.
Ce dernier point explique l’écart du début : sans agrégation explicite, Dynatrace applique l’agrégation par défaut. Une moyenne sur une minute lisse les pics qu’un max aurait montrés.
Gauge ou count : deux natures de données
Le protocole d’ingestion distingue deux formats de points :
- gauge : une mesure à un instant (température, pourcentage de CPU, mémoire utilisée). Un point gauge peut porter un résumé
min,max,sum,count. - count : un compteur envoyé sous forme de delta (
count,delta=500). En métriques classiques, Dynatrace suffixe alors la clé par.count.
Dans les métriques intégrées, la même logique se lit dans les agrégations : builtin:service.requestCount.total n’accepte que auto et value, c’est un comptage ; builtin:host.cpu.usage accepte avg, max et min, c’est une jauge.
Résolution, rollups et rétention en Managed
Les métriques d’infrastructure sont mesurées toutes les 10 secondes et stockées en agrégats d’une minute (min, max, count, sum, moyenne). La finesse disponible dépend ensuite de l’âge de la donnée : Dynatrace Managed conserve les métriques 5 ans, mais en les regroupant par intervalles de plus en plus larges.
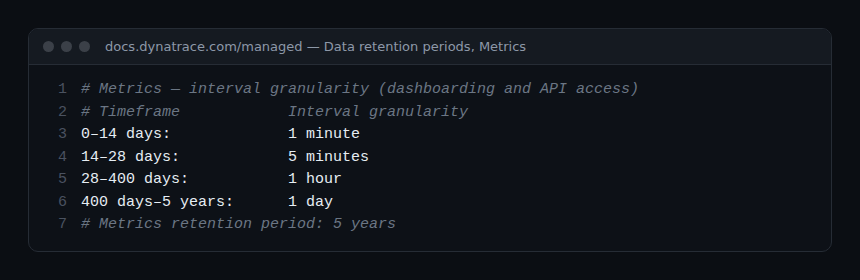
Conséquence pratique : un pic de deux minutes survenu il y a deux mois ne se voit plus, il est dilué dans une moyenne horaire. Si une analyse post-incident a besoin de la minute, faites-la dans les 14 jours. Dans un cluster Managed, ces séries sont stockées dans le dépôt de métriques (Cassandra) et répliquées sur trois nœuds ; l’article sur l’architecture de Dynatrace Managed détaille ce stockage.
À la requête, le paramètre resolution de l’API règle le pas : par défaut 120 points sur la période, ou un pas explicite comme resolution=10m. La résolution la plus fine est la minute.
Exercice pratique
Réalisez-le sur un environnement de recette ou de démonstration Managed.
Étape 1 — Lister les métriques hôte de votre environnement
export DT_URL="https://{votre-domaine}/e/{id-environnement}"
curl -s "$DT_URL/api/v2/metrics?metricSelector=builtin:host.*&fields=displayName,unit,aggregationTypes" \
  -H "Authorization: Api-Token $DT_TOKEN"
Résultat attendu : une liste de clés builtin:host.* avec leur nom et leur unité.
Étape 2 — Lire un descripteur
curl -s "$DT_URL/api/v2/metrics/builtin:host.cpu.usage" \
  -H "Authorization: Api-Token $DT_TOKEN"
Résultat attendu : l’unité Percent, l’agrégation par défaut avg et la dimension dt.entity.host.
Étape 3 — Comparer moyenne et maximum
Interrogez la même métrique avec builtin:host.cpu.usage:avg puis builtin:host.cpu.usage:max sur deux heures. Résultat attendu : des valeurs maximales nettement plus hautes que les moyennes sur un hôte chargé.
Étape 4 — Observer l’effet de l’âge
Dans le Data Explorer, affichez la même métrique sur 7 jours puis sur 60 jours. Résultat attendu : des points plus espacés sur la longue période, conformément au tableau de rétention.
Quiz
- Quel préfixe porte une métrique calculée ? a)
builtin:b)ext:c)calc:d)dt. - Que renvoie une requête sans agrégation explicite ? a) Le maximum b) L’agrégation par défaut du descripteur c) Toutes les agrégations d) Une erreur
- Quelle granularité reste disponible pour une métrique vieille de 3 mois ? a) 1 minute b) 5 minutes c) 1 heure d) 1 jour
- Comment est envoyé un point de type count ? a) Sous forme de delta b) Sous forme de min/max c) Sous forme de pourcentage d) Sous forme de log
Corrigé
- c) Les métriques calculées que vous créez portent le préfixe
calc:. - b) Le champ
defaultAggregationdu descripteur s’applique. - c) Entre 28 et 400 jours, la granularité est d’une heure.
- a) Le format count transporte la différence avec le point précédent.
Pour aller plus loin
- Module 4 de la formation Managed : explorer les données
- API Dynatrace Managed : endpoints et schémas
- Dashboards Managed : tuiles et JSON
- Metrics API v2 — GET metric descriptor
Sommaire du parcours · Module 2 : hôtes infrastructure →
Questions fréquentes
Pourquoi mon graphique Dynatrace ne correspond-il pas à top ou au Gestionnaire des tâches ?
L’outil système montre une valeur instantanée ; Dynatrace affiche par défaut une moyenne par intervalle, et l’intervalle grandit avec la période affichée. Demandez max et réduisez la période pour vous rapprocher de l’instantané.
Peut-on allonger la granularité d’une minute au-delà de 14 jours ?
La documentation de Managed présente ces paliers comme fixes pour les tableaux de bord et l’API. Pour garder un historique fin, exportez les séries utiles par l’API pendant qu’elles sont à la minute.
Les clés builtin: existent-elles aussi en SaaS ?
Oui, comme métriques classiques. Avec Grail, la plupart ont un équivalent dt.* interrogé en DQL ; le parcours SaaS traite cette correspondance.
Vous savez maintenant lire une clé, son descripteur et sa granularité. Le module suivant applique cette grille aux métriques d’hôte : CPU, mémoire, disque, réseau et disponibilité.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Ce parcours ne remplace pas les formations et certifications officielles de Dynatrace University. Vérifiez les fonctionnalités dans la documentation officielle de votre version.