Un agent de code sait écrire du Python, mais il écrit souvent du DQL comme du SQL. Il invente des noms de champs, oublie l’alignement temporel et lance des requêtes qui scannent des téraoctets pour rien. Le dépôt public Dynatrace for AI, publié par Dynatrace sur GitHub, s’attaque à ce problème : il donne aux agents le savoir métier qui leur manque avant qu’ils ne touchent à votre environnement.
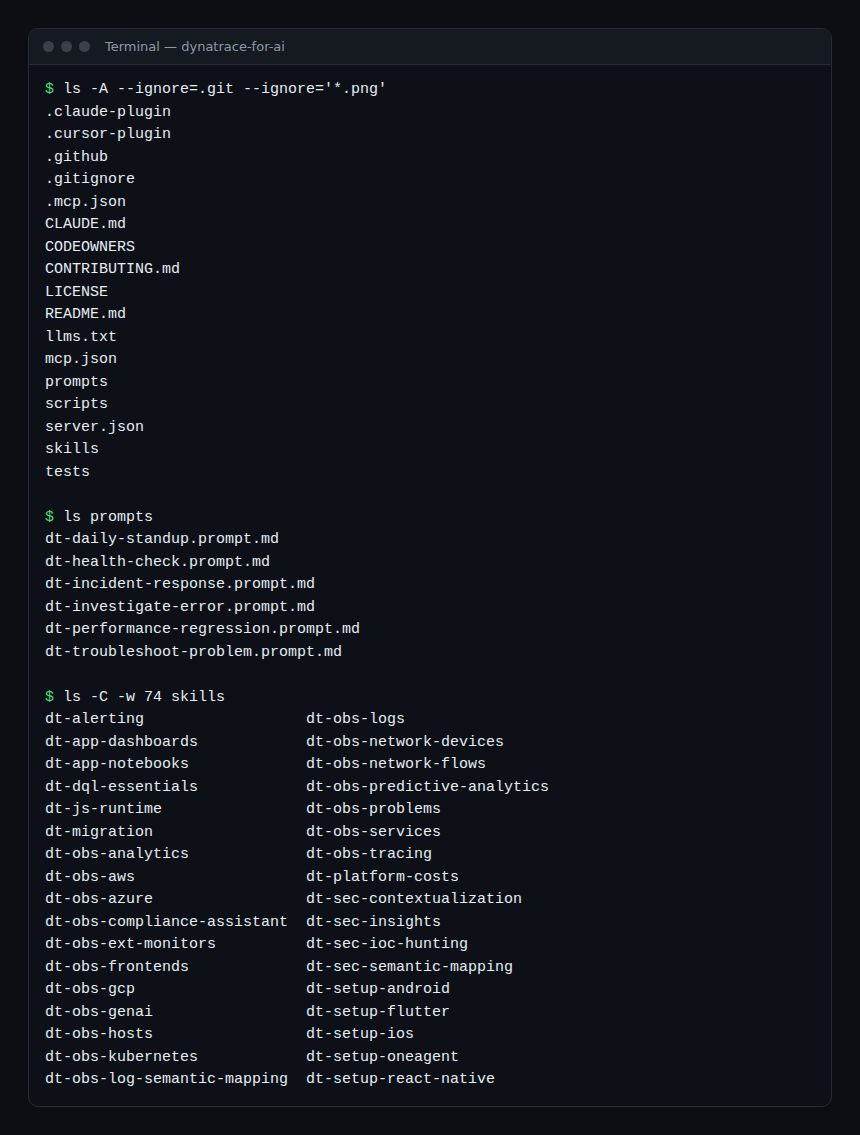
Ce dépôt n’est pas un nouveau produit. C’est un ensemble de fichiers texte : 34 skills au format ouvert Agent Skills, 6 prompts prêts à l’emploi, une configuration MCP, un manifeste pour le registre MCP officiel et un fichier llms.txt. Le tout est sous licence Apache-2.0.
Cet article fait le tour du contenu, montre comment l’installer dans les agents que le dépôt documente (Claude Code, Cursor, GitHub Copilot et quelques autres), déroule un parcours d’enquête pas à pas, puis précise ce que ça change par rapport au seul serveur MCP. Le périmètre est clair : les skills parlent de Grail, de DQL et des applications de la plateforme, donc de Dynatrace SaaS. Pour Dynatrace Managed, la question est traitée plus bas.
Ce que contient le dépôt Dynatrace for AI
À la racine, on trouve peu de choses, et chacune a un rôle précis.
| Élément | Rôle |
|---|---|
skills/ |
34 dossiers dt-*, chacun avec un SKILL.md et souvent un sous-dossier references/ |
prompts/ |
6 fichiers *.prompt.md : des scénarios d’enquête réutilisables |
mcp.json et .mcp.json |
La déclaration du serveur MCP distant de Dynatrace, paramétrée par variables d’environnement |
server.json |
Le manifeste publié sur le registre MCP officiel sous le nom io.github.Dynatrace/dynatrace-for-ai |
llms.txt |
Un résumé lisible par un modèle : ce qu’est Dynatrace, la liste des skills et prompts, l’installation |
.claude-plugin/, .cursor-plugin/ |
Les manifestes des plugins Claude Code et Cursor |
CLAUDE.md |
Les consignes chargées par Claude Code avec le plugin (variables à définir, usage des skills) |
tests/, scripts/ |
Contrôles de structure et de qualité des skills, cohérence des numéros de version |
Les skills, famille par famille
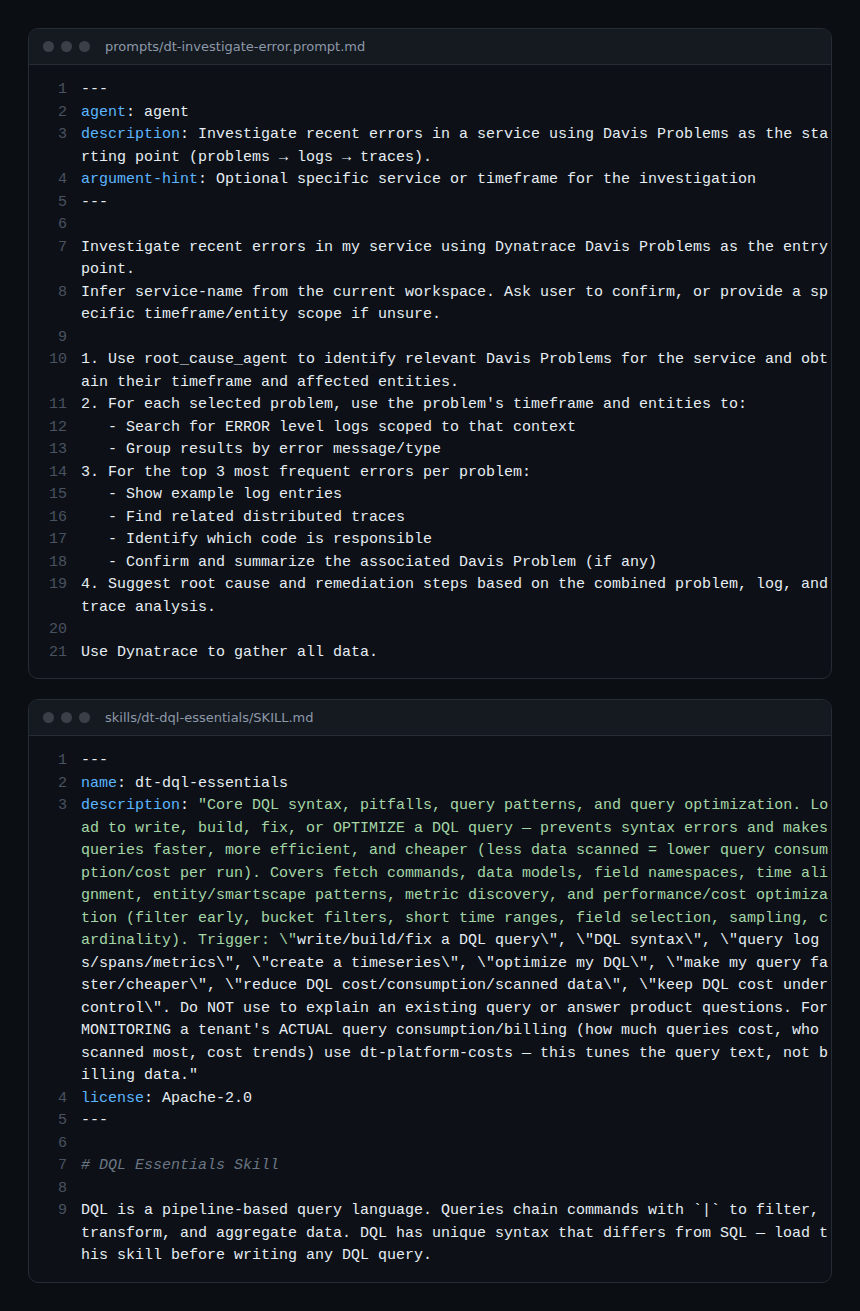
Un skill est un dossier dont le SKILL.md commence par un en-tête YAML (name, description, license). Les tests du dépôt vérifient que le nom correspond au dossier et que la description tient en 250 caractères. Les noms suivent le motif dt-<domaine>[-<usage>].
- Langage de requête :
dt-dql-essentials, le socle. Syntaxe DQL, pièges courants, optimisation du coût des requêtes. Le dépôt demande de le charger avant d’écrire la moindre requête. - Observabilité : services et métriques RED (
dt-obs-services), traces et spans (dt-obs-tracing), logs (dt-obs-logs), hôtes et processus (dt-obs-hosts), Kubernetes (dt-obs-kubernetes), RUM et Web Vitals (dt-obs-frontends), problèmes Davis (dt-obs-problems), clouds AWS, Azure et GCP, prévision et détection de tendance (dt-obs-predictive-analytics), analyseurs Davis (dt-obs-analytics), alerting de bout en bout (dt-alerting), applications GenAI (dt-obs-genai), équipements réseau SNMP et flux réseau, ingestion de résultats de tests externes (dt-obs-ext-monitors), mapping sémantique des logs d’audit. - Sécurité :
dt-sec-insights(tablesecurity.events), contextualisation des signaux, chasse aux indicateurs de compromission, mapping sémantique des intégrations sécurité, et un assistant de conformité DORA. - Instrumentation : OneAgent (VM, Kubernetes, AWS Lambda, Windows, Azure), Android, iOS, Flutter et React Native.
- Plateforme : Dashboards, Notebooks, runtime JavaScript côté serveur et SDK
@dynatrace-sdk/*, analyse des coûts et de la consommation DPS. - Migration :
dt-migration, pour passer du DQL classique basé sur les entités aux équivalents Smartscape.
Les prompts : six scénarios d’exploitation
Les prompts sont des modèles de tâche courts. Chacun décrit une démarche, pas une réponse.
dt-daily-standup: un point quotidien sur un ou plusieurs services.dt-health-check: l’état de santé d’un service en production.dt-incident-response: incident en cours, problèmes Davis actifs, impact, rapport partageable.dt-investigate-error: erreurs récentes, en partant des problèmes Davis vers les logs puis les traces.dt-performance-regression: un déploiement récent a-t-il dégradé les performances, rollback ou correctif.dt-troubleshoot-problem: enquête structurée sur un problème Davis existant.
À qui sert Dynatrace for AI
Trois profils y gagnent. Le développeur qui veut vérifier en production l’effet de son code sans quitter l’éditeur. Le SRE d’astreinte qui veut une enquête reproductible plutôt qu’une improvisation à 3 h du matin. L’équipe plateforme qui industrialise l’instrumentation (OneAgent, SDK mobiles) et veut que l’agent suive la procédure documentée plutôt qu’un souvenir approximatif.
Le point clé, rappelé par le README comme par llms.txt : les skills apportent du savoir, pas d’accès. Pour exécuter une requête réelle, il faut les associer à un outil : le serveur MCP de Dynatrace ou dtctl, la CLI open source de style kubectl.
Installer les skills dans votre agent
Le dépôt documente quatre voies. Choisissez-en une seule par poste.
- Paquet de skills (skills.sh), pour Claude Code, Cursor, Cline, GitHub Copilot, OpenCode et les agents compatibles :
npx skills add dynatrace/dynatrace-for-ai - Plugin Claude Code, qui embarque les skills et la configuration du serveur MCP :
export DT_ENVIRONMENT=https://<env>.apps.dynatrace.com
export DT_PLATFORM_TOKEN=<votre-platform-token>
claude plugin install dynatrace@claude-plugins-official
claude mcp login plugin:dynatrace:dynatrace   # vérifie la connexion
Le
https://est obligatoire dansDT_ENVIRONMENT. Le jeton doit au minimum porter les scopes du MCP gateway ; la liste complète est dans la documentation du serveur MCP. - Plugin Cursor : installation graphique uniquement, depuis Customize dans la barre latérale, avec les mêmes deux variables d’environnement définies avant le lancement.
- Manuel : copier les dossiers de skills dans le répertoire de l’agent (
.agents/skills/,.claude/skills/,.cursor/skills/…). Pour GitHub Copilot dans VS Code, copier aussi les prompts dans.github/prompts/: ils deviennent des commandes slash comme/dt-troubleshoot-problem.
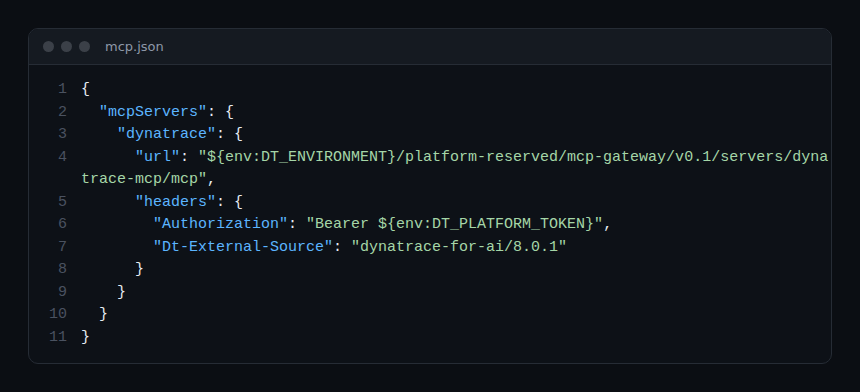
Côté connexion, le plugin référence un serveur MCP distant, hébergé par Dynatrace : rien à installer. Voici l’essentiel de mcp.json :
{
  "mcpServers": {
    "dynatrace": {
      "url": "${env:DT_ENVIRONMENT}/platform-reserved/mcp-gateway/v0.1/servers/dynatrace-mcp/mcp",
      "headers": {
        "Authorization": "Bearer ${env:DT_PLATFORM_TOKEN}",
        "Dt-External-Source": "dynatrace-for-ai/8.0.1"
      }
    }
  }
}
Le jeton ne vit jamais dans le fichier : il est lu dans l’environnement. L’en-tête Dt-External-Source identifie simplement la version du paquet. La mise en place détaillée du serveur est couverte dans notre guide MCP Dynatrace sur SaaS.
Parcours concret : enquêter sur des erreurs pas à pas
Scénario : le taux d’erreur d’un service de paiement monte après un déploiement. Vous travaillez dans Claude Code avec le plugin installé.
- Vérifier la connexion. Lancez
claude mcp login plugin:dynatrace:dynatrace. Sans cette étape, l’agent raisonnera dans le vide. - Charger le bon scénario. Collez le contenu de
prompts/dt-investigate-error.prompt.md. Il demande à l’agent de déduire le nom du service depuis l’espace de travail et de le faire confirmer. - Laisser l’agent partir des problèmes Davis. Le prompt impose l’ordre : problèmes, puis logs de niveau ERROR limités à la fenêtre et aux entités du problème, puis traces. Cet ordre évite la recherche plein texte sur trente jours.
- Observer le chargement progressif. L’agent n’a au départ que le nom et la description de chaque skill (environ 100 jetons chacun). Quand il écrit du DQL, il charge
dt-dql-essentials(moins de 5 000 jetons), puis seulement la référence utile, par exemplereferences/optimization.md. - Relire les requêtes. Demandez à l’agent d’afficher chaque requête DQL avant exécution. Vérifiez les filtres précoces et la plage de temps courte : c’est là que se joue le coût.
- Exploiter la synthèse. Le prompt se termine par trois erreurs prioritaires, des traces liées, le code en cause et une proposition de remédiation. Reportez-la dans le ticket d’incident.
Comment vérifier que ça fonctionne
- Dans Claude Code,
/plugindoit lister le plugin Dynatrace, et la commandeclaude mcp logindoit aboutir. - Posez une question qui exige du DQL : la réponse doit citer des champs du dictionnaire sémantique, pas des colonnes inventées.
- Relancez une requête produite par l’agent dans un Notebook : même résultat, sinon la requête ou les droits sont en cause.
Ce que ça change par rapport au seul serveur MCP
Le serveur MCP donne des mains à l’agent : exécuter du DQL, lister les problèmes. Il ne lui apprend pas à bien s’en servir. Les skills ajoutent le mode d’emploi : quels champs existent, quelles requêtes coûtent cher, quel ordre suivre dans une enquête. Notre article sur le serveur MCP Dynatrace du symptôme au correctif montre l’outil seul ; avec les skills, les mêmes appels deviennent plus justes et moins coûteux.
Pour un SRE, l’effet se mesure en MTTR : moins d’allers-retours sur des requêtes fausses, une démarche identique d’une astreinte à l’autre, moins de toil. Les prompts rendent l’enquête reproductible, ce qui facilite aussi le post-mortem blameless.
Autre nuance : le dépôt présente dtctl comme l’option recommandée dans la plupart des cas, car elle couvre aussi les SLO, dashboards, workflows et réglages, dans tout agent capable de lancer des commandes shell. Le serveur MCP reste le choix naturel quand l’agent parle MCP nativement. Pour le format lui-même, voir le Model Context Protocol expliqué, et pour l’équivalent côté éditeur, le plugin Dynatrace pour Cursor.
Limites à connaître
- Dynatrace Managed. Les adresses du dépôt pointent vers
*.apps.dynatrace.comet les skills reposent sur Grail, DQL et les applications de la plateforme. Ils visent donc Dynatrace SaaS. Pour un cluster Managed, lisez notre article MCP Dynatrace sur Managed avant d’envisager quoi que ce soit. - Savoir, pas vérité. Un skill réduit les erreurs, il ne les supprime pas. Relisez les requêtes et les modifications proposées.
- Contributions fermées sur les skills. Le contenu est maintenu en interne et publié périodiquement ; les pull requests qui modifient les skills sont refusées, il faut ouvrir une issue.
- Données. Le serveur MCP fourni se connecte à votre environnement ; le README renvoie à la politique de confidentialité de Dynatrace. Donnez au jeton le strict nécessaire.
Bonnes pratiques
- Installez tous les skills : le chargement progressif évite d’encombrer le contexte.
- Stockez
DT_PLATFORM_TOKENdans l’environnement ou un gestionnaire de secrets, jamais dans un dépôt. - Démarrez chaque enquête par un prompt du dépôt plutôt qu’une question libre.
- Faites valider par un humain toute action d’écriture (dashboard, workflow, réglage).
Questions fréquentes
Dynatrace for AI remplace-t-il le serveur MCP ?
Non. Les skills sont du savoir seul. Ils se combinent avec le serveur MCP ou avec dtctl pour accéder aux données.
Faut-il installer les 34 skills ?
Oui, le dépôt le recommande : l’agent ne charge d’abord que les noms et descriptions, puis le contenu complet uniquement quand il en a besoin.
Puis-je utiliser les prompts sans plugin ?
Oui. Copiez-les dans n’importe quel chat d’agent, ou dans .github/prompts/ pour GitHub Copilot dans VS Code. Chargez d’abord les skills qu’ils citent.
Conclusion
Dynatrace for AI comble l’écart entre un agent qui sait appeler une API et un agent qui sait enquêter. Commencez par le plugin ou npx skills add, branchez le serveur MCP, puis jouez un prompt d’enquête sur un incident passé pour juger la qualité des réponses avant de vous y fier en astreinte. La source fait foi : le dépôt GitHub et la documentation du serveur MCP.
span.observer est un blog communautaire indépendant, non affilié à Dynatrace LLC. Dynatrace est une marque de Dynatrace LLC. Cet article décrit un dépôt public à la date de rédaction (version 8.0.1) ; vérifiez la documentation officielle avant toute mise en production.