Vendredi, 16 h : la fenêtre de maintenance du cluster est réservée pour samedi matin et la version 1.350 vient d’apparaître dans la console. Avant de cliquer, une seule question compte pour l’astreinte : qu’est-ce que cette montée de version peut casser chez moi ? Les notes de version de Dynatrace Managed 1.350 se lisent plus vite quand on les parcourt avec cette question en tête, plutôt que ligne par ligne. Dynatrace présente aussi la version dans son billet de la série « release notes ».
Je trie donc le contenu en trois piles : ce qui exige une action de votre part, ce qui se fait tout seul pendant la mise à jour du cluster, et ce qui arrive dans les réglages sans rien changer tant que vous ne l’activez pas. Tout ce qui suit concerne uniquement Dynatrace Managed.
Cadre de lecture. Je n’ai pas appliqué cette version sur un cluster : tout vient de la page officielle des notes Managed 1.350, lue le 10 novembre 2026. Les points que je n’ai pas pu vérifier sont signalés dans le texte.
Dynatrace Managed 1.350 : une seule action obligatoire
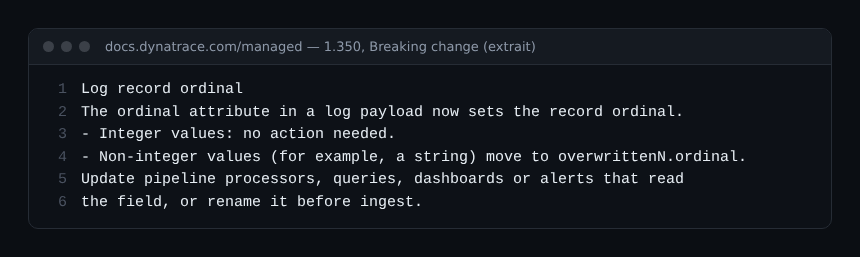
La page ne contient pas de section de consignes de mise à jour. Le seul point qui demande une intervention de votre part est le changement cassant sur les logs : l’attribut ordinal d’une charge utile de log fixe désormais l’ordinal de l’enregistrement. Si la valeur est un entier, rien à faire. Si c’est autre chose, par exemple une chaîne de caractères, elle est déplacée vers un attribut overwrittenN.ordinal, où l’indice N n’est pas prévisible.
Concrètement, cherchez dans vos processeurs de pipeline, requêtes, tableaux de bord et alertes toute lecture du champ ordinal. Deux issues sont possibles : adapter ces consommateurs, ou renommer le champ avant l’ingestion, ce qui évite l’indice imprévisible. Je ne sais pas dire, depuis les notes, combien de pipelines réels en dépendent : c’est un inventaire à faire chez vous.
Ce qui se règle sans vous : les composants du cluster
Le deuxième tas est rassurant pour une fenêtre courte. Elasticsearch passe en 8.19.18 par mises à jour progressives, sans étape manuelle ni indisponibilité, d’après la page. OpenSSL monte en 3.5.9 dans l’installeur Managed et dans NGINX, qui passe en 1.30.5. Côté sécurité, les notes mentionnent Java 21.0.13+9 et 17.0.21+9, ainsi que le retrait de confiance de certificats intermédiaires compromis d’un émetteur nommé dans la page (référence CVE-2026-114820). Je n’ai pas cherché le détail de cette référence : à lire dans la source avant d’en tirer un niveau de risque.
Pour une montée de version, ces lignes servent à une seule chose : cocher dans votre ticket de changement que les dépendances sont mises à jour par l’éditeur. Pour revoir la mécanique générale, relisez l’article sur les mises à jour du cluster Managed.
Corrections qui concernent l’exploitation du cluster
Trois correctifs touchent directement ceux qui gèrent un cluster, et valent d’être connus avant de les rencontrer en incident :
- l’ajout d’un nœud à un cluster Premium haute disponibilité échouait à cause d’un mauvais choix du nœud d’amorçage (PRISM-15770) ;
- la console de gestion du cluster signalait à tort un problème de connectivité avec un ActiveGate embarqué quand
dnsEntryPointpointait vers un hôte absent des URI de communication du nœud (PRISM-15764) ; - après une restauration de sauvegarde, certaines fonctions comme la page des hôtes ou le filtrage de Data Explorer reviennent seules peu après, alors qu’elles pouvaient rester indisponibles jusqu’à cinq jours.
Si votre dernier test de restauration a laissé ces écrans vides, c’est un bon motif pour le rejouer après la montée de version. Pour la méthode de diagnostic, voir le dépannage d’un cluster Managed.
Métriques : des alertes de limites, désactivées par défaut
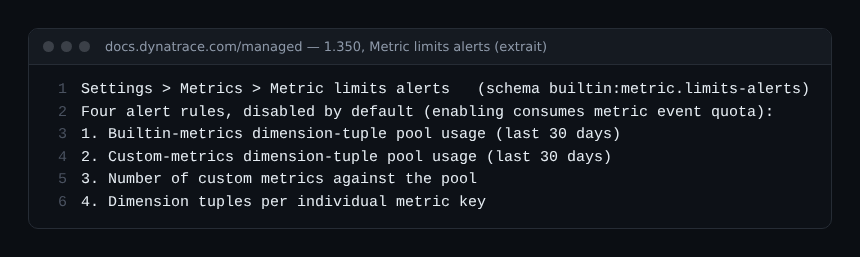
La nouveauté la plus utile pour un cluster qui grossit est l’alerte sur les limites de métriques, sous Paramètres, Métriques, « Metric limits alerts », et via l’API des paramètres avec le schéma builtin:metric.limits-alerts. Les configurations existantes sont migrées automatiquement. Quatre règles surveillent :
- l’usage du réservoir de combinaisons de dimensions des métriques intégrées sur 30 jours ;
- le même usage pour les métriques personnalisées ;
- le nombre de métriques personnalisées par rapport au réservoir ;
- le nombre de combinaisons de dimensions par clé de métrique.
Les quatre règles sont désactivées par défaut, et les activer consomme du quota d’événements de métriques. Décision d’exploitation : activez d’abord la règle par clé de métrique, qui désigne le coupable, plutôt que les trois règles de réservoir qui disent seulement que le plafond approche. Dans la même veine, le nombre de dimensions personnalisées conservées sur la fenêtre glissante de 30 jours a doublé, la mise en cache des requêtes de dimensions est améliorée et les motifs de rejet à l’ingestion à fort débit sont plus clairs.
Un opérateur supplémentaire apparaît dans le mode avancé de Data Explorer : asHistogram(<buckets>) affiche une métrique non histogramme sous forme d’histogramme, avec au plus 12 intervalles ; les visualisations existantes ne changent pas. Voir le guide de Data Explorer sur Managed.
Topologie, API et surveillance : trois évolutions à tester
Les attributs de ressource entrent dans le modèle de topologie : on les voit dans la section des propriétés des écrans d’entités et on peut s’en servir dans les règles d’entités surveillées et d’étiquetage automatique, pour les hôtes, processus, groupes de processus, conteneurs et groupes de conteneurs. Des attributs personnalisés se posent aussi sur les hôtes surveillés et les clusters Kubernetes via le fichier dt_metadata.properties. Cela réduit le besoin de balises posées à la main, mais je n’ai pas vérifié le comportement sur un parc réel.
Côté API, la mise à jour automatique de OneAgent sur un hôte (PUT /hosts/{id}/autoupdate et le validateur POST /hosts/{id}/autoupdate/validator) n’accepte plus que des versions supérieures à celle installée. Une version égale ou inférieure renvoie 400 Bad Request avec les deux versions dans le message. Si un script de gestion de parc « rétrograde » des agents, il échouera désormais : voir les points d’accès de l’API Managed.
Enfin, la supervision Go en mode statique fonctionne sous Linux sans la capacité ptrace et doit remplacer à terme l’option OneAgent « Go improved static monitoring ». Le support du shadow DOM arrive dans l’enregistreur Synthetic, avec des limites : 15 frontières imbriquées au maximum, seul l’hôte est enregistré pour un shadow root fermé, et les iframes dans un shadow root ne sont pas gérées.
Systèmes d’exploitation : repérez les dates avant le prochain changement
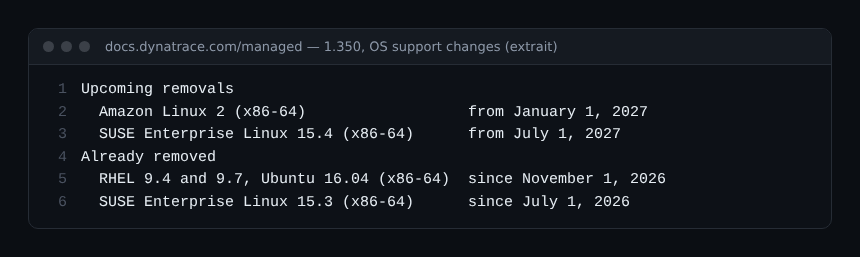
La page liste des retraits de support. Déjà effectifs : Red Hat Enterprise Linux 9.4 et 9.7 et Ubuntu 16.04 (x86-64) depuis le 1er novembre 2026. À venir : Amazon Linux 2 (x86-64) le 1er janvier 2027 et SUSE Enterprise Linux 15.4 (x86-64) le 1er juillet 2027. Si un nœud ou un hôte supervisé tourne sur l’une de ces distributions, ouvrez le ticket maintenant plutôt qu’à l’échéance.
Check-list de la fenêtre de maintenance
- Inventorier tout ce qui lit le champ
ordinaldes logs, avant la montée de version. - Vérifier la distribution de chaque nœud et des hôtes supervisés par rapport aux dates de retrait.
- Lancer la mise à jour du cluster, puis contrôler l’état de chaque nœud dans la console.
- Rejouer un test de restauration et vérifier la page des hôtes.
- Décider quelles règles d’alerte de limites activer, en commençant par celle par clé de métrique.
- Vérifier les scripts qui appellent l’API d’auto-update de OneAgent.
Bonnes pratiques
- Lisez les notes avec une question d’exploitation, pas comme un catalogue de nouveautés.
- Séparez ce qui est automatique de ce qui exige une décision humaine dans le ticket de changement.
- Activez les alertes de limites une par une pour mesurer leur coût en quota d’événements.
- Gardez le lien vers la page officielle dans le ticket : les notes peuvent être corrigées après leur publication.
Questions fréquentes
La version 1.350 impose-t-elle une action avant la mise à jour ?
D’après la page lue, la seule action requise est la revue de l’attribut ordinal des logs. Aucune section de consignes de mise à jour n’existe dans les notes. Vérifiez néanmoins la page à la date de votre intervention.
Les alertes de limites de métriques sont-elles actives après la montée de version ?
Non : les quatre règles sont désactivées par défaut et les activer consomme du quota d’événements de métriques. Les configurations existantes sont migrées automatiquement.
Ces notes valent-elles pour Dynatrace SaaS ?
Non, cet article ne couvre que Managed. Les versions et les composants décrits sont ceux de la page Managed 1.350 ; ne transposez rien au SaaS sans consulter ses propres notes.
Conclusion
Les notes de version Managed 1.350 se résument pour l’exploitant à un contrôle des logs, une vérification des systèmes d’exploitation et quelques réglages optionnels. Le reste des composants se met à jour avec le cluster. Préparez cette lecture avant la fenêtre de maintenance, pas pendant.
Ce blog est indépendant et non affilié à Dynatrace LLC. Les informations viennent de la documentation publique et peuvent évoluer ; vérifiez-les dans votre environnement.