Es viernes a las cuatro de la tarde. Has reservado la ventana de mantenimiento del clúster para el sábado por la mañana y la versión 1.350 acaba de aparecer en la consola. Antes de pulsar nada, al equipo de guardia le importa una sola pregunta: ¿qué puede romperse en mi entorno? Las notas de versión de Dynatrace Managed 1.350 se leen mejor con esa pregunta en la cabeza que de arriba abajo. Dynatrace también presenta la versión en su entrada de la serie de «release notes».
Por eso reparto el contenido en tres montones: lo que te exige actuar, lo que ocurre solo durante la actualización del clúster y lo que llega a los ajustes sin cambiar nada hasta que lo actives. Todo lo que sigue se refiere únicamente a Dynatrace Managed.
Un apunte de método. No he aplicado esta versión en ningún clúster: todo sale de la página oficial de las notas de Managed 1.350, leída el 10 de noviembre de 2026. Lo que no he podido comprobar queda marcado en el texto.
Notas de versión de Dynatrace Managed 1.350: una sola acción obligatoria
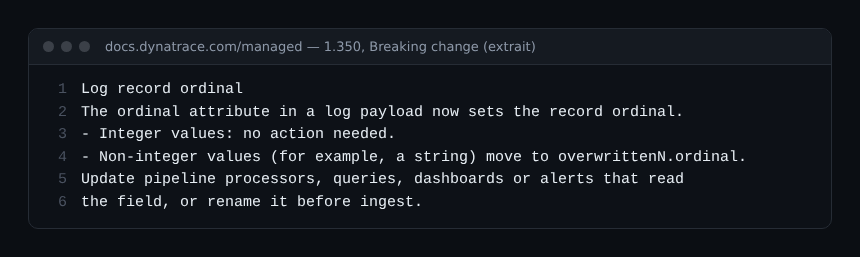
La página no incluye ninguna sección de instrucciones de actualización. Lo único que requiere tu intervención es el cambio incompatible en los logs: el atributo ordinal de una carga de log pasa a fijar el ordinal del registro. Si el valor es un entero, no tienes que hacer nada. Si es otra cosa, por ejemplo una cadena de texto, se mueve a un atributo overwrittenN.ordinal, cuyo índice N no se puede predecir.
En la práctica, busca en tus procesadores de pipeline, consultas, dashboards y alertas cualquier lectura del campo ordinal. Tienes dos salidas: adaptar esos consumidores o renombrar el campo antes de la ingesta, lo que evita el índice impredecible. Con las notas en la mano no sé decir cuántos pipelines reales dependen de él: ese inventario te toca hacerlo a ti.
Lo que se resuelve solo: los componentes del clúster
El segundo montón tranquiliza si tu ventana es corta. Según la página, Elasticsearch pasa a la 8.19.18 mediante actualizaciones progresivas, sin pasos manuales ni indisponibilidad. OpenSSL sube a la 3.5.9 en el instalador de Managed y en NGINX, que pasa a la 1.30.5. En seguridad, las notas mencionan Java 21.0.13+9 y 17.0.21+9, además de la retirada de confianza a certificados intermedios comprometidos de un emisor que la página nombra (referencia CVE-2026-114820). No he buscado el detalle de esa referencia: léelo en la fuente antes de deducir un nivel de riesgo.
En una actualización, estas líneas sirven para una cosa: marcar en tu ticket de cambio que el fabricante actualiza las dependencias. Para repasar el mecanismo general, relee el artículo sobre las actualizaciones del clúster Managed.
Correcciones que afectan a la operación del clúster
Tres correcciones tocan de lleno a quien administra un clúster y conviene conocerlas antes de topar con ellas en un incidente:
- añadir un nodo a un clúster Premium de alta disponibilidad fallaba por una mala elección del nodo de arranque (PRISM-15770);
- la consola de gestión del clúster avisaba por error de un problema de conectividad con un ActiveGate integrado cuando
dnsEntryPointapuntaba a un host que no figuraba en los URI de comunicación del nodo (PRISM-15764); - tras restaurar una copia de seguridad, funciones como la página de hosts o el filtrado de Data Explorer vuelven por sí solas poco después, cuando antes podían quedar sin servicio hasta cinco días.
Si tu última prueba de restauración dejó esas pantallas vacías, es un buen motivo para repetirla tras la actualización. Para el método de diagnóstico, consulta la guía de resolución de problemas de un clúster Managed.
Métricas: alertas de límites, desactivadas de fábrica
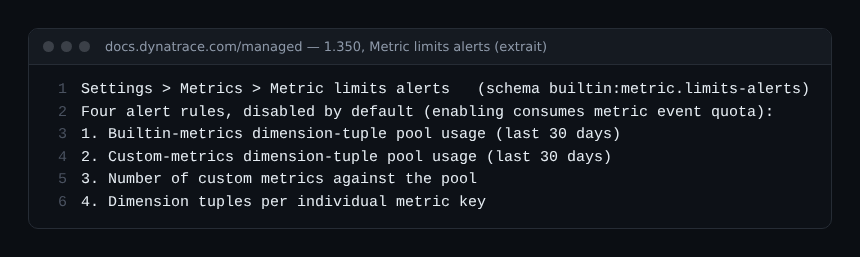
La novedad más útil para un clúster que crece es la alerta sobre los límites de métricas, en Ajustes, Métricas, «Metric limits alerts», y por la API de ajustes con el esquema builtin:metric.limits-alerts. Las configuraciones existentes se migran solas. Cuatro reglas vigilan:
- el uso de la reserva de combinaciones de dimensiones de las métricas integradas en 30 días;
- el mismo uso para las métricas personalizadas;
- el número de métricas personalizadas frente a la reserva;
- el número de combinaciones de dimensiones por clave de métrica.
Las cuatro reglas vienen desactivadas y activarlas consume cuota de eventos de métricas. Mi criterio operativo: activa primero la regla por clave de métrica, que señala al culpable, en vez de las tres de reserva, que solo avisan de que el techo se acerca. En la misma línea, se ha duplicado el número de dimensiones personalizadas que se conservan en la ventana móvil de 30 días, mejora la caché de las consultas de dimensiones y los motivos de rechazo en ingestas de alto caudal están más claros.
En el modo avanzado de Data Explorer aparece además un operador nuevo: asHistogram(<buckets>) muestra como histograma una métrica que no lo es, con un máximo de 12 intervalos; las visualizaciones existentes no cambian. Mira la guía de Data Explorer en Managed.
Topología, API y monitorización: tres cambios que probar
Los atributos de recurso entran en el modelo de topología: aparecen en la sección de propiedades de las pantallas de entidades y sirven en las reglas de entidades monitorizadas y de etiquetado automático, para hosts, procesos, grupos de procesos, contenedores y grupos de contenedores. También se pueden poner atributos personalizados en hosts monitorizados y clústeres de Kubernetes mediante el archivo dt_metadata.properties. Eso reduce la necesidad de etiquetas puestas a mano, pero no he comprobado cómo se comporta en una flota real.
En la API, la actualización automática de OneAgent en un host (PUT /hosts/{id}/autoupdate y el validador POST /hosts/{id}/autoupdate/validator) solo acepta ya versiones superiores a la instalada. Una versión igual o inferior devuelve 400 Bad Request con las dos versiones en el mensaje. Si algún script de gestión de flota «retrocede» agentes, ahora fallará: revisa los endpoints de la API de Managed.
Por último, la monitorización estática de Go funciona en Linux sin la capacidad ptrace y está llamada a sustituir a la opción de OneAgent «Go improved static monitoring». El grabador de Synthetic incorpora soporte de shadow DOM, con límites: 15 fronteras anidadas como máximo, solo se registra el host cuando el shadow root es cerrado y no se admiten iframes dentro de un shadow root.
Sistemas operativos: apunta las fechas antes del próximo cambio
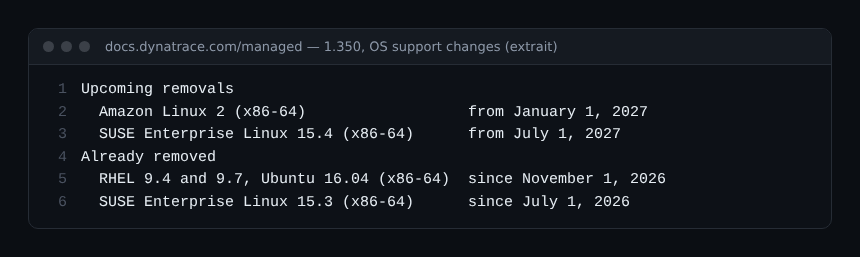
La página enumera retiradas de soporte. Ya vigentes: Red Hat Enterprise Linux 9.4 y 9.7 y Ubuntu 16.04 (x86-64), desde el 1 de noviembre de 2026. Próximas: Amazon Linux 2 (x86-64) el 1 de enero de 2027 y SUSE Enterprise Linux 15.4 (x86-64) el 1 de julio de 2027. Si algún nodo o host monitorizado usa una de esas distribuciones, abre el ticket ahora y no cuando llegue la fecha.
Lista de comprobación para la ventana de mantenimiento
- Inventariar todo lo que lee el campo
ordinalde los logs, antes de actualizar. - Comparar la distribución de cada nodo y de los hosts monitorizados con las fechas de retirada.
- Lanzar la actualización del clúster y revisar el estado de cada nodo en la consola.
- Repetir una prueba de restauración y comprobar la página de hosts.
- Decidir qué reglas de alerta de límites activar, empezando por la de clave de métrica.
- Revisar los scripts que llaman a la API de autoactualización de OneAgent.
Buenas prácticas
- Lee las notas con una pregunta de operación, no como un catálogo de novedades.
- En el ticket de cambio, separa lo automático de lo que necesita una decisión humana.
- Activa las alertas de límites una a una para medir su coste en cuota de eventos.
- Guarda el enlace a la página oficial en el ticket: las notas pueden corregirse después de publicarse.
Preguntas frecuentes
¿Exige la versión 1.350 alguna acción antes de actualizar?
Según la página que leí, la única acción necesaria es revisar el atributo ordinal de los logs. Las notas no tienen sección de instrucciones de actualización. Aun así, vuelve a mirar la página el día de tu intervención.
¿Están activas las alertas de límites de métricas tras actualizar?
No: las cuatro reglas vienen desactivadas y activarlas consume cuota de eventos de métricas. Las configuraciones existentes se migran automáticamente.
¿Valen estas notas para Dynatrace SaaS?
No, este artículo trata solo de Managed. Las versiones y componentes descritos son los de la página de Managed 1.350; no extrapoles nada a SaaS sin consultar sus propias notas.
Conclusión
Para quien opera el clúster, las notas de Managed 1.350 se reducen a revisar los logs, comprobar los sistemas operativos y decidir unos pocos ajustes opcionales. Los demás componentes se actualizan con el clúster. Haz esta lectura antes de la ventana de mantenimiento, no durante.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.