EDOT Kubernetes désigne le déploiement de la distribution OpenTelemetry d’Elastic (EDOT) sur un cluster, piloté par l’OpenTelemetry Operator. Selon la documentation Elastic, l’installation passe par le chart Helm opentelemetry-kube-stack et un fichier de valeurs publié dans le dépôt elastic/elastic-agent. Ce tutoriel suit cette procédure, puis explique ce que l’Operator déploie pour vous et ce qu’il laisse à votre charge.
Le problème, côté SRE ou plateforme : instrumenter vingt services à la main, un SDK à la fois, ne tient pas. L’objectif est ici d’obtenir, avec quelques commandes, des collecteurs sur chaque nœud et une auto-instrumentation activable par annotation. Ce contenu concerne Elastic ; il ne dépend ni de Dynatrace SaaS ni de Dynatrace Managed, mais la logique Operator est la même que dans notre guide sur l’OpenTelemetry Operator et l’auto-instrumentation.
En bref
- L’installation tient en quatre commandes : dépôt Helm, namespace, secret,
helm install. - Le fichier de valeurs d’Elastic déclare trois collecteurs : un daemon (DaemonSet), un cluster et un gateway.
- L’auto-instrumentation repose sur une ressource
Instrumentationnomméeelastic-instrumentationet sur une annotation de namespace. - L’Operator ne choisit pas vos ressources, vos quotas ni votre stratégie d’échantillonnage : ces réglages restent les vôtres.
Prérequis pour déployer EDOT Kubernetes
D’après la page de démarrage rapide d’Elastic pour Kubernetes auto-hébergé, il faut Helm 3.9 ou plus, jusqu’à la version 4.3.0 incluse. La page ne liste pas d’autre prérequis. Prévoyez aussi un accès kubectl au cluster, l’URL de votre endpoint Elasticsearch et une clé d’API Elastic. Ces deux valeurs vont dans un secret : ne les écrivez jamais dans un fichier versionné.
Versions citées par la documentation au moment de la lecture : chart opentelemetry-kube-stack 0.16.0, fichier de valeurs de l’étiquette v9.5.5 d’Elastic Agent. Vérifiez la page avant d’installer : ces numéros évoluent.
Installer l’OpenTelemetry Operator avec le chart Helm
Voici la séquence de la documentation Elastic, avec des valeurs d’exemple à remplacer.
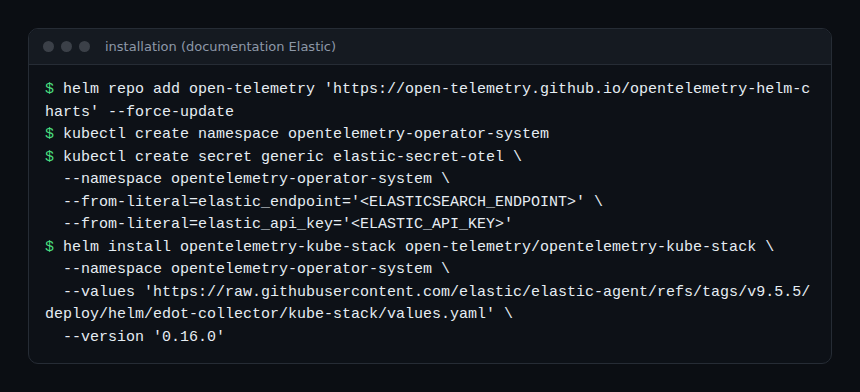
- Ajouter le dépôt Helm d’OpenTelemetry avec
helm repo add. - Créer le namespace
opentelemetry-operator-system. - Créer le secret
elastic-secret-otelavec les cléselastic_endpointetelastic_api_key. Le fichier de valeurs lit ces deux clés parsecretKeyRef. - Lancer
helm installavec--valuespointant vers le fichier d’Elastic et--version 0.16.0.
Sur OpenShift, la page indique d’ajouter un second fichier de valeurs après le premier. Je ne reprends pas ce cas ici : lisez la section « Deploy on OpenShift » de la documentation.
Étape finale côté Elastic : installer dans Kibana les intégrations « Kubernetes OpenTelemetry Assets » et « System OpenTelemetry Assets », puis ouvrir les tableaux de bord. C’est la seule vérification que décrit la page.
Ce que l’Operator déploie : daemon, cluster, gateway
Le fichier de valeurs (lu dans le dépôt GitHub d’Elastic) active les CRD de l’Operator, désactive le Target Allocator et définit trois collecteurs basés sur l’image docker.elastic.co/elastic-agent/elastic-agent. La documentation des modes de déploiement décrit un schéma à deux niveaux.
| Collecteur | Forme | Rôle selon la documentation Elastic |
|---|---|---|
| daemon | DaemonSet, un pod par nœud | Logs et métriques du nœud, réception OTLP des applications, enrichissement, envoi vers le gateway |
| cluster | Deployment | Événements et métriques au niveau du cluster, via l’API Kubernetes |
| gateway | Deployment, 2 réplicas dans le fichier | Reçoit tout en OTLP, traite et exporte vers Elasticsearch |
La page de configuration par défaut précise les récepteurs : filelog, hostmetrics, kubeletstats et OTLP pour le daemon, k8s_cluster et k8sobjects pour le collecteur de cluster. Dans le fichier de valeurs, le daemon active la collecte des logs et le hostNetwork, et s’exécute en root pour collecter les métriques. Relisez cette contrainte avec votre équipe sécurité.
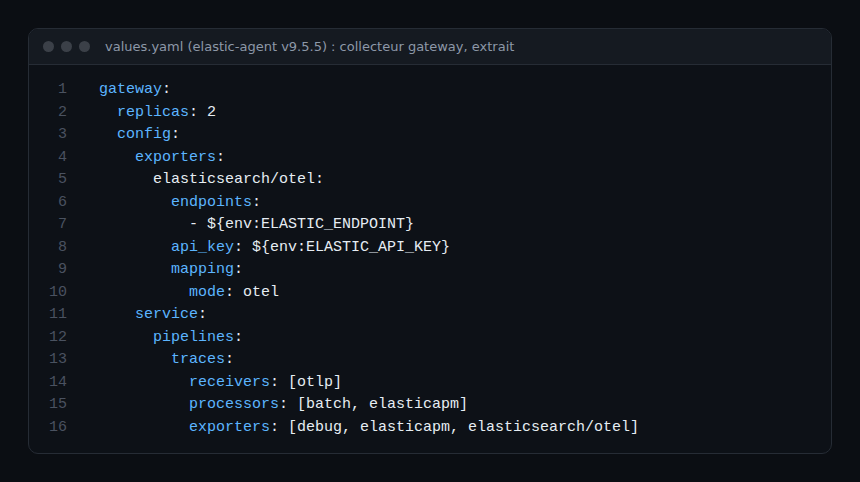
Côté sortie, le gateway utilise l’exporteur elasticsearch/otel en mode de mapping otel. Les traces passent aussi par le processeur et le connecteur elasticapm.
Pour comprendre chaque composant, notre article sur les composants du Collector contrib sert de référence. Si votre cible est Dynatrace plutôt qu’Elasticsearch, la structure agent puis gateway reste valable ; voyez notre guide du Collector sur Kubernetes.
Activer l’auto-instrumentation par annotation
Le fichier crée une ressource Instrumentation nommée elastic-instrumentation. Son exporteur pointe vers le service du collecteur daemon, sur le port 4318 (OTLP HTTP). Le propagateur par défaut inclut tracecontext, baggage et b3, et l’échantillonneur parentbased_traceidratio est réglé à 1.0, soit 100 % des traces.
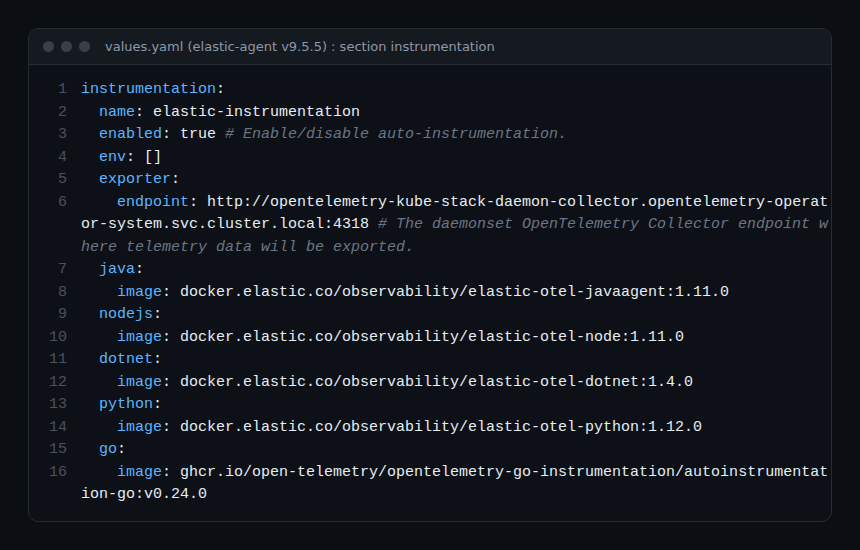
Les images référencées sont les agents EDOT pour Java, Node.js, .NET et Python, et l’agent d’auto-instrumentation OpenTelemetry pour Go. Pour activer un namespace, la documentation Elastic donne cette commande, où <LANGUAGE> vaut nodejs, java, python, dotnet ou go :
kubectl annotate namespace MON_NAMESPACE \
  instrumentation.opentelemetry.io/inject-<LANGUAGE>="opentelemetry-operator-system/elastic-instrumentation"
Il faut ensuite redémarrer le déploiement. La page Elastic ne donne pas la commande ; la documentation OpenTelemetry explique pourquoi : l’injection est évaluée au démarrage du pod, donc les pods existants doivent être recréés. Un kubectl rollout restart deployment/mon-app suffit. La ressource Instrumentation doit exister avant le pod, sinon l’init container opentelemetry-auto-instrumentation n’est pas créé.
Cas particulier de Go
D’après la documentation OpenTelemetry, Go passe par un sidecar eBPF, derrière le feature gate enable-go-instrumentation, qui s’exécute en mode privilégié. Le fichier d’Elastic active ce drapeau dans les arguments du manager. Pesez ce choix avant de l’activer en production.
Comment vérifier que ça fonctionne
kubectl get pods -n opentelemetry-operator-system: l’Operator, le daemon, le collecteur de cluster et le gateway doivent tourner. Ce sont des commandes Kubernetes standard, pas une étape de la page Elastic.- Après le redémarrage d’une application annotée,
kubectl describe poddoit montrer l’init container d’auto-instrumentation. En cas d’absence, vérifiez l’annotation, le langage et l’existence de la ressource. - Dans Kibana, les tableaux de bord des intégrations doivent se remplir.
Côté fiabilité, une vérification rapide protège votre MTTR : si les traces manquent pendant un incident, vous le découvrez trop tard. Pour la méthode générale, voyez observabilité et monitoring.
Bonnes pratiques
- Ne gardez pas 100 % d’échantillonnage par réflexe en production : le fichier fixe 1.0, c’est un point de départ. Notre guide du tail sampling aide à décider.
- Versionnez vos valeurs et épinglez la version du chart et de l’étiquette du fichier.
- Dimensionnez le gateway : le fichier prévoit 2 réplicas, une limite CPU de 1500m et 1500Mi de mémoire. Ce sont des valeurs d’exemple d’Elastic, pas des recommandations pour votre charge.
- Activez cert-manager en production : le fichier le recommande en commentaire, au lieu du certificat autogénéré.
- Annotez par namespace, progressivement, en commençant par un service peu critique.
Questions fréquentes
Qu’est-ce que EDOT Kubernetes ?
C’est l’ensemble formé par le Collector EDOT d’Elastic, déployé en daemon, cluster et gateway, et les agents EDOT d’auto-instrumentation, le tout installé par l’OpenTelemetry Operator. Les données partent en OTLP vers Elasticsearch.
L’Operator gère-t-il l’instrumentation de toutes mes applications ?
Non. Il injecte l’instrumentation seulement dans les pods annotés, pour les langages pris en charge : Java, Node.js, .NET, Python et Go. Pour les autres langages, la documentation Elastic renvoie vers la configuration manuelle des SDK EDOT.
Puis-je envoyer ces données ailleurs que vers Elastic ?
Le fichier d’Elastic configure l’exporteur Elasticsearch. Changer de destination suppose de modifier la configuration du gateway ; cette variante n’est pas documentée par Elastic dans les pages lues, donc elle n’est pas vérifiée ici. Voyez nos articles sur le choix entre APM Server et EDOT Collector.
Conclusion
L’Operator réduit le déploiement d’EDOT Kubernetes à un helm install et à une annotation, mais il ne remplace pas vos décisions : échantillonnage, ressources, sécurité, destination des données. Testez sur un namespace pilote, vérifiez les init containers et les tableaux de bord, puis élargissez.
Sources
- Démarrage rapide Kubernetes auto-hébergé, documentation Elastic
- Modes de déploiement de l’EDOT Collector, documentation Elastic
- Configuration Kubernetes par défaut, documentation Elastic
- Injection automatique d’auto-instrumentation, documentation OpenTelemetry
- values.yaml du chart kube-stack, dépôt elastic/elastic-agent
span.observer est un blog indépendant, non affilié à Dynatrace LLC ni à Elastic N.V. Elastic, Elasticsearch et Kibana sont des marques de leurs propriétaires ; les extraits proviennent de la documentation et du dépôt officiels, les valeurs entre chevrons sont des exemples.