Un cluster Elasticsearch passe au jaune, les rejets d’indexation montent, et personne ne sait si le problème vient des shards, de la mémoire ou d’un index trop gros. Ce tutoriel montre comment faire de l’Elasticsearch OpenTelemetry monitoring avec le collecteur : le receiver elasticsearch interroge l’API du cluster et produit des métriques OTLP, que vous envoyez ensuite vers Dynatrace ou un autre backend.
Objectif : en six étapes, scraper la santé du cluster, les nœuds et quelques index, en gardant la cardinalité sous contrôle. Chaque métrique sert un SLI concret : disponibilité du cluster, rejets d’écriture, temps de recherche.
Périmètre : le receiver est marqué beta (métriques uniquement) et fait partie de la distribution contrib du Collector. Le contenu vaut pour Dynatrace SaaS ; pour Managed, adaptez l’endpoint (voir le guide du Collector vers Dynatrace).
Prérequis de l’Elasticsearch OpenTelemetry monitoring
- Elasticsearch 7.9 ou plus récent (version minimale indiquée par le README du receiver). Certaines métriques exigent mieux :
elasticsearch.indexing_pressure.memory.limitdemande la 7.10,elasticsearch.cluster.state_update.countla 7.16.0. - Un Collector contrib (le receiver n’est pas dans la distribution « core »). Voir les composants du Collector contrib.
- Si la sécurité Elasticsearch est active : un utilisateur dédié avec le privilège de cluster
monitor(oumanage). - Un endpoint OTLP de destination et un token d’ingestion de métriques.
Étape 1 : créer un utilisateur en lecture seule
Selon la documentation Elasticsearch, monitor donne accès à toutes les opérations de cluster en lecture seule ; manage y ajoute des opérations qui modifient le cluster. Pour un collecteur, monitor suffit, d’après le README du receiver. Créez un rôle avec ce seul privilège :
PUT /_security/role/otel_monitor
{
  "cluster": ["monitor"]
}
Associez ensuite ce rôle à un utilisateur otel (par Kibana ou par l’API « Create or update users » ; la forme exacte de cette requête n’est pas détaillée ici). L’appel de création de rôle exige lui-même le privilège manage_security.
Étape 2 : déclarer le receiver
Tous les paramètres sont optionnels. Voici une configuration prudente, inspirée de l’exemple du README :
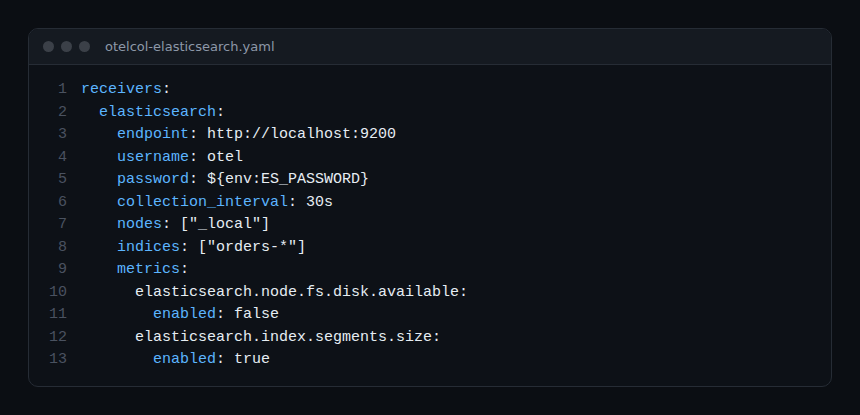
Les lignes qui comptent :
endpoint: l’URL de l’API,http://localhost:9200par défaut.usernameetpassword: authentification de base uniquement ; les deux champs vont ensemble. Le mot de passe vient d’une variable d’environnement, jamais du fichier.collection_interval:10spar défaut ; le README précise que les gros clusters peuvent exiger plus long. Ici, 30 s.nodes: ["_local"]: valeur recommandée par le README quand vous lancez un receiver par nœud. Par défaut,["_all"].indices: filtre des index scrapés,["_all"]par défaut.metrics: active ou désactive chaque métrique par nom.
Étape 3 : maîtriser la cardinalité avec le filtrage des index
Les métriques d’index portent l’index en dimension. Avec des centaines d’index quotidiens, le volume de séries explose. Trois leviers existent, tous issus du README :
indicesavec des motifs (orders-*) pour ne suivre que les index utiles ; une liste vide désactive les métriques d’index.index_stats_master_only: true:/_statsn’est interrogé que sur le maître élu, ce qui évite les doublons si vous avez un receiver par nœud.cluster_stats_master_only: true: même logique pour/_cluster/stats. Pendant une élection de maître, aucune stats n’est collectée tant qu’un nouveau maître n’est pas élu.
Si vous exécutez un receiver par nœud, combinez nodes: ["_local"] avec ces deux options « master only ». Si un seul Collector interroge tout le cluster, gardez _all.
Bonnes pratiques
- Un utilisateur par collecteur, privilège
monitorseulement. - Filtrez les index par motif dès le départ : réduire après coup est plus pénible.
- Désactivez les métriques dont personne ne se sert, activez les optionnelles au besoin.
- Allongez
collection_intervalavant d’ajouter de la puissance au cluster.
Étape 4 : choisir les métriques utiles
La documentation du receiver (documentation.md) liste les métriques et leur unité. Quelques-unes suffisent pour un premier tableau de bord :
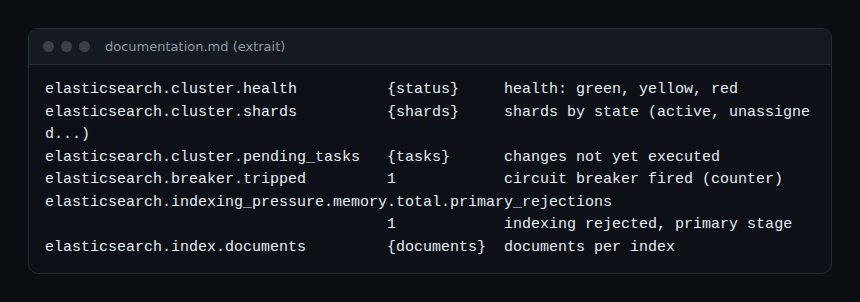
elasticsearch.cluster.health porte un attribut status (green, yellow, red) : c’est la base d’un SLI de disponibilité. elasticsearch.cluster.shards distingue les shards actifs, en relocation, en initialisation ou non assignés. Plusieurs métriques sont optionnelles et désactivées par défaut, comme elasticsearch.process.cpu.usage ou jvm.memory.heap.utilization : activez-les avec enabled: true.
Étape 5 : envoyer les métriques vers Dynatrace
Ajoutez l’exporteur OTLP HTTP et un pipeline de métriques. D’après la documentation Dynatrace, l’exporteur lit l’endpoint et un platform token en variables d’environnement, avec un en-tête Authorization: Bearer ; les scopes cités pour l’ingestion OTLP sont openpipeline:metrics:ingest pour les métriques.
exporters:
  otlphttp:
    endpoint: ${env:DT_ENDPOINT}
    headers:
      Authorization: "Bearer ${env:DT_PLATFORM_TOKEN}"

service:
  pipelines:
    metrics:
      receivers: [elasticsearch]
      processors: [batch]
      exporters: [otlphttp]
Attention : ces métriques sont de type Sum cumulative (documentation du receiver). Notre guide du Collector recommande le processeur cumulativetodelta pour Dynatrace ; vérifiez ce point dans la documentation de votre version (non revérifié ici). Pour la supervision du Collector lui-même, voir superviser le Collector OpenTelemetry.
Étape 6 : comment vérifier que ça fonctionne
- Démarrez le Collector avec l’exporteur
debugajouté au pipeline : les métriqueselasticsearch.*doivent apparaître dans les logs. - Une erreur 401 ou 403 signale un utilisateur ou un privilège faux ; vérifiez
monitor. - Aucune métrique d’index : votre motif
indicesne correspond à rien, ou la liste est vide. - Côté Dynatrace, cherchez le préfixe
elasticsearch.dans le Metrics browser ou avec une requête DQL timeseries.
Ce que ça change pour une équipe SRE
Le receiver reste en beta : noms et attributs peuvent évoluer entre versions. Le README signale aussi qu’Elasticsearch devrait un jour être instrumenté directement avec le SDK Java OpenTelemetry. Épinglez la version du Collector, testez les mises à jour et alertez sur l’absence de données plutôt que sur un seuil seul. Pour comparer cette approche à une solution intégrée, voir le comparatif Dynatrace et Datadog.
Questions fréquentes
Quelles versions d’Elasticsearch le receiver prend-il en charge ?
Le README indique 7.9 et plus. Certaines métriques demandent une version plus récente, par exemple la 7.10 ou la 7.16.0.
Quel privilège faut-il donner à l’utilisateur ?
Le privilège de cluster monitor ou manage. monitor suffit pour de la lecture et respecte le moindre privilège.
Le receiver est-il stable ?
Non : il est marqué beta pour les métriques. Testez chaque montée de version du Collector avant de la déployer.
Conclusion : un receiver, un utilisateur monitor, des filtres d’index et un exporteur suffisent pour suivre santé, shards et pression d’indexation. Gardez l’œil sur la cardinalité et sur le statut beta.
Sources officielles : README du receiver elasticsearch, API OTLP de Dynatrace.
Cet article provient d’un blog indépendant, non affilié à Dynatrace LLC ni à Elastic N.V.