Un clúster de Elasticsearch pasa a amarillo, los rechazos de indexación suben y nadie sabe si el problema viene de los shards, de la memoria o de un índice demasiado grande. Este tutorial muestra cómo hacer monitorización de Elasticsearch con OpenTelemetry usando el Collector: el receiver elasticsearch consulta la API del clúster y produce métricas OTLP, que luego envías a Dynatrace o a otro backend.
Objetivo: en seis pasos, recoger la salud del clúster, los nodos y algunos índices, manteniendo la cardinalidad bajo control. Cada métrica sirve para un SLI concreto: disponibilidad del clúster, rechazos de escritura, tiempo de búsqueda.
Alcance: el receiver está marcado como beta (solo métricas) y forma parte de la distribución contrib del Collector. El contenido vale para Dynatrace SaaS; para Managed, adapta el endpoint (consulta la guía del Collector hacia Dynatrace).
Requisitos de la monitorización de Elasticsearch con OpenTelemetry
- Elasticsearch 7.9 o posterior (versión mínima indicada por el README del receiver). Algunas métricas exigen más:
elasticsearch.indexing_pressure.memory.limitrequiere la 7.10 yelasticsearch.cluster.state_update.countla 7.16.0. - Un Collector contrib (el receiver no está en la distribución «core»). Consulta los componentes del Collector contrib.
- Si la seguridad de Elasticsearch está activa: un usuario dedicado con el privilegio de clúster
monitor(omanage). - Un endpoint OTLP de destino y un token de ingesta de métricas.
Paso 1: crear un usuario de solo lectura
Según la documentación de Elasticsearch, monitor da acceso a todas las operaciones de clúster de solo lectura; manage añade operaciones que modifican el clúster. Para un collector, monitor basta, según el README del receiver. Crea un rol con ese único privilegio:
PUT /_security/role/otel_monitor
{
  "cluster": ["monitor"]
}
Después asocia ese rol a un usuario otel (con Kibana o con la API «Create or update users»; la forma exacta de esa petición no se detalla aquí). La propia llamada de creación del rol exige el privilegio manage_security.
Paso 2: declarar el receiver
Todos los parámetros son opcionales. Esta es una configuración prudente, inspirada en el ejemplo del README:
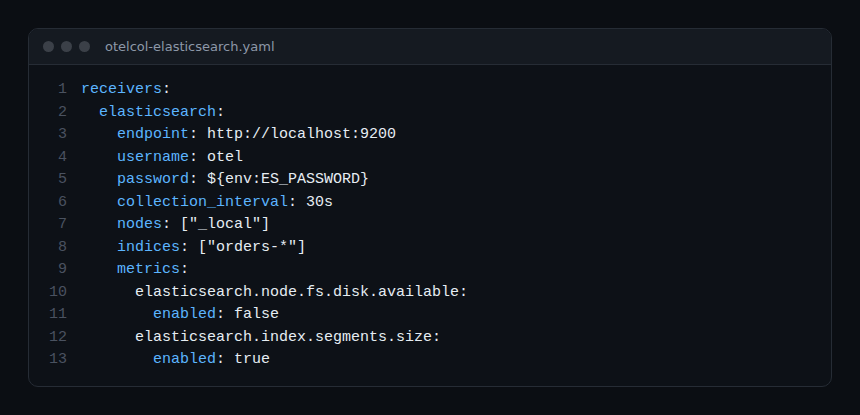
Las líneas que importan:
endpoint: la URL de la API,http://localhost:9200por defecto.usernameypassword: solo autenticación básica; los dos campos van juntos. La contraseña viene de una variable de entorno, nunca del archivo.collection_interval:10spor defecto; el README precisa que los clústeres grandes pueden necesitar un intervalo más largo. Aquí, 30 s.nodes: ["_local"]: valor recomendado por el README cuando lanzas un receiver por nodo. Por defecto,["_all"].indices: filtro de los índices recogidos,["_all"]por defecto.metrics: activa o desactiva cada métrica por nombre.
Paso 3: controlar la cardinalidad con el filtrado de índices
Las métricas de índice llevan el índice como dimensión. Con cientos de índices diarios, el volumen de series se dispara. Hay tres palancas, todas del README:
indicescon patrones (orders-*) para seguir solo los índices útiles; una lista vacía desactiva las métricas de índice.index_stats_master_only: true:/_statssolo se consulta en el maestro elegido, lo que evita duplicados si tienes un receiver por nodo.cluster_stats_master_only: true: la misma lógica para/_cluster/stats. Durante una elección de maestro, no se recoge ninguna estadística hasta que se elige un nuevo maestro.
Si ejecutas un receiver por nodo, combina nodes: ["_local"] con estas dos opciones «master only». Si un único Collector consulta todo el clúster, mantén _all.
Buenas prácticas
- Un usuario por collector, solo con el privilegio
monitor. - Filtra los índices por patrón desde el principio: reducir después es más molesto.
- Desactiva las métricas que nadie usa y activa las opcionales cuando haga falta.
- Alarga
collection_intervalantes de añadir potencia al clúster.
Paso 4: elegir las métricas útiles
La documentación del receiver (documentation.md) lista las métricas y su unidad. Unas pocas bastan para un primer dashboard:
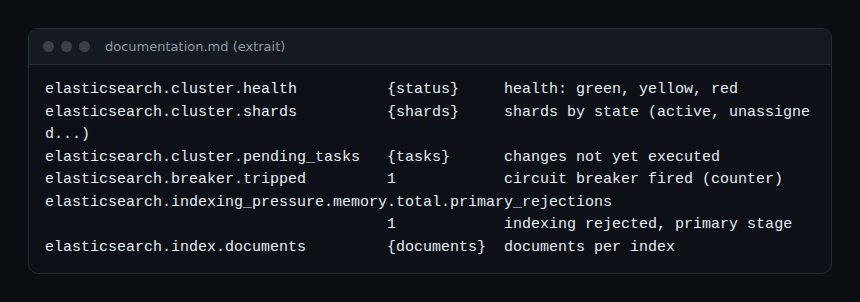
elasticsearch.cluster.health lleva un atributo status (green, yellow, red): es la base de un SLI de disponibilidad. elasticsearch.cluster.shards distingue los shards activos, en reubicación, en inicialización o sin asignar. Varias métricas son opcionales y están desactivadas por defecto, como elasticsearch.process.cpu.usage o jvm.memory.heap.utilization: actívalas con enabled: true.
Paso 5: enviar las métricas a Dynatrace
Añade el exportador OTLP HTTP y un pipeline de métricas. Según la documentación de Dynatrace, el exportador lee el endpoint y un platform token de variables de entorno, con una cabecera Authorization: Bearer; los scopes citados para la ingesta OTLP son openpipeline:metrics:ingest para las métricas.
exporters:
  otlphttp:
    endpoint: ${env:DT_ENDPOINT}
    headers:
      Authorization: "Bearer ${env:DT_PLATFORM_TOKEN}"

service:
  pipelines:
    metrics:
      receivers: [elasticsearch]
      processors: [batch]
      exporters: [otlphttp]
Atención: estas métricas son de tipo Sum cumulative (documentación del receiver). Nuestra guía del Collector recomienda el procesador cumulativetodelta para Dynatrace; comprueba este punto en la documentación de tu versión (no revisado de nuevo aquí). Para la supervisión del propio Collector, consulta supervisar el Collector de OpenTelemetry.
Paso 6: cómo comprobar que funciona
- Arranca el Collector con el exportador
debugañadido al pipeline: las métricaselasticsearch.*deben aparecer en los logs. - Un error 401 o 403 indica un usuario o un privilegio incorrecto; revisa
monitor. - Ninguna métrica de índice: tu patrón
indicesno coincide con nada, o la lista está vacía. - En Dynatrace, busca el prefijo
elasticsearch.en el Metrics browser o con una consulta DQL timeseries.
Qué cambia para un equipo SRE
El receiver sigue en beta: los nombres y atributos pueden cambiar entre versiones. El README señala también que Elasticsearch debería instrumentarse algún día directamente con el SDK de Java de OpenTelemetry. Fija la versión del Collector, prueba las actualizaciones y alerta por ausencia de datos en lugar de por un umbral solo. Para comparar este enfoque con una solución integrada, consulta la comparativa entre Dynatrace y Datadog.
Preguntas frecuentes
¿Qué versiones de Elasticsearch admite el receiver?
El README indica la 7.9 y posteriores. Algunas métricas requieren una versión más reciente, por ejemplo la 7.10 o la 7.16.0.
¿Qué privilegio hay que dar al usuario?
El privilegio de clúster monitor o manage. monitor basta para lectura y respeta el mínimo privilegio.
¿Es estable el receiver?
No: está marcado como beta para las métricas. Prueba cada subida de versión del Collector antes de desplegarla.
Conclusión: un receiver, un usuario monitor, filtros de índice y un exportador bastan para seguir la salud, los shards y la presión de indexación. Vigila la cardinalidad y el estado beta.
Fuentes oficiales: README del receiver elasticsearch, API OTLP de Dynatrace.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Elastic N.V. Dynatrace es una marca de Dynatrace LLC. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.