
Suena la alerta de latencia p99, la gráfica de Grafana marca un pico a las 14:07 y a quien está de guardia le ronda siempre la misma duda: ¿qué petición fue la lenta? Los exemplars de Prometheus sirven justo para eso. Cuelgan de un punto de la métrica el identificador de una traza real, y de la gráfica saltas a la traza de OpenTelemetry con un clic.
Los datos salen de la documentación de Prometheus, de la especificación de OpenMetrics y de la documentación de Grafana, consultadas el 12 de noviembre de 2026. No he montado una pila completa para este artículo: las capturas muestran ficheros de ejemplo construidos a partir de esas páginas, y lo que no he comprobado queda señalado.
Si los spans son nuevos para ti, empieza por la anatomía de un span de OpenTelemetry. Ambas señales se complementan: la métrica dice «cuándo y cuánto», la traza dice «cuál».
El problema: un promedio no señala ninguna petición
Una métrica de latencia resume miles de peticiones en unos pocos contadores. Por eso resulta barata. Pero cuando el p99 se dispara necesitas dar con una petición concreta, y la métrica ya la ha olvidado.
Sin un enlace directo toca hacer arqueología: anotas la hora del pico, abres la herramienta de trazas, filtras por servicio y duración y confías en que el muestreo no haya descartado la traza buena. Cada minuto que pasas ahí suma a tu MTTR.
La decisión operativa es sencilla: ¿aceptas guardar, junto a tus series, un puñado de referencias a trazas? Eso es un exemplar, y tiene un coste de memoria preciso que calculamos más abajo.
Exemplars de Prometheus: lo que permite la especificación
Un exemplar es una referencia a datos externos a la métrica, normalmente el identificador de una traza. La página de feature flags de Prometheus lo vincula a OpenMetrics: este formato permite que un destino rastreado adjunte exemplars a ciertas métricas.
La especificación de OpenMetrics acota el alcance. Admite un exemplar en los valores de bucket de un histograma y en el total de un contador. No dice nada de los gauges ni de los summaries. En la línea de texto, el exemplar va tras la cifra, después de una almohadilla, con sus propias etiquetas y su valor observado.
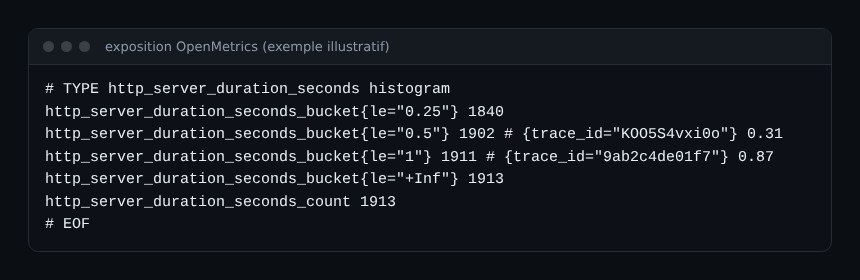
Una restricción que conviene conocer: según la especificación, la longitud total de nombres y valores de etiquetas de un exemplar no puede pasar de 128 puntos de código UTF-8. Un identificador de traza cabe de sobra. Lo que no debes hacer es añadir más etiquetas «por dar contexto».
Activar exemplar-storage sin sorpresas de memoria
Por defecto, Prometheus no conserva los exemplars que rastrea. Hay que arrancar el servidor con --enable-feature=exemplar-storage. Según la documentación, los exemplars van entonces a un búfer circular en memoria, de tamaño fijo y compartido por todas las series.
- Arranca Prometheus con el feature flag
exemplar-storage. - Ajusta el tamaño del búfer en el bloque
storagey luegoexemplarsde la configuración:max_exemplarsvale 100 000 por defecto, según la página de configuración, y puede cambiarse en caliente. - Comprueba que tus destinos exponen exemplars en su formato de scrape.
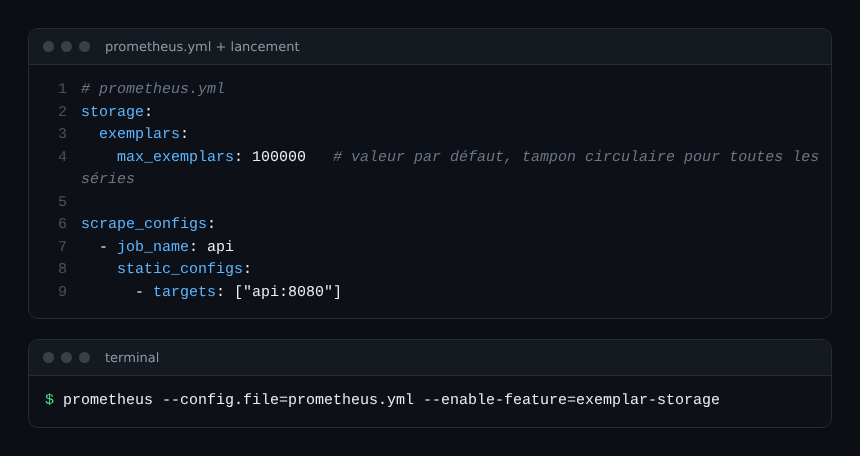
La documentación da un orden de magnitud: un exemplar que solo contiene trace_id pesa unos 100 bytes. Con 100 000 entradas salen unos 10 MB; es un cálculo mío a partir de esa cifra, no una medición. Como el búfer es circular, los exemplars más antiguos desaparecen primero. En una flota ruidosa no es descartable una ventana de solo unos minutos: compruébalo en tu entorno.
Otro punto: según la misma página, los exemplars también se escriben en el WAL, para la persistencia local y mientras dure el WAL. No he leído cómo se comportan con remote write; si envías a un almacenamiento remoto, lee la sección correspondiente, como la de Grafana Mimir para almacenar métricas de Prometheus.
Consultar los exemplars con la API
Antes de configurar Grafana, comprueba que Prometheus los ha recibido. La API HTTP ofrece el endpoint /api/v1/query_exemplars, por GET o POST, marcado como experimental en la documentación. Recibe una consulta PromQL y una ventana start / end.
La respuesta lista, por cada serie, sus seriesLabels y un array exemplars. Cada exemplar trae sus labels (por ejemplo trace_id), un value y un timestamp en segundos Unix. Si el array llega vacío, no sigas: el problema está antes, en la exposición o en el feature flag.
De la gráfica a la traza de OTel en Grafana
En Grafana un exemplar se dibuja como una estrella sobre la gráfica. Al pasar el ratón ves el identificador de la traza, y un botón la abre en la fuente de datos de trazas, Tempo en el ejemplo de la documentación. El soporte de exemplars solo se anuncia para la fuente de datos de Prometheus.
El enlace se declara en la fuente de Prometheus. El campo Label name indica la clave de la etiqueta que lleva el identificador, y un enlace interno apunta a la fuente de trazas. Con provisioning queda así.
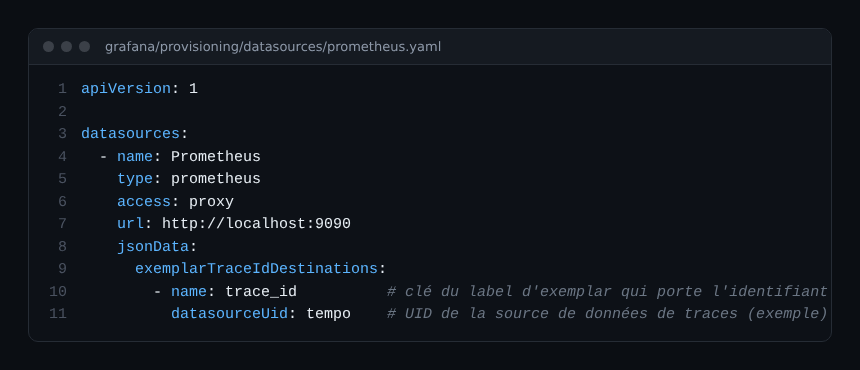
Si aún no tienes un backend de trazas, nuestro artículo sobre Grafana Tempo con kube-prometheus-stack describe una instalación. Lo delicado está en otro sitio: el identificador debe ser el mismo en ambos lados. Lo es cuando la aplicación lee el trace_id del span de OpenTelemetry activo en el momento de registrar la duración.
La trampa del muestreo
Este es el caso que más gente pilla. Tu exemplar apunta a una traza que el tail sampling descartó: el clic lleva a una página de «no encontrado». La aplicación registra el exemplar, pero la decisión de conservar la traza se toma más adelante en el pipeline.
Hay dos remedios, según tu presupuesto. Conserva siempre las trazas lentas y con error, como muestran las reglas de tail sampling del Collector. O registra un exemplar solo cuando la traza esté marcada como muestreada: no he comprobado que tu biblioteca cliente lo permita, mira su documentación.
Buenas prácticas
- Empieza por la latencia de un servicio crítico, sobre un histograma, no por toda la flota.
- Deja
trace_idcomo única etiqueta del exemplar: el límite es de 128 caracteres. - Verifica con
query_exemplarsantes de culpar a Grafana. - Conserva las trazas lentas en el tail sampling; si no, la estrella no lleva a ninguna parte.
- Anota en el runbook: «pico de p99, pasar el ratón por las estrellas, abrir la traza más lenta».
Preguntas frecuentes
¿Funcionan los exemplars con cualquier métrica?
No. La especificación de OpenMetrics los prevé para los buckets de histograma y el total de un contador. No los describe para los gauges.
¿Cuánta memoria consumen los exemplars?
La documentación indica unos 100 bytes para un exemplar reducido a un trace_id, dentro de un búfer de tamaño fijo regulado por max_exemplars (100 000 por defecto). Mide en tu entorno antes de cambiar ese valor.
¿Y si uso Dynatrace?
Este artículo solo trata de Prometheus, Grafana y OpenMetrics. Para el vínculo entre métricas y trazas en Dynatrace, consulta docs.dynatrace.com distinguiendo SaaS de Managed: aquí no mezclo ninguna función. Para comparar enfoques, mira OpenTelemetry y Prometheus.
Conclusión
Los exemplars de Prometheus convierten un pico de latencia en una lista de trazas candidatas por unos pocos megabytes de memoria. Activa el feature flag, verifica con la API, declara el enlace en Grafana y protege tus trazas lentas del muestreo. Fuentes: feature flags de Prometheus, especificación de OpenMetrics, exemplars en Grafana.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Grafana Labs ni a los Prometheus Authors. Las marcas citadas pertenecen a sus propietarios. Las herramientas cambian rápido: comprueba siempre los comandos y las opciones en la documentación oficial correspondiente a tu versión.