En DQL, fonction in() et opérateur in répondent à la même question : cette valeur fait-elle partie d’une liste ? La fonction teste une liste écrite dans la requête ou un tableau porté par l’enregistrement ; l’opérateur compare une valeur au résultat d’une sous-requête. Bien les choisir évite les chaînes de or illisibles et les listes d’identifiants copiées à la main pendant un incident.
Ce guide détaille la syntaxe documentée, les tableaux, la négation, les sous-requêtes et le cas particulier de classicEntitySelector, avec des cas d’usage d’exploitation. Toutes les syntaxes citées viennent de la documentation DQL officielle, consultée en octobre 2026.
Le contenu vaut pour Dynatrace SaaS (Grail). Dynatrace Managed n’a pas DQL : on y filtre avec le sélecteur d’entités et le metric selector. Pour le panorama des commandes, voir les commandes DQL commentées, qui présentent in() en quelques exemples ; ce guide va plus loin.
DQL fonction in() : syntaxe et valeur renvoyée
La signature documentée est :
in(needle, haystack, …)needle: l’élément cherché (ou les éléments, si c’est un tableau) ;haystack: les valeurs dans lesquelles chercher. La fonction accepte plusieurs haystacks et des tableaux dans tous les arguments ;- le résultat est un booléen, donc utilisable directement dans
filter,filterOut,fieldsAddoucountIf.
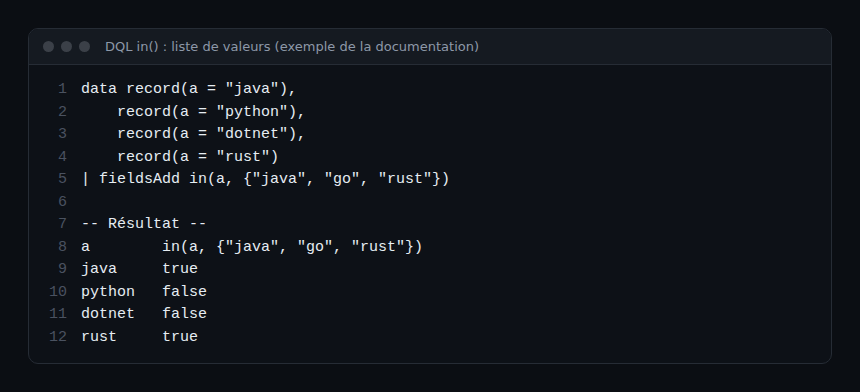
Les types acceptés couvrent les chaînes, nombres, durées, adresses IP, horodatages, booléens et enregistrements : on peut tester une liste d’adresses IP comme une liste de noms de service.
Étape par étape : filtrer sur une liste
Étape 1 — Remplacer une chaîne de or
// avant
fetch logs
| filter loglevel == "ERROR" or loglevel == "WARN"

// après
fetch logs
| filter in(loglevel, {"ERROR", "WARN"})
La liste entre accolades est la forme utilisée par la documentation. Une suite de valeurs fonctionne aussi : in(technologies, "Python", "Hibernate") figure dans les exemples officiels.
Étape 2 — Exclure une liste
La négation s’écrit avec not devant la fonction, ou avec la commande filterOut :
fetch logs
| filterOut in(k8s.namespace.name, {"kube-system", "monitoring"})
| summarize nb = count(), by:{k8s.namespace.name}
Utile pour retirer le bruit des namespaces techniques avant de chercher l’origine d’une hausse de volume.
Étape 3 — Tester un champ tableau
Quand le needle est un tableau, in() renvoie true si au moins un de ses éléments figure dans le haystack. L’exemple officiel :
data record(technologies = array("Java", "Spring", "Jetty")),
     record(technologies = array("Python", "Flask")),
     record(technologies = array("Java", "Hibernate"))
| fieldsAdd in(technologies, "Python", "Hibernate"),
            in(technologies, array("Spring", "Flask"))
Le premier enregistrement donne false puis true : aucun de ses éléments n’est Python ou Hibernate, mais Spring figure dans le second haystack.
Pour vérifier qu’un tableau est entièrement contenu dans un autre, la documentation des opérateurs propose une double négation avec iAny :
| fieldsAdd not iAny(not in(needle[], haystack))not in(needle[], haystack) vaut true pour chaque élément absent ; iAny détecte s’il en existe un ; le not extérieur renvoie donc true seulement si aucun élément ne manque. La documentation précise qu’un tableau dont tous les éléments sont null donne null, et ne passe donc jamais un filtre.
Sous-requêtes : l’opérateur in
Quand la liste n’est pas connue à l’avance, utilisez l’opérateur in avec une sous-requête entre crochets. Syntaxe documentée :
expression in [execution block]Contrainte : la sous-requête doit renvoyer un seul champ, qui fournit la liste de valeurs.
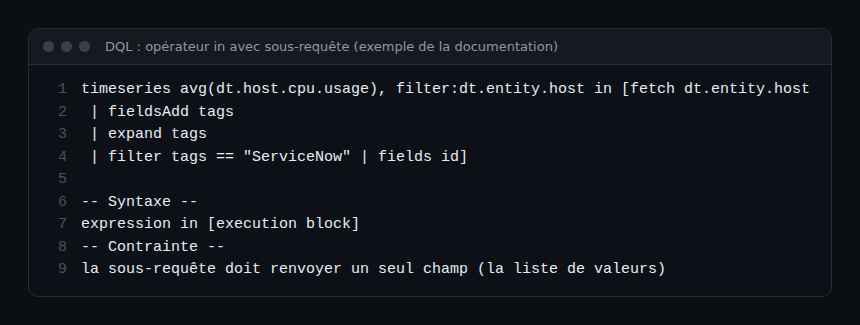
L’exemple officiel filtre la métrique CPU des hôtes qui portent un tag donné. Le même principe s’applique aux logs :
fetch logs
| filter loglevel == "ERROR"
| filter dt.entity.host in [fetch dt.entity.host
    | fieldsAdd tags
    | expand tags
    | filter tags == "ServiceNow"
    | fields id]
| summarize erreurs = count(), by:{dt.entity.host}
La sous-requête renvoie le champ id des entités hôte ; le fields id final garantit qu’il n’y a qu’un champ. Le résultat se regroupe ensuite avec summarize : voir DQL group by.
Le cas classicEntitySelector
La fonction classicEntitySelector() renvoie les identifiants d’entités correspondant à un sélecteur d’entités classique. La documentation précise qu’elle n’est prise en charge que sous la forme in(field, classicEntitySelector("..")) et qu’elle exige la permission storage:entities:read. Elle permet de réutiliser un sélecteur existant, avec ses relations :
fetch logs
| filter in(dt.entity.cloud_application_instance,
    classicEntitySelector("type(CLOUD_APPLICATION_INSTANCE),toRelationShip.IS_NAMESPACE_OF_CAI(type(CLOUD_APPLICATION_NAMESPACE), entityId(CLOUD_APPLICATION_NAMESPACE-1B6CFC8C542A2273))"))
Smartscape on Grail ne prend pas en charge classicEntitySelector : la documentation y remplace la sélection par relations par la commande traverse, qui parcourt la topologie directement en DQL : voir DQL Smartscape.
Cas d’usage en exploitation
- Périmètre d’un incident : limiter les logs aux services touchés, listés une fois dans la requête.
- Liste d’exclusion : retirer les sondes de supervision ou les adresses IP internes avec
filterOut in(...). - Filtre dynamique : une sous-requête qui sélectionne les hôtes par tag, au lieu d’une liste d’identifiants qui vieillit mal.
- Compteur conditionnel :
countIf(in(loglevel, {"ERROR", "WARN"}))dans unsummarizepour un indicateur d’erreurs.
Chaque liste écrite en dur est une source de toil : elle doit être mise à jour à chaque nouveau service. Une sous-requête basée sur un tag suit l’environnement sans intervention, ce qui réduit le risque d’un filtre faux au moment où le MTTR compte.
Comment vérifier que le filtre est juste
- Affichez le booléen avant de filtrer :
| fieldsAdd match = in(champ, {...}), puis| summarize count(), by:{match}. Vous voyez combien d’enregistrements passent. - Exécutez la sous-requête seule : elle doit renvoyer une seule colonne et les valeurs attendues.
- Listez les valeurs réelles du champ avec
| summarize count(), by:{champ}: une valeur mal orthographiée dans la liste ne correspond à rien et ne déclenche aucune erreur.
Bonnes pratiques
- Préférez
in()à plus de deuxorsur le même champ : la requête se relit et se modifie en une ligne. - Terminez toute sous-requête par
fieldssur un seul champ. - Remplacez les listes d’identifiants par une sous-requête sur un tag ou une propriété stable.
- Gardez
classicEntitySelectorpour la migration de sélecteurs existants ; pour la topologie, utilisez Smartscape. - Documentez dans un commentaire
//pourquoi une valeur est exclue.
Questions fréquentes
Quelle différence entre la fonction in() et l’opérateur in ?
La fonction in(needle, haystack) teste une liste connue ou un tableau. L’opérateur expression in [sous-requête] teste le résultat d’une autre requête DQL, qui doit renvoyer un seul champ.
Comment écrire « not in » en DQL ?
Avec not in(champ, {...}) dans un filter, ou avec filterOut in(champ, {...}). Les deux formes excluent les valeurs de la liste.
in() fonctionne-t-il sur Dynatrace Managed ?
Non : DQL repose sur Grail, disponible sur Dynatrace SaaS. Sur Managed, filtrez avec le sélecteur d’entités et le metric selector ; voir le parcours Dynatrace Managed.
Conclusion
En DQL, fonction in() pour une liste ou un tableau, opérateur in pour une sous-requête : ces deux outils remplacent les conditions à rallonge et les listes figées. Combinés à summarize, ils donnent des requêtes courtes, justes et qui suivent l’évolution de l’environnement. Pour d’autres requêtes prêtes à l’emploi, voir nos requêtes DQL d’exploitation.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Les marques citées appartiennent à leurs propriétaires. La syntaxe DQL évolue : vérifiez-la dans la documentation officielle avant de l’utiliser en production.