Votre équipe utilise la pile Elastic pour les logs et hésite à lui confier aussi l’APM, ou envisage de la remplacer : Elastic APM vs Dynatrace est la question qui revient en revue d’architecture. Les deux produits collectent des traces, des métriques et des logs, mais ils reposent sur des choix très différents. Cet article pose une grille de critères que vous pouvez vérifier vous-même, sans verdict.
Chaque fait technique ci-dessous vient d’une page officielle (documentation Elastic ou docs.dynatrace.com), lue pour l’occasion. Nous ne citons aucun prix : les tarifs dépendent du contrat et se lisent sur les pages officielles. Même démarche que dans nos comparatifs Dynatrace vs Datadog et Dynatrace vs New Relic. Côté Dynatrace, il s’agit de la plateforme SaaS ; Managed est signalé quand il compte.
Elastic APM vs Dynatrace : les différences de fond
Elastic décrit son APM comme un système « construit sur la Elastic Stack » : il mesure les temps de réponse des requêtes, des appels de base de données et des appels HTTP externes, et regroupe les erreurs par trace de pile. Dynatrace repose sur OneAgent, un agent unique par hôte qui découvre les processus et active l’instrumentation de la pile applicative. Le tableau résume les points documentés.
| Critère | Elastic APM | Dynatrace |
|---|---|---|
| Collecte | Agents de langage, ou SDK et Collector EDOT (distributions OpenTelemetry d’Elastic) | OneAgent (instrumentation automatique) ou OTLP, au choix service par service |
| OpenTelemetry | Point d’entrée OTLP géré (Serverless et Elastic Cloud Hosted), données stockées au format OTel ; l’entrée OTLP d’APM Server traduit en ECS et n’est plus recommandée pour de nouveaux projets | API OTLP directe en OTLP/HTTP, ou via un Collector (standard, Dynatrace ou Bindplane) ; traces, métriques et logs |
| Langage de requête | ES|QL, langage à pipes ; Query DSL | DQL sur le stockage Grail |
| Analyse de cause | Regroupement des erreurs par trace de pile ; autres fonctions à vérifier dans votre édition | Analyse de cause racine par IA causale sur une topologie causale ; regroupe les anomalies liées en un problème |
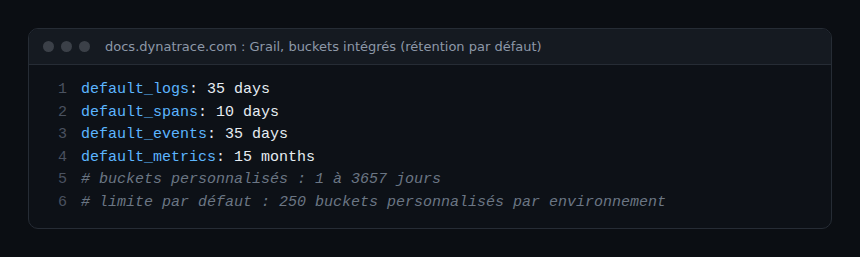
| Rétention | Politiques ILM (phases hot, warm, cold, frozen, delete) ; cycle de vie des flux de données en Serverless | Buckets Grail : 35 jours (logs), 10 jours (spans), 15 mois (métriques) par défaut ; buckets personnalisés de 1 à 3657 jours |
| Hébergement | Serverless, Cloud Hosted, ECK, ECE ou auto-géré | SaaS, ou Managed sur votre infrastructure |
| Modèle de facturation | Observability Serverless : Go ingérés et données stockées, comptés séparément | Dynatrace Platform Subscription : capacités modulaires, avec ingestion, rétention et requêtes facturées séparément pour logs, traces, événements et métriques |
Sur la rétention, les durées Dynatrace ci-dessus sont celles de la documentation Grail ; les buckets intégrés ne sont pas modifiables.
Instrumentation : agent propriétaire ou OpenTelemetry
Pour une équipe plateforme, la première question est l’effort de mise en route. Avec OneAgent, la documentation Dynatrace indique qu’une seule instance par hôte découvre tous les processus et instrumente automatiquement les nouveaux composants. Il fonctionne sur les grands clouds, Kubernetes, Docker et plusieurs systèmes dont Linux et Windows.
Côté Elastic, la page APM recommande désormais Elastic OpenTelemetry pour collecter la télémétrie applicative. Les EDOT incluent un Collector personnalisé et des SDK (.NET, Java, Node.js, PHP, Python, Android, iOS ; Browser en préversion technique). À partir de la version 9.5, la capacité du Collector EDOT est intégrée à Elastic Agent. Nous détaillons ce chemin dans l’article sur Elastic Agent et le Collector OpenTelemetry et dans celui sur OTLP et APM Server.
Point à noter dans les deux sens. Elastic précise que les outils contrib du Collector amont sont soutenus par la communauté : l’éditeur ne peut pas fournir de support d’implémentation et l’installation automatique du contenu OpenTelemetry n’a pas lieu. Dynatrace précise de son côté que les SDK OpenTelemetry n’offrent pas les fonctions propres au RUM (sessions, actions utilisateur, Core Web Vitals, Session Replay) ; pour le web et le mobile, il recommande le JavaScript RUM et OneAgent for Mobile. Dans les deux cas, OpenTelemetry reste utile comme socle portable, mais les fonctions les plus riches passent par la voie propre à l’éditeur.
Requêtes et exploration des données
Les deux plateformes proposent un langage à pipes. ES|QL est décrit comme « un langage à pipes pour filtrer, transformer et analyser » les données d’Elasticsearch, avec des commandes comme FROM, SORT et LIMIT. DQL explore les données stockées dans Grail (logs, métriques, traces, événements) sans schéma prédéfini, selon la documentation. Pour une même question, comparez la lisibilité et le temps d’écriture.
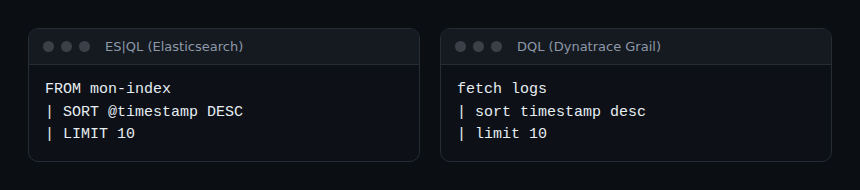
Ces deux exemples sont de nous, écrits avec les commandes nommées dans les documentations ; adaptez le nom d’index ou la source à votre environnement.
Rétention et exploitation
C’est souvent là que les équipes ressentent la différence au quotidien. Avec Elasticsearch, la rétention se gère par des politiques ILM : vous choisissez quand un index passe de hot à warm, cold ou frozen, et quand la phase delete le supprime. La documentation précise qu’ILM n’est pas disponible en Elasticsearch Serverless, où le cycle de vie des flux de données prend le relais. C’est une grande liberté, avec la charge de réglage qui l’accompagne ; pour le coût des niveaux froids, voir notre article sur le frozen tier.
Avec Dynatrace SaaS, la rétention se règle par bucket Grail. Réduire la période d’un bucket supprime définitivement les données plus anciennes, et cette suppression peut prendre jusqu’à quelques jours. Les buckets intégrés ont une durée fixe ; il faut créer un bucket personnalisé pour en choisir une.
Côté hébergement, Elastic liste cinq options, de Serverless (exploité par Elastic) à l’auto-géré, où vous avez « le contrôle complet et la responsabilité » du déploiement. Dynatrace Managed s’installe sur votre infrastructure : vous installez et configurez le cluster, avec haute disponibilité et auto-surveillance documentées. Si la souveraineté impose l’auto-hébergement, les deux familles le permettent ; l’effort d’exploitation est à chiffrer.
Coût de possession : ce que dit la documentation
Nous ne comparons pas de prix : les unités diffèrent et tout chiffre sans votre volume serait trompeur. Estimez avec vos propres volumes et demandez une offre écrite datée.
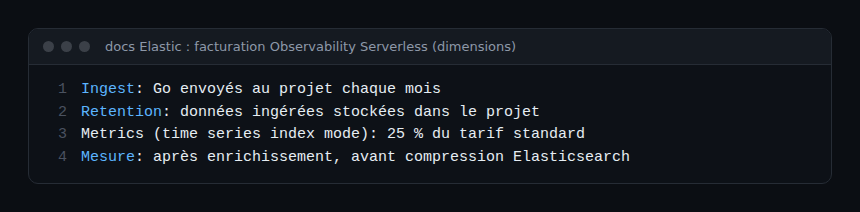
Pour Elastic Observability Serverless, l’ingestion se facture sur les Go envoyés chaque mois, la rétention sur les données stockées, et les métriques en mode time series sont comptées à 25 % du tarif standard. Les volumes sont mesurés après enrichissement et avant compression, donc ils peuvent dépasser la taille d’index affichée par Elasticsearch. Dynatrace modélise son offre en capacités ; pour les logs, traces, événements et métriques, l’ingestion, la rétention et la requête sont trois lignes distinctes.
Comment mener la comparaison en pratique
- Choisissez trois services représentatifs (un monolithe, une API, un job asynchrone) et fixez la grille avant de commencer.
- Envoyez les mêmes données OTLP aux deux plateformes grâce à un Collector qui duplique les flux, comme dans le déploiement du Collector sur Kubernetes.
- Chronométrez trois pannes injectées (latence d’une dépendance, OOMKilled, erreur 500 après déploiement) jusqu’à la cause.
- Écrivez la même requête dans ES|QL et dans DQL et notez la lisibilité.
- Comptez les heures d’exploitation : montées de version, réglage de rétention, support.
- Projetez la facture sur trois ans à partir d’offres écrites.
Comment vérifier que la comparaison est équitable
- Les volumes de spans reçus sont comparables des deux côtés sur la même période ; sinon, vérifiez l’échantillonnage (voir le tail sampling).
- La rétention testée est équivalente : un bucket de spans à 10 jours n’est pas comparable à un index conservé 30 jours.
- Les mêmes personnes d’astreinte testent les deux outils, sans connaître le scénario.
Bonnes pratiques
- Gardez OpenTelemetry comme socle d’instrumentation : le choix de la plateforme reste réversible. Pour le contexte, lisez observabilité et monitoring.
- Sourcez chaque critère dans la documentation et datez la lecture.
- Rédigez un compte rendu blameless : ce qui a marché, ce qui a coincé, sans désigner de perdant.
Questions fréquentes
Elastic APM accepte-t-il OpenTelemetry nativement ?
D’après la documentation Elastic, un point d’entrée OTLP géré existe sur Serverless et Elastic Cloud Hosted, avec stockage au format OTel. L’entrée OTLP d’APM Server, plus ancienne, traduit les données en ECS. Vérifiez la voie correspondant à votre déploiement.
Dynatrace conserve-t-il les traces aussi longtemps qu’Elasticsearch ?
Par défaut, le bucket intégré des spans garde 10 jours, selon la documentation Grail ; un bucket personnalisé peut aller de 1 à 3657 jours. Côté Elastic, la durée dépend de votre politique ILM ou de votre cycle de vie. Comparez à durée égale.
Peut-on garder les deux outils ?
Techniquement oui, avec un Collector qui duplique les flux. Cela double toutefois l’effort d’exploitation ; c’est plus raisonnable pour une transition que comme cible.
Conclusion
Elastic APM et Dynatrace répondent à des besoins voisins avec des philosophies différentes : une pile modulable que vous réglez, ou une plateforme qui automatise davantage. Le bon choix dépend de votre contexte, de vos volumes et de vos contraintes d’hébergement, pas d’un classement. Une grille fixée à l’avance, les mêmes données OTLP et des offres écrites donnent une décision défendable.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni à Elastic N.V. Dynatrace et Elastic sont des marques de leurs propriétaires respectifs. Les fonctionnalités évoluent : vérifiez-les dans la documentation officielle (Dynatrace, Elastic APM).