Cette formation observabilité gratuite rassemble en un seul chemin les parcours publiés sur span.observer : les concepts, les signaux, les métriques, les SLO, puis la mise en pratique sur une plateforme. Elle s’adresse aux ingénieurs d’exploitation, SRE, développeurs et administrateurs qui veulent passer de la supervision par seuils à une observabilité qui explique les incidents.
Vous n’avez pas besoin de tout suivre. La page indique un ordre conseillé, ce que chaque parcours apporte, et comment choisir entre la branche Dynatrace Managed (cluster hébergé chez vous, interface classique, metric selector) et la branche Dynatrace SaaS (plateforme Grail, DQL, Notebooks). Tous les modules sont gratuits, sans inscription.
Chaque module suit la même forme : une leçon courte, un exercice pratique réalisable sur un environnement de test, un quiz corrigé et des liens vers la documentation officielle.
Le plan de la formation observabilité
| Étape | Contenu | Format | Pour qui |
|---|---|---|---|
| 1. Concepts | Observabilité vs monitoring | Article de référence | Tous |
| 2. Métriques | Parcours métriques Managed ou parcours métriques SaaS | 7 modules chacun | Exploitation, SRE |
| 3. Fiabilité | Formation SLO SLA | 6 modules | SRE, responsables de service |
| 4. Plateforme | Parcours Dynatrace Managed ou parcours Dynatrace SaaS | 8 modules chacun | Administrateurs, équipes plateforme |
L’ordre va du général au particulier : comprendre ce qu’on mesure, apprendre à lire les métriques, fixer des objectifs de fiabilité, puis maîtriser l’outil. Si vous administrez déjà une plateforme, commencez par l’étape 4 et revenez aux étapes 2 et 3 ensuite.
Étape 1 — Les concepts : signaux et questions
La supervision répond à des questions prévues à l’avance (« le CPU dépasse-t-il 90 % ? »). L’observabilité permet de répondre à des questions qu’on ne s’était pas posées, à partir des signaux émis par le système. L’article observabilité vs monitoring pose ces définitions et les erreurs fréquentes.
Trois types de télémétrie reviennent dans tous les parcours, à ne jamais confondre :
- Traces : le chemin d’une requête à travers les services. Une trace se compose de spans, un par opération.
- Métriques : des mesures numériques agrégées dans le temps (débit, erreurs, durée, saturation).
- Logs : des événements horodatés, textuels ou structurés.
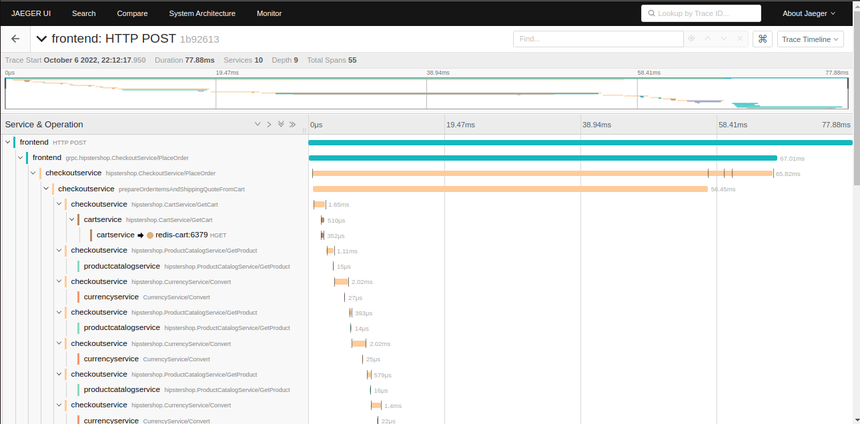
La capture ci-dessus, tirée de la démo OpenTelemetry, montre une trace : chaque barre est un span, et la cascade révèle immédiatement quel appel consomme le temps. C’est ce type de lecture que les parcours apprennent à faire, dans des outils open source comme dans Dynatrace.
Étape 2 — Les métriques : clés, dimensions, requêtes
Les deux parcours métriques suivent le même plan en 7 modules : comprendre les clés et les dimensions, puis les métriques d’hôte, de service, d’application, de processus et conteneurs, de cloud, et enfin les requêtes et l’alerting. Ils diffèrent par le langage :
- Managed : métriques
builtin:, metric selector et API Metrics v2 ; - SaaS : métriques
dt.*stockées dans Grail, requêtées avec la commande DQLtimeseries.
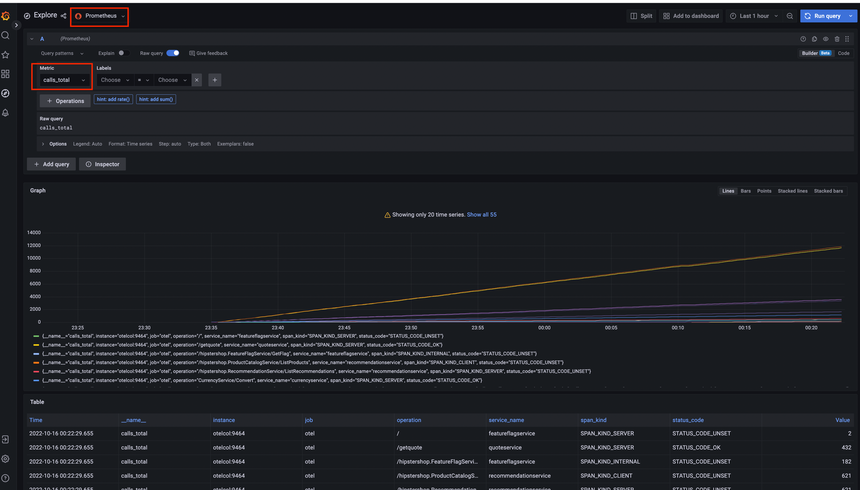
Cette capture, également issue de la démo OpenTelemetry, illustre la notion de dimension : une même métrique, calls_total, se découpe par service, opération, type de span et code de statut. Savoir choisir la bonne dimension évite les tableaux de bord illisibles et les alertes inutiles.
Étape 3 — La fiabilité : SLI, SLO, SLA
La formation SLO SLA transforme les métriques en engagements. Ses 6 modules couvrent les définitions et les erreurs courantes, le calcul du budget d’erreur et du burn rate, la création d’un SLO dans Dynatrace SaaS puis dans Dynatrace Managed, la politique de budget d’erreur (gel des déploiements, alertes) et la rédaction d’un SLA à partir des SLO.
C’est l’étape qui change le quotidien d’une équipe d’astreinte : on alerte sur la consommation du budget d’erreur, pas sur chaque pic de CPU. Moins d’alertes, plus pertinentes, et un MTTR qui se mesure.
Étape 4 — La plateforme : Managed ou SaaS
Parcours Dynatrace Managed (8 modules)
Concepts, architecture et installation d’un cluster de test, déploiement de OneAgent et ActiveGate, exploration des données et des PurePath, alerting et profils d’alerte, tags et management zones, exploitation du cluster (santé, sauvegardes, mises à jour) et automatisation par API. À choisir si votre organisation exploite un cluster Managed.
Parcours Dynatrace SaaS (8 modules)
Plateforme Grail et ses applications, déploiement de OneAgent et de Dynatrace Operator sur Kubernetes, fondamentaux de DQL, Notebooks et Dashboards, analyse des problèmes, logs avec OpenPipeline, Workflows et enfin OpenTelemetry et IA. À choisir pour un environnement SaaS ou un essai gratuit.
Les deux parcours ne se mélangent pas : les menus, les API et les langages de requête diffèrent. Si vous migrez de l’un à l’autre, suivez d’abord celui de votre environnement actuel.
Comment suivre la formation efficacement
- Préparez un environnement de test : un essai SaaS, ou un environnement Managed de recette. Les exercices ne doivent jamais toucher la production.
- Un module par séance : leçon, exercice, quiz. Notez les réponses fausses du quiz, ce sont vos points à revoir.
- Appliquez sur un service réel : après les métriques et les SLO, rédigez le SLO d’un service que vous connaissez.
- Complétez avec les sources officielles : la documentation OpenTelemetry pour les signaux, la documentation Dynatrace pour la plateforme, et Dynatrace University pour les certifications officielles.
Comment vérifier vos acquis
- Vous savez expliquer la différence entre une trace, un span, une métrique et un log, avec un exemple pris dans votre système.
- Vous savez écrire une requête qui compte les erreurs d’un service par minute (metric selector sur Managed, DQL sur SaaS).
- Vous savez calculer le budget d’erreur d’un SLO de 99,9 % sur 30 jours : 0,1 % de 43 200 minutes, soit 43,2 minutes.
- Vous savez dire quelle alerte réveillerait l’astreinte, et pourquoi.
Questions fréquentes
Cette formation observabilité est-elle vraiment gratuite ?
Oui. Tous les parcours et modules sont en accès libre, sans inscription. Seul l’environnement de test peut avoir un coût, selon l’offre de l’éditeur.
Faut-il connaître Dynatrace pour commencer ?
Non. Les étapes 1 à 3 valent pour toute plateforme d’observabilité ; les captures de cette page viennent d’ailleurs d’outils open source. Seule l’étape 4 est propre à Dynatrace.
Cette formation donne-t-elle une certification ?
Non. span.observer est un blog indépendant : les parcours préparent à la pratique, pas à un examen. Les certifications officielles relèvent de Dynatrace University.
Conclusion
Une formation observabilité utile suit l’ordre du travail réel : comprendre les signaux, lire les métriques, fixer des objectifs de fiabilité, puis maîtriser la plateforme. Les quatre étapes de cette page relient les parcours existants en un chemin cohérent ; commencez par l’étape qui correspond à votre besoin du moment.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Ce parcours ne remplace pas les formations et certifications officielles de Dynatrace University. Vérifiez les fonctionnalités dans la documentation officielle de votre version.