Module 2 du parcours métriques Dynatrace Managed, consacré aux hôtes infrastructure : 20 métriques builtin:host.* choisies pour l’exploitation, avec leur clé exacte, leur unité, leurs agrégations et une requête metric selector prête à copier.
Parcours : Formation aux métriques Dynatrace Managed · Module 2/7 · Domaine : hôtes et infrastructure · Plateforme : Dynatrace Managed (Metrics API v2, metric selector)
Un hôte saturé fait tomber tout ce qu’il porte : processus, services, puis l’expérience des utilisateurs. Les métriques d’hôte sont donc le premier étage de tout diagnostic. La liste des métriques builtin de Dynatrace Managed en compte des centaines ; une vingtaine suffit pour couvrir le CPU, la mémoire, le disque, le réseau et la disponibilité.
Ce module applique la grille de lecture du module 1 (comprendre les métriques) aux hôtes. Chaque fiche donne la clé, ce qu’elle mesure, un usage et un piège ; gardez-la sous la main pendant un diagnostic.
Tout ce qui suit vaut pour Dynatrace Managed et pour les métriques classiques de Dynatrace SaaS. Sur Grail, les équivalents portent des clés dt.host.* et s’interrogent en DQL : c’est l’objet du parcours métriques SaaS.
Hôtes infrastructure : le tableau récapitulatif
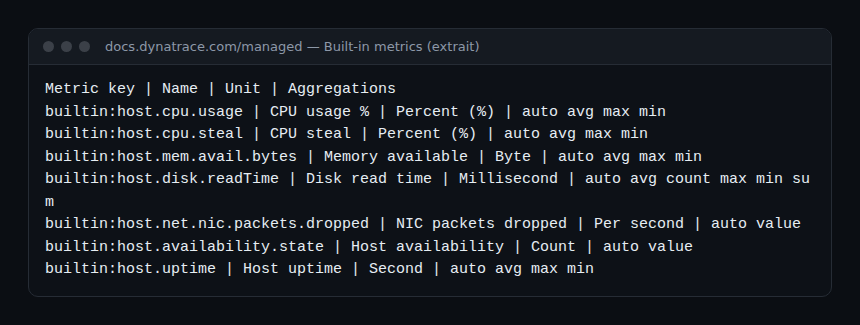
Les clés, unités et agrégations viennent de la page Built-in metrics de la documentation Managed. Toutes ont la dimension dt.entity.host ; les métriques de disque ajoutent dt.entity.disk, celles d’interface réseau une dimension d’interface.
| Clé | Unité | Agrégations | Ce qu’elle mesure |
|---|---|---|---|
builtin:host.cpu.usage |
% | avg, max, min | CPU utilisé |
builtin:host.cpu.user |
% | avg, max, min | CPU en mode utilisateur |
builtin:host.cpu.system |
% | avg, max, min | CPU en mode noyau |
builtin:host.cpu.iowait |
% | avg, max, min | Attente d’entrées-sorties |
builtin:host.cpu.steal |
% | avg, max, min | CPU volé par l’hyperviseur |
builtin:host.cpu.load |
Ratio | avg, max, min | Charge système sur 1 minute |
builtin:host.mem.usage |
% | avg, max, min | Mémoire utilisée |
builtin:host.mem.avail.bytes |
Byte | avg, max, min | Mémoire disponible |
builtin:host.mem.swap.used |
Byte | avg, max, min | Swap utilisé |
builtin:host.mem.avail.pfps |
Par seconde | avg, max, min | Défauts de page |
builtin:host.disk.usedPct |
% | avg, max, min | Espace disque utilisé |
builtin:host.disk.avail |
Byte | avg, max, min | Espace disque disponible |
builtin:host.disk.inodesAvail |
% | avg, max, min | Inodes libres |
builtin:host.disk.queueLength |
Count | avg, max, min | File d’attente disque |
builtin:host.disk.readTime |
Milliseconde | avg, count, max, min, sum | Latence de lecture |
builtin:host.disk.writeTime |
Milliseconde | avg, count, max, min, sum | Latence d’écriture |
builtin:host.net.nic.trafficIn |
bit/s | avg, max, min | Trafic entrant |
builtin:host.net.nic.packets.dropped |
Par seconde | value | Paquets rejetés |
builtin:host.availability.state |
Count | value | État de disponibilité |
builtin:host.uptime |
Seconde | avg, max, min | Temps depuis le démarrage |
Les métriques hôte builtin du CPU
builtin:host.cpu.usage
Le pourcentage de temps CPU utilisé, tous cœurs confondus. C’est la métrique de saturation la plus regardée. Utilisez max plutôt que la moyenne par défaut pour voir les pics : une moyenne sur l’intervalle masque facilement une saturation courte. Croisez toujours avec cpu.load avant de conclure.
builtin:host.cpu.usage:splitBy("dt.entity.host"):max:sort(value(max,descending)):limit(10)builtin:host.cpu.user
La part du CPU passée en mode utilisateur, c’est-à-dire dans le code des applications. Si cpu.usage monte et que cpu.user en porte l’essentiel, cherchez du côté des processus applicatifs (module 5 du parcours).
builtin:host.cpu.user:splitBy("dt.entity.host"):avgbuiltin:host.cpu.system
La part en mode noyau. Une valeur haute et durable évoque beaucoup d’appels système, de commutations de contexte ou d’interruptions réseau. C’est un signal à comparer à l’historique de l’hôte, pas à un seuil absolu.
builtin:host.cpu.system:splitBy("dt.entity.host"):maxbuiltin:host.cpu.iowait
Le temps où le CPU était inactif alors qu’une entrée-sortie restait en attente. La documentation précise que la métrique n’existe pas sous Windows. Un iowait qui grimpe en même temps que la latence disque désigne le stockage, pas le CPU.
builtin:host.cpu.iowait:splitBy("dt.entity.host"):maxbuiltin:host.cpu.steal
Le temps pendant lequel une machine virtuelle attend des cycles que l’hyperviseur donne à d’autres VM ; la documentation l’indique pour les hôtes Linux. Une application lente sur un hôte à CPU modéré mais steal élevé relève de l’équipe de virtualisation, pas de l’équipe applicative.
builtin:host.cpu.steal:splitBy("dt.entity.host"):avg:sort(value(avg,descending))builtin:host.cpu.load
Le nombre moyen de processus en exécution ou en attente du CPU sur la dernière minute (load5m et load15m existent aussi). L’unité est un ratio : comparez-le au nombre de cœurs de l’hôte. Une charge supérieure au nombre de cœurs signifie une file d’attente.
builtin:host.cpu.load:splitBy("dt.entity.host"):maxMémoire
builtin:host.mem.usage
Le pourcentage de mémoire utilisée, calculé par OneAgent comme total moins disponible. Piège connu : la valeur ne correspond pas au « used » de free ou du Gestionnaire des tâches, car le cache récupérable est compté comme disponible. Ne comparez pas les deux chiffres en pleine crise.
builtin:host.mem.usage:splitBy("dt.entity.host"):maxbuiltin:host.mem.avail.bytes
La mémoire disponible en octets, estimée sans recours au swap. C’est souvent un meilleur indicateur d’alerte que le pourcentage : sur un gros serveur, 5 % libres représentent encore plusieurs gigaoctets.
builtin:host.mem.avail.bytes:splitBy("dt.entity.host"):min:sort(value(min,ascending)):limit(10)builtin:host.mem.swap.used
L’espace de swap utilisé, en octets. Un swap stable n’inquiète pas ; un swap qui augmente en même temps que la mémoire disponible baisse annonce une pression mémoire et des temps de réponse dégradés.
builtin:host.mem.swap.used:splitBy("dt.entity.host"):maxbuiltin:host.mem.avail.pfps
Les défauts de page par seconde, défauts légers et lourds confondus selon la documentation. Seule, la valeur se lit mal ; une rupture nette par rapport à la semaine précédente, combinée à du swap, confirme un manque de mémoire.
builtin:host.mem.avail.pfps:splitBy("dt.entity.host"):avgDisque
builtin:host.disk.usedPct
Le pourcentage d’espace utilisé par système de fichiers. C’est la métrique des alertes « disque plein ». Pensez à la tendance : une partition à 80 % qui gagne 2 points par jour est plus urgente qu’une partition stable à 90 %.
builtin:host.disk.usedPct:splitBy("dt.entity.host","dt.entity.disk"):max:sort(value(max,descending)):limit(20)builtin:host.disk.avail
L’espace libre en octets. Sous Linux et AIX, la documentation précise qu’il s’agit de l’espace disponible pour un utilisateur non privilégié, hors réserve root : la valeur peut donc être plus basse que celle de df en root.
builtin:host.disk.avail:splitBy("dt.entity.host","dt.entity.disk"):minbuiltin:host.disk.inodesAvail
Le pourcentage d’inodes libres, absent sous Windows. Un disque peut refuser toute écriture alors qu’il reste de l’espace : c’est le cas typique des répertoires remplis de petits fichiers (sessions, files d’attente, journaux tournants).
builtin:host.disk.inodesAvail:splitBy("dt.entity.host","dt.entity.disk"):minbuiltin:host.disk.queueLength
Le nombre moyen d’opérations de lecture et d’écriture en file d’attente. Une file qui reste haute signale un disque qui n’absorbe plus la demande ; lisez-la avec les temps de lecture et d’écriture ci-dessous.
builtin:host.disk.queueLength:splitBy("dt.entity.host","dt.entity.disk"):maxbuiltin:host.disk.readTime
Le temps moyen d’une lecture sur le système de fichiers, en millisecondes : la latence disque vue par l’hôte. Elle explique souvent une base de données lente sans que le CPU bouge.
builtin:host.disk.readTime:splitBy("dt.entity.host","dt.entity.disk"):avgbuiltin:host.disk.writeTime
Le pendant en écriture, en millisecondes. Les journaux de transactions et les files de messages y sont très sensibles. Comparez la valeur avant et après une migration de stockage pour objectiver le changement.
builtin:host.disk.writeTime:splitBy("dt.entity.host","dt.entity.disk"):maxRéseau, disponibilité et OS
builtin:host.net.nic.trafficIn
Le trafic entrant par interface, en bits par seconde ; builtin:host.net.nic.trafficOut donne le sortant. Attention à l’unité : divisez par 8 pour comparer à un débit en octets. Rapportez la valeur à la capacité de l’interface.
builtin:host.net.nic.trafficIn:splitBy("dt.entity.host"):max:sort(value(max,descending)):limit(10)builtin:host.net.nic.packets.dropped
Les paquets rejetés par seconde sur les interfaces ; des variantes droppedRx et droppedTx séparent réception et émission. Toute valeur durablement non nulle mérite un regard, surtout si les retransmissions des services augmentent.
builtin:host.net.nic.packets.dropped:splitBy("dt.entity.host")builtin:host.availability.state
L’état de disponibilité de l’hôte, rapporté toutes les minutes. Elle sert à mesurer une disponibilité d’infrastructure ou à vérifier qu’un hôte n’a pas disparu pendant une fenêtre donnée. Avant de filtrer sur un état, lisez les dimensions exactes dans le descripteur de votre environnement.
builtin:host.availability.state:splitBy("dt.entity.host")builtin:host.uptime
Le temps écoulé depuis le dernier démarrage, en secondes. La documentation indique qu’elle demande OneAgent 1.259 ou plus et n’existe pas en mode application-only. Pratique pour repérer un redémarrage imprévu juste avant un incident.
builtin:host.uptime:splitBy("dt.entity.host"):min:sort(value(min,ascending)):limit(10)Comment vérifier que ça fonctionne
- Listez les clés réellement présentes dans votre environnement :
curl -s "$DT_URL/api/v2/metrics?metricSelector=builtin:host.*&fields=unit,aggregationTypes" \ -H "Authorization: Api-Token $DT_TOKEN" - Lisez le descripteur d’une clé (
GET /api/v2/metrics/builtin:host.disk.avail) : unité, agrégations et dimensions doivent correspondre au tableau. - Collez une requête de ce module dans le Data Explorer, en mode code. Une erreur de syntaxe s’affiche immédiatement ; une série vide signale un hôte non surveillé ou une métrique non disponible sur l’OS.
Le jeton doit porter le scope metrics.read. La syntaxe complète du metric selector est détaillée dans le module metric selector et API.
Bonnes pratiques
- Précisez toujours l’agrégation : sans elle, la moyenne par défaut lisse les pics.
- Alertez sur les octets disponibles plutôt que sur un pourcentage pour les gros volumes.
- Lisez CPU, iowait et latence disque ensemble avant de désigner un coupable.
- Gardez les seuils propres à votre parc : la documentation ne fixe pas de valeur « normale ».
Questions fréquentes
Pourquoi ne pas citer toutes les métriques builtin:host.* ?
La liste officielle en compte plusieurs dizaines, dont des métriques z/OS ou AIX très spécifiques. Ce module garde celles qui servent dans la majorité des diagnostics ; la page Built-in metrics reste la référence exhaustive.
Faut-il apprendre les vingt clés par cœur ?
Non. Retenez la logique (CPU, mémoire, disque, réseau, disponibilité) et revenez au tableau récapitulatif quand vous construisez un tableau de bord ou une alerte.
Ces clés fonctionnent-elles sur Dynatrace SaaS ?
Oui, comme métriques classiques via l’API v2. Sur Grail, utilisez les clés dt.host.* et la commande DQL timeseries, décrites dans le parcours métriques SaaS.
Ces vingt fiches couvrent le socle d’un diagnostic d’hôte. Le module suivant monte d’un étage : les services, leurs requêtes et leurs erreurs. Pour aller plus loin sur l’infrastructure, voir aussi l’architecture de Dynatrace Managed.
← Module 1 : comprendre les métriques · Sommaire du parcours · Module 3 : services →
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Les clés et unités citées proviennent de la documentation officielle Dynatrace Managed ; vérifiez-les dans la version de votre cluster.