Ghidra MCP est un bon cas d’école pour brancher un agent IA sur un outil local. Le projet open source GhidraMCP (licence Apache 2.0) expose les fonctions de Ghidra, l’outil d’analyse de binaires de la NSA, à n’importe quel client MCP : lister les fonctions d’un programme, décompiler, suivre les références croisées, renommer des symboles. Les équipes de sécurité défensive l’utilisent pour accélérer l’analyse de leurs propres binaires ou d’échantillons en laboratoire.
Pour l’exploitation, la question n’est pas « que sait faire l’agent ? » mais « que peut-il toucher, et comment savoir ce qu’il a fait ? ». Un serveur MCP local tourne avec les droits de l’utilisateur, lit des fichiers, et certains de ses outils modifient l’état du projet. Ce guide montre comment isoler ce type d’intégration et tracer chaque appel d’outil, sans rien aborder d’offensif.
Le contenu ne dépend pas de Dynatrace. Si vous envoyez les traces des agents vers Dynatrace SaaS ou Dynatrace Managed, la partie traçabilité s’appuie sur les mêmes conventions OpenTelemetry que notre article sur l’observation des agents MCP.
Comment fonctionne Ghidra MCP
GhidraMCP comporte deux parties :
- un plugin Ghidra qui ouvre un petit serveur HTTP. Son code n’écoute que sur
127.0.0.1et n’accepte que les noms d’hôte127.0.0.1,localhostet[::1]; - un serveur MCP en Python (
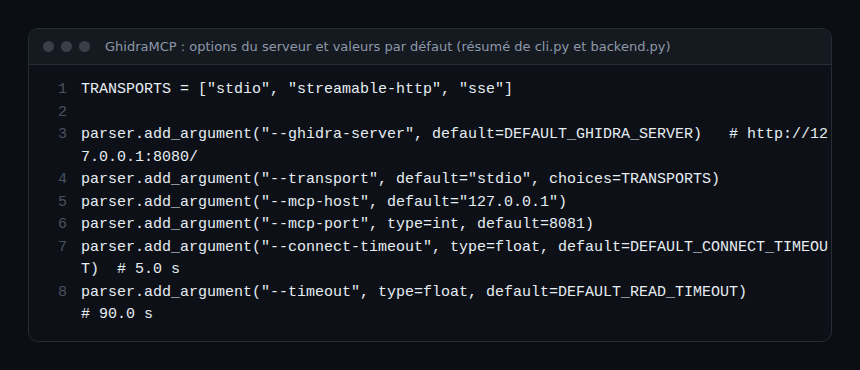
ghidra-mcp) qui traduit les appels d’outils MCP en requêtes vers ce plugin. Par défaut, il ciblehttp://127.0.0.1:8080/.
Le serveur MCP accepte trois transports : stdio (par défaut, le client lance le processus), streamable-http et sse, ce dernier étant déprécié. En HTTP, il écoute par défaut sur 127.0.0.1:8081. Un mode headless évite l’interface graphique : ghidra-mcp importe et analyse lui-même le binaire avec PyGhidra.
Si le protocole MCP vous est nouveau, commencez par le Model Context Protocol expliqué.
Inventorier ce que l’agent peut faire
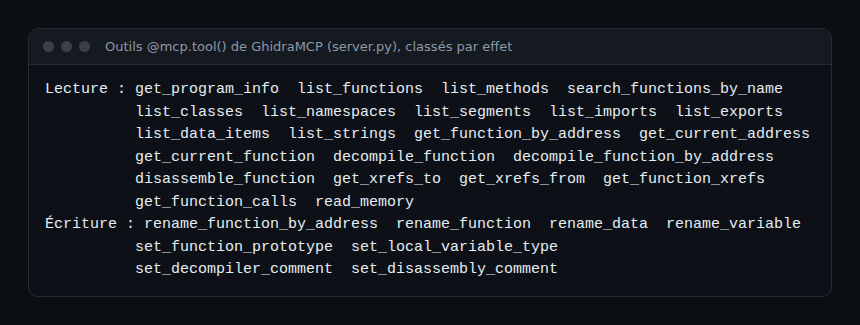
Avant tout branchement, listez les outils exposés et classez-les par effet. GhidraMCP en déclare une trentaine avec @mcp.tool(). La plupart lisent ; huit modifient le projet Ghidra (renommage, types, commentaires).
La spécification MCP prévoit des annotations d’outil (readOnlyHint, destructiveHint, idempotentHint, openWorldHint) pour signaler ces effets au client. GhidraMCP ne les renseigne pas, et la spécification précise de toute façon que ce ne sont que des indications : un client ne doit pas s’y fier quand le serveur n’est pas de confiance. Votre propre classement fait foi.
En pratique : isoler un serveur Ghidra MCP
Étape 1 — Garder tout en local
Préférez le transport stdio : aucun port n’est ouvert, le client lance et arrête le processus. Si vous devez utiliser streamable-http, laissez --mcp-host à 127.0.0.1. N’exposez jamais ce port sur le réseau : un serveur MCP n’a pas d’authentification par défaut, comme rappelé dans sécuriser un serveur MCP.
Étape 2 — Travailler sur une copie, en mode headless
Le mode headless rend l’analyse reproductible et facile à enfermer. Sans --project, GhidraMCP utilise un projet temporaire et abandonne les modifications à la sortie (--discard est le comportement par défaut dans ce cas). Montez le binaire en lecture seule et coupez le réseau du conteneur :
docker run -i --rm --network none \
  -v "$PWD/echantillons:/work:ro" \
  image-ghidra-mcp-interne \
  ghidra-mcp --headless --binary /work/programme-a-analyser --discard
L’image est à construire vous-même (Ghidra, Java et l’extension GhidraMCP) : le projet ne publie pas d’image de conteneur. --network none garantit qu’un échantillon analysé ou un outil détourné ne peut rien joindre. Le client MCP communique par l’entrée et la sortie standard grâce à -i.
Étape 3 — Garder un humain dans la boucle pour l’écriture
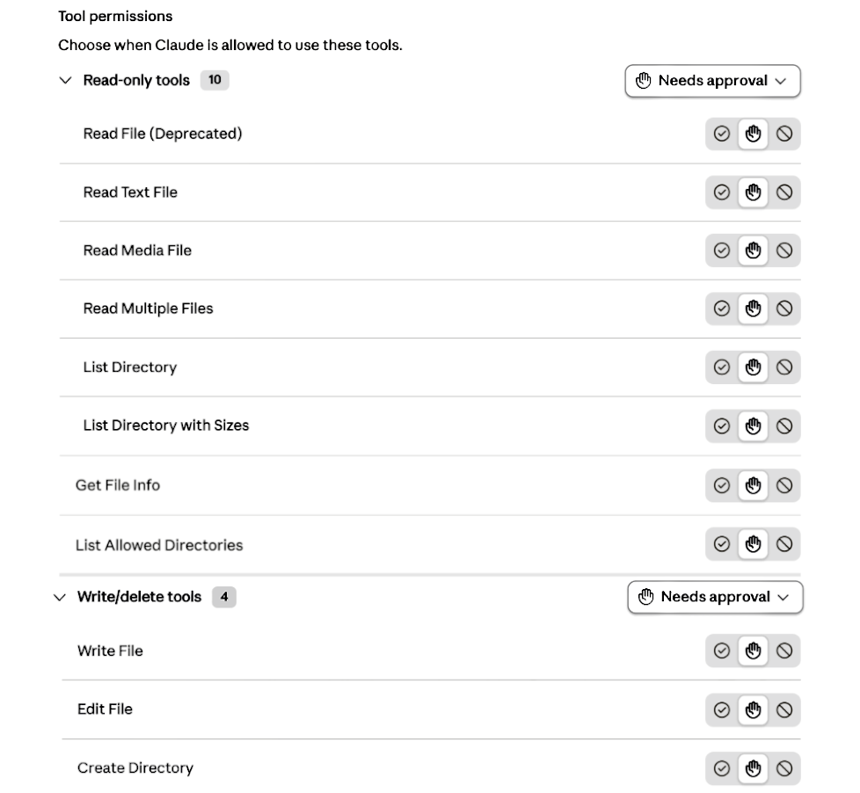
La spécification MCP recommande qu’un humain puisse toujours refuser un appel d’outil et que le client affiche clairement quel outil est appelé. Approuvez au cas par cas les huit outils d’écriture ; autorisez durablement les seuls outils de lecture, et seulement après inventaire. Certains clients regroupent déjà les outils par effet, comme dans l’exemple ci-dessous avec un autre serveur MCP local.
Tracer chaque appel d’outil
GhidraMCP écrit ses journaux sur la sortie d’erreur, au niveau INFO : démarrage, connexion à Ghidra, import et analyse du binaire. Il ne journalise pas chaque appel d’outil. La traçabilité doit donc venir de l’agent ou du client :
- Les traces OpenTelemetry de l’agent : les conventions sémantiques MCP d’OpenTelemetry (statut Development) nomment le span
{mcp.method.name} {target}, par exempletools/call decompile_function, avec les attributsmcp.method.name,mcp.session.idetgen_ai.tool.name. La durée côté client se mesure avec l’histogrammemcp.client.operation.duration. - Les journaux stderr du serveur : redirigez-les vers un fichier ou votre collecteur de logs pour garder la trace des démarrages et des erreurs de backend.
- Le MCP Inspector pendant la mise au point : il affiche chaque message
tools/call, ses paramètres, sa réponse et sa durée.
Avec ces traces, une question d’audit (« quel agent a renommé cette fonction, et quand ? ») se résout par une recherche de span au lieu d’une enquête manuelle. Pour instrumenter vous-même un serveur, voyez créer un serveur MCP en Python.
Comment vérifier que ça fonctionne
- Au démarrage, la sortie d’erreur contient une ligne
INFO:ghidra_mcp.headless:Analyzing …puisServing …. - Depuis le conteneur, une tentative de connexion réseau échoue :
--network noneest effectif. - Dans votre backend de traces, un appel
tools/callapparaît avecgen_ai.tool.namerenseigné, et un outil d’écriture n’apparaît qu’après approbation.
Bonnes pratiques
- Un serveur MCP par périmètre : un binaire, un conteneur, une session.
- Inventoriez les outils à chaque mise à jour du serveur : une nouvelle version peut ajouter un outil d’écriture.
- Fixez des délais :
--timeout(90 s par défaut) borne l’attente du backend,--ready-timeout(30 s) celle de l’analyse en mode headless. - Ne passez jamais de secret dans les arguments de l’outil : ils finissent dans les traces.
- Limitez l’usage aux binaires que vous avez le droit d’analyser, dans un environnement de laboratoire.
Questions fréquentes
Ghidra MCP fonctionne-t-il avec n’importe quel client MCP ?
Le README indique qu’en théorie tout client MCP convient, et donne des exemples pour VS Code et Claude Code. Les clients qui se connectent par URL utilisent le transport streamable-http.
Faut-il l’interface graphique de Ghidra ?
Non. Le mode headless (--headless --binary) lance Ghidra dans le processus via PyGhidra. Il demande Python 3.10 à 3.13 et l’extension GhidraMCP installée.
Les annotations readOnlyHint suffisent-elles à bloquer les écritures ?
Non. Ce sont des indications fournies par le serveur. Le contrôle réel se fait côté client (approbation, liste d’outils autorisés) et par l’isolation du processus.
Conclusion
Brancher un agent sur un outil local comme Ghidra MCP demande la même rigueur qu’un accès en production : inventaire des outils, moindre privilège, isolation réseau, humain dans la boucle pour les écritures et traces exploitables. Sources : dépôt GhidraMCP et spécification MCP des outils.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni aux projets cités. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans leur documentation officielle.