Mistral Large 4 en auto-hébergement est la question que se posent déjà les équipes plateforme depuis l’annonce du 6 octobre 2026. Avant de commander des GPU, il faut séparer ce qui est publié de ce qui est promis. À la date de cet article (15 octobre 2026), Mistral propose une préversion du modèle via son API et sa plateforme Mistral Studio, et annonce la publication des poids « d’ici la fin du mois ». Aucun dépôt de poids n’existe encore sous le compte mistralai de Hugging Face, et la licence n’est pas publiée.
On ne peut donc pas encore auto-héberger Mistral Large 4. On peut en revanche préparer le terrain : estimer la mémoire nécessaire à partir des chiffres officiels, s’appuyer sur ce que Mistral a documenté pour Mistral Large 3, et mettre en place la supervision d’un serveur d’inférence multi-GPU. C’est l’objet de ce guide, orienté exploitation.
Ce sujet ne dépend pas de Dynatrace : les métriques citées sont au format Prometheus et peuvent être collectées par n’importe quel backend, dont Dynatrace SaaS et Dynatrace Managed.
Mistral Large 4 : ce qui est publié au 15 octobre 2026
L’annonce officielle de Mistral donne les éléments suivants :
- un modèle d’environ 1 000 milliards de paramètres, dont 52 milliards actifs par token : c’est une architecture à mélange d’experts (MoE) ;
- un modèle nativement multimodal (entrée texte et image), qui combine instruction et raisonnement dans un seul modèle ;
- un entraînement sur 3 800 GPU NVIDIA Grace Blackwell dans les centres de données de Mistral ;
- une préversion accessible par API, des poids promis pour la fin du mois, et davantage de détails sur l’architecture à ce moment-là.
Ce qui manque pour dimensionner sérieusement : la licence, la longueur de contexte, les formats de poids publiés (FP8, NVFP4 ou autre) et la version de vLLM prise en charge. Tant que ces points ne sont pas publiés, tout chiffre de matériel reste une estimation.
Estimer la mémoire d’un modèle de 1 000 milliards de paramètres
Dans un modèle MoE, tous les experts doivent résider en mémoire GPU, même si seuls quelques-uns travaillent pour chaque token. La mémoire dépend donc du nombre total de paramètres ; le calcul par token dépend des paramètres actifs. Le volume des seuls poids se calcule simplement :
poids (octets) = paramètres totaux × octets par paramètre

1 000 milliards × 2 octets   (BF16)      ≈ 2 To
1 000 milliards × 1 octet    (FP8)       ≈ 1 To
1 000 milliards × 0,5 octet  (4 bits)    ≈ 0,5 To
Il faut y ajouter le cache clé-valeur (KV cache), qui grandit avec la longueur de contexte et le nombre de requêtes simultanées, ainsi que la marge du moteur d’inférence. Ces ordres de grandeur suffisent pour une première conclusion : même quantifié, Mistral Large 4 vise un nœud de GPU de centre de données, ou plusieurs, et pas un poste de travail. Pour un usage local, des modèles plus petits servis par Ollama restent la voie réaliste.
Le point de repère publié : Mistral Large 3
La fiche Hugging Face de Mistral Large 3 (675 milliards de paramètres au total, 41 milliards actifs, licence Apache 2.0, contexte de 256k tokens) donne des chiffres de déploiement officiels :
- la version FP8 tourne sur un seul nœud de B200 ou de H200, avec un exemple sur un nœud 8xH200 ;
- la version NVFP4 tourne sur un seul nœud de H100 ou de A100.
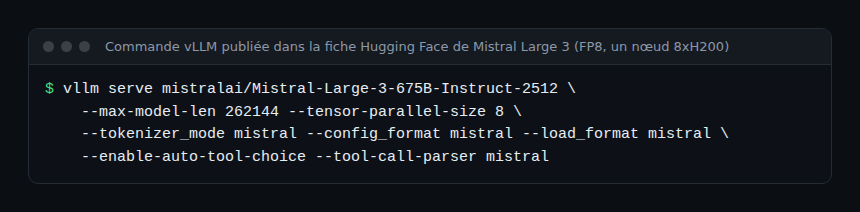
À précision égale, Large 4 compte environ 1,5 fois plus de paramètres que Large 3. Attendez la fiche officielle avant de conclure qu’un nœud suffira : le format de quantification publié changera tout. La fiche de Large 3 rappelle aussi que --max-model-len peut être réduit pour économiser de la mémoire : c’est le premier levier si le cache KV manque de place.
En pratique : préparer l’auto-hébergement
Étape 1 — Tester sur la préversion API
Mesurez dès maintenant vos cas d’usage réels sur l’API : longueur moyenne des prompts, longueur des réponses, besoin en contexte long, appels d’outils. Ces mesures fixent la longueur de contexte à configurer et la concurrence à prévoir, donc la taille du cache KV.
Étape 2 — Valider la chaîne sur Mistral Large 3
Le pipeline de déploiement (stockage des poids, téléchargement, démarrage, sondes de santé, supervision) peut être rodé avec Large 3, dont les poids et la licence sont publiés. Sur plusieurs GPU, vLLM découpe le modèle par parallélisme de tenseurs (--tensor-parallel-size) et, si besoin, de pipeline (--pipeline-parallel-size). Sur un seul nœud, il s’appuie sur multiprocessing ; sur plusieurs nœuds, sur Ray.
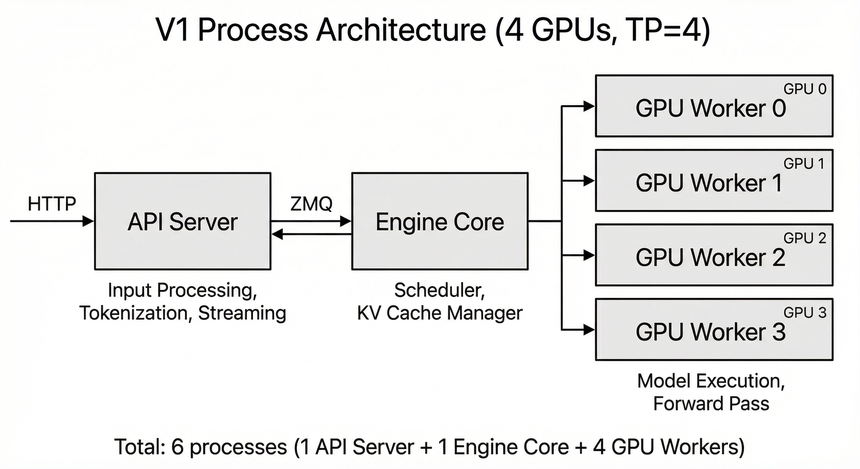
Ce schéma montre ce qu’il faut superviser : le serveur API (entrée HTTP, tokenisation), le cœur du moteur (ordonnanceur et cache KV) et un processus par GPU. Un GPU qui tombe arrête toute l’instance : avec le parallélisme de tenseurs, il n’y a pas de dégradation partielle.
Étape 3 — Brancher la supervision
vLLM expose ses métriques au format Prometheus sur /metrics, avec le préfixe vllm:. Pour un gros modèle MoE, suivez en priorité :
vllm:kv_cache_usage_perc: part du cache KV utilisée (0 à 1). Proche de 1, les requêtes attendent ;vllm:num_requests_running: requêtes en cours ;vllm:time_to_first_token_seconds: temps jusqu’au premier token (TTFT), sensible à la longueur des prompts ;vllm:inter_token_latency_seconds: délai entre deux tokens, ressenti directement en streaming ;vllm:request_queue_time_secondsetvllm:e2e_request_latency_seconds: attente et durée totale ;vllm:prompt_tokens_totaletvllm:generation_tokens_total: volume traité, pour le calcul du coût par token.
Le détail de la collecte et des tableaux de bord est dans notre guide vLLM en production. Ajoutez les métriques des GPU (mémoire, température, utilisation) : sur un nœud à huit GPU, un seul composant en surchauffe ralentit tout le lot.
Comment vérifier que ça fonctionne
curl http://localhost:8000/v1/modelsrenvoie le nom du modèle servi.curl -s http://localhost:8000/metrics | grep vllm:kv_cache_usage_percrenvoie une valeur entre 0 et 1.- Sous charge de test, le TTFT p95 reste sous votre objectif et
vllm:kv_cache_usage_percne reste pas collé à 1.
Bonnes pratiques
- Ne figez aucun budget matériel avant la publication de la fiche officielle et de la licence de Mistral Large 4.
- Définissez les SLO avant le déploiement : TTFT, latence inter-token, disponibilité. Ils dictent la concurrence admissible.
- Prévoyez le temps de démarrage : charger un modèle de cette taille prend du temps, ce qui allonge la reprise après incident (MTTR).
- Stockez les poids au plus près des nœuds : retélécharger 1 To à chaque redémarrage n’est pas une stratégie.
- Comparez avec l’API : selon votre volume, le coût d’un nœud dédié peut ne pas se justifier. Notre panorama des stacks IA auto-hébergées aide à trancher.
Questions fréquentes
Peut-on télécharger Mistral Large 4 aujourd’hui ?
Non, pas au 15 octobre 2026. Mistral annonce les poids pour la fin du mois ; seule la préversion API est disponible.
Mistral Large 4 sera-t-il sous licence Apache 2.0 ?
Ce n’est pas publié. Mistral Large 3 l’est, mais rien ne garantit que Large 4 suive la même licence. Lisez la fiche du modèle à sa sortie.
Pourquoi 52 milliards de paramètres actifs ne suffisent-ils pas à réduire la mémoire ?
Parce que le routeur peut choisir n’importe quel expert à chaque token : tous doivent être chargés. Les paramètres actifs réduisent le calcul, pas la mémoire des poids.
Conclusion
Mistral Large 4 n’est pas encore auto-hébergeable, mais son ordre de grandeur est connu : environ 1 000 milliards de paramètres, donc au moins un nœud de GPU de centre de données. Profitez de l’attente pour mesurer vos usages sur l’API, roder la chaîne avec Mistral Large 3 et brancher la supervision. Pour aller plus loin sur les exigences de ce type de charge, lisez ce que les charges IA exigent des SRE. Sources : annonce de Mistral Large 4 et fiche de Mistral Large 3.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni à Mistral AI. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans leur documentation officielle.