
Un martes, el equipo de pagos añade un pipeline de logs y se olvida de la etiqueta de centro de costes. Tres semanas después, finanzas descubre un volumen sin responsable. Los grupos de pipelines de OpenPipeline sirven exactamente para esto: decidir qué se ejecuta siempre, para todos, y qué puede ajustar cada equipo por su cuenta.
Aquí parto de una decisión de operación, no de un recorrido por la interfaz. Los datos proceden de la documentación oficial de OpenPipeline y de la entrada del fabricante, leídas el 12 de noviembre de 2026. No he probado la función en un tenant, y lo que no está comprobado queda señalado. Vale para Dynatrace SaaS; la entrada no menciona Managed y no afirmo nada sobre él.
Para crear un pipeline y enrutarlo, mira el tutorial del pipeline de logs y su ruta. Aquí nos ocupamos de lo que pasa cuando veinte equipos hacen lo mismo.
El problema: una regla copiada veinte veces acaba divergiendo
Dos reflejos habituales fallan a escala. El primero lo bloquea todo: el equipo de plataforma aprueba cada cambio y un simple filtro se convierte en un ticket. El segundo copia reglas: cada equipo pega el bloque «etiqueta de coste + contexto de seguridad» y las copias se van separando.
En ambos casos el precio se paga en fiabilidad y en dinero: un paso de seguridad omitido, una factura inesperada, un retraso para observar un servicio nuevo. La pregunta de fondo es qué etapas impone la plataforma y cuáles se dejan a los equipos.
Grupos de pipelines de OpenPipeline: cómo funcionan
Un grupo reúne pipelines y fija su orden de ejecución. Reglas básicas, según la documentación:
- un pipeline pertenece a un solo grupo a la vez;
- los grupos no se anidan;
- un pipeline base permanece inactivo mientras no esté en un grupo.
El grupo contiene una «composición»: una lista ordenada de pipelines base y un único hueco reservado a los pipelines miembro. Lo colocado antes del hueco se ejecuta primero, los pipelines de los equipos se ejecutan en el hueco y lo colocado después va al final.
De ahí salen dos roles. El pipeline base (basePipeline) lleva la configuración común. El pipeline miembro (memberPipeline) lleva la lógica de un equipo. La interfaz muestra una insignia «Member pipeline» en los miembros.
Imponer y restringir: dos palancas distintas
La documentación separa dos mecanismos, y conviene entenderlos antes de diseñar nada.
- Imponer (mandate): las etapas de los pipelines base de la composición se ejecutan siempre, en el orden definido respecto a las etapas de los miembros. Ejemplo de la documentación: una etapa de permisos antes de la lógica de un departamento.
- Restringir (restrict): las etapas excluidas dejan de estar disponibles para los miembros. Un equipo puede añadir etapas opcionales tras las impuestas, pero no redefinir las restringidas.
Ojo con una trampa: si un pipeline base y uno miembro activan la misma etapa, se ejecutan las dos. Para bloquearla en los miembros hay que excluirla mediante memberStages.
Paso a paso: diseñar un grupo para tus logs
Este es un método de diseño que debes adaptar. Parto de un caso ficticio: dos unidades de negocio y un equipo de plataforma.
- Anota lo que nunca debe variar. Por ejemplo: unidad de negocio, centro de costes, contexto de seguridad, bucket de almacenamiento según la retención. Eso serán tus pipelines base.
- Colócalos alrededor del hueco. Lo que debe quedar fijado antes de que los equipos toquen los datos va antes del hueco; la asignación de almacenamiento puede ir después.
- Define las etapas abiertas a los miembros con
memberStages:includeAlloinclude. - Enlaza los pipelines de los equipos en
memberPipelines. - Aplica la configuración con la API Settings: la vista JSON de la interfaz es de solo lectura.
El esquema sigue el patrón builtin:openpipeline.<ámbito>.pipeline-groups, con un ámbito por tipo de dato (logs, spans, metrics, events, bizevents, etc.). Cada tipo tiene, por tanto, sus propios grupos.
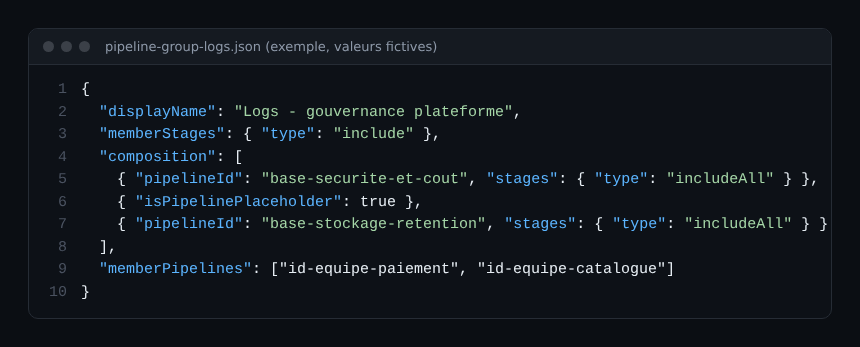
Los nombres de campo salen de la documentación; los identificadores y valores son inventados. No he comprobado el valor exacto que espera stages.type en la composición: revísalo en el esquema de tu tenant antes de aplicar nada.
Enrutamiento: qué cambia para los miembros
Dentro de un grupo, un pipeline miembro recibe los datos de la primera ruta que coincide. Los pipelines base de un grupo normalmente no se pueden enrutar; los pipelines listos para usar de las extensiones, fuera de un grupo, son la excepción. En la práctica tus rutas apuntan a los pipelines de los equipos y la plataforma no tiene que vigilarlas una a una: el suelo común se aplica solo.
Si ya enmascaras datos, un pipeline base es el sitio ideal para esa regla, porque ningún equipo puede saltársela. Mira el enmascarado de datos sensibles con OpenPipeline.
Cómo comprobar que funciona
Tras aplicar el cambio, revisa en un Notebook que cada registro lleva los campos impuestos. Si falta uno, la etapa base no se ejecutó.
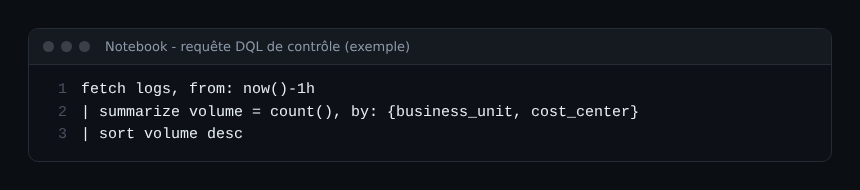
Los campos business_unit y cost_center son los que añade mi grupo ficticio; sustitúyelos por los tuyos. Una fila con valores vacíos es la señal que hay que perseguir: una vía de ingesta que esquiva el grupo. Para vigilar también los silencios de ingesta, mira la detección de huecos de cobertura.
Buenas prácticas
- Reserva la propiedad del grupo a administradores de plataforma o SRE; deja los pipelines miembro a los equipos de aplicación.
- Mantén cortos los pipelines base: seguridad, coste, almacenamiento y nada más.
- Prueba cualquier cambio de grupo en un tipo de dato de poco volumen antes de extenderlo.
- Documenta quién es dueño de cada pipeline miembro, porque el grupo no lo hace por ti.
Preguntas frecuentes
¿Puede un pipeline pertenecer a dos grupos?
No. Según la documentación, un pipeline pertenece a un solo grupo a la vez y los grupos no se anidan.
¿Puede un equipo esquivar una etapa impuesta?
No si pertenece a un pipeline base de la composición: se ejecuta siempre. Una etapa excluida con memberStages no está disponible para los miembros. Cuidado con las etapas activadas en ambos lados: se ejecutan las dos.
¿Existe la función en Dynatrace Managed?
La entrada del fabricante indica disponibilidad general en la versión SaaS 1.332 y no menciona Managed. No lo he verificado para Managed: consulta su documentación antes de planificar.
Conclusión
Los grupos de pipelines de OpenPipeline separan «lo que siempre debe ocurrir» de «lo que decide cada equipo» y hacen que la plataforma respete esa frontera. Empieza con un solo tipo de dato y tres reglas base. Fuente principal: documentación de los grupos de pipelines.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.