Un pic d’erreurs dans les logs, et la même question revient : combien, de quel niveau, et depuis quand ? Pour les DQL erreurs logs, la méthode tient en deux temps : d’abord un tableau par niveau avec summarize, puis une courbe avec makeTimeseries. Cet article donne les requêtes, explique ce que chaque commande renvoie et comment éviter les pièges.
Objectif : repérer en quelques minutes si les erreurs montent, à quel moment et sur quel niveau de gravité, sans exporter les logs. Périmètre : DQL interroge Grail, donc tout ce qui suit vaut pour Dynatrace SaaS uniquement. Dynatrace Managed n’a pas Grail. Cet article complète nos 15 requêtes DQL d’exploitation en se concentrant sur un seul cas d’usage.
En bref
summarizerenvoie un tableau : une ligne par groupe, ici parloglevel.makeTimeseriesrenvoie une série temporelle : un tableau de valeurs par tranche de temps, prête pour un graphique.- Les deux commandes ne s’enchaînent pas pour le même résultat : on choisit l’une ou l’autre selon la question.
- Pour une série sans trou, on combine
defaultetnonempty.
Prérequis
- Un environnement Dynatrace SaaS avec Grail et des logs ingérés (OneAgent, Collector OpenTelemetry ou API).
- Le droit de lire les logs et d’ouvrir un Notebook ou un Dashboard.
- Les bases de
fetchetfilter; sinon, voir les fondamentaux de DQL.
Le champ loglevel décrit la gravité de l’événement de log. La page du dictionnaire sémantique Dynatrace le décrit comme « the log event severity level » et cite ERROR, INFO et TRACE en exemples ; elle ne donne pas de liste fermée. Avant de copier une requête, vérifiez donc les valeurs présentes chez vous avec la première requête ci-dessous.
DQL erreurs logs : compter par niveau avec summarize
La commande fetch accepte les paramètres from et to sous forme de durées relatives. La documentation donne l’exemple fetch logs, from: -24h, to: -2h. Notre première requête lit les dernières 24 heures et compte les enregistrements par niveau.
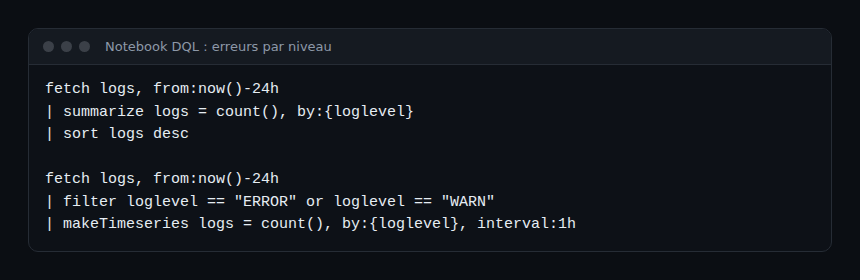
fetch logs, from:now()-24h
| summarize logs = count(), by:{loglevel}
| sort logs desc
La syntaxe de la documentation est summarize [field =] aggregation, ... [, by: {[field =] expression, ...}]. Ici, count() « compte le nombre total d’enregistrements » de chaque groupe. Le résultat est un tableau avec une ligne par valeur de loglevel.
Lire le tableau avec méthode
- Repérez les niveaux présents : ERROR, WARN, INFO, mais aussi d’éventuelles valeurs vides ou inattendues.
- Comparez ERROR au volume total. Un volume d’erreurs qui double compte plus que sa valeur absolue.
- Vérifiez le groupe
null. La documentation précise que les enregistrements qui n’ont pas le champ dubysont regroupés sousnull. Des logs sans niveau faussent le ratio d’erreurs.
Si aucun enregistrement ne correspond et qu’il n’y a pas de by, summarize renvoie quand même une ligne, avec count() à 0. Un « 0 » peut donc signifier « aucun log » autant que « aucune erreur » : contrôlez la fenêtre de temps.
Passer à une courbe avec makeTimeseries
Le tableau dit combien. Il ne dit pas quand. makeTimeseries répond à cette seconde question en découpant le temps en tranches.
fetch logs, from:now()-24h
| filter loglevel == "ERROR" or loglevel == "WARN"
| makeTimeseries logs = count(), by:{loglevel}, interval:1h
Le paramètre by scinde la série : vous obtenez une courbe par niveau. Le paramètre interval fixe la durée de chaque tranche. Pour des filtres plus compacts, voir la fonction in de DQL.
Ce que renvoie la commande
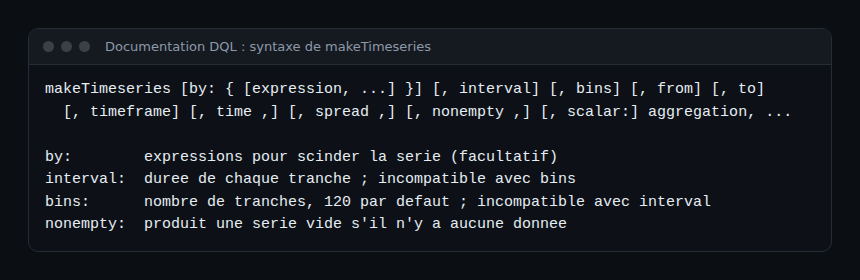
Selon la documentation, le résultat contient un champ timeframe (début et fin), un champ interval (par exemple « 1 min ») et la colonne d’agrégat. Cette colonne est un tableau avec une valeur par tranche, comme [1, 2, 1] dans l’exemple officiel. Ce format diffère d’un tableau de lignes : c’est ce qui permet d’afficher directement un graphique.
Interval ou bins
Deux paramètres règlent la finesse. interval donne la durée d’une tranche. bins donne le nombre de tranches, 120 par défaut. Les deux ne peuvent pas être utilisés ensemble. La documentation indique aussi que l’intervalle réel est ajusté à une valeur usuelle, que la série ne peut pas dépasser 1 500 éléments, et que les tranches s’alignent sur minuit dans le fuseau demandé : la période renvoyée peut donc être plus large que celle demandée.
En pratique, choisissez l’intervalle selon la question. Une tranche de 1 heure sur 24 heures suffit pour repérer une dérive ; pour dater un incident à la minute, réduisez la fenêtre plutôt que l’intervalle.
Remplir les trous : default et nonempty
Par défaut, une tranche sans donnée contient null. Le paramètre default de l’agrégation remplace cette valeur, par exemple par 0. Le paramètre nonempty traite l’autre cas : si aucun enregistrement n’est traité du tout, la commande ne renvoie rien sans lui. La documentation montre count(default: 0) avec interval: 30m et nonempty: true pour obtenir une série de zéros.
fetch logs, from:now()-24h
| filter loglevel == "ERROR"
| makeTimeseries errors = count(default:0), interval:30m, nonempty:true
Ce détail compte pour un graphique d’alerte : une courbe qui disparaît quand tout va bien prête à confusion, alors qu’une ligne à zéro confirme que la collecte fonctionne.
Comparer plusieurs niveaux avec countIf
Quand on veut plusieurs courbes dans une même requête, sans by, countIf(condition) « compte le nombre d’enregistrements qui correspondent à la condition ».
fetch logs, from:now()-24h
| makeTimeseries
    errors = countIf(loglevel == "ERROR"),
    warnings = countIf(loglevel == "WARN"),
    interval:1h
Cette forme évite de filtrer avant l’agrégation. Elle donne aussi un dénominateur : en ajoutant total = count(), vous pouvez comparer les erreurs au volume global. Je n’ai pas vérifié dans la documentation d’opération arithmétique entre séries dans cette commande ; calculez le ratio dans le Notebook ou le Dashboard.
Comment vérifier que ça fonctionne
- Lancez
fetch logs, from:now()-1h | limit 5et vérifiez queloglevelexiste dans vos enregistrements. - Exécutez la requête
summarizeet comparez la somme des lignes au total attendu. - Exécutez la requête
makeTimeserieset affichez-la en graphique linéaire : le nombre de courbes doit correspondre aux niveaux filtrés. - Réduisez la fenêtre à une période où vous connaissez un incident : la courbe doit y monter.
Bonnes pratiques
- Fixez toujours
from: une requête sans fenêtre explicite coûte plus de lecture et brouille la comparaison. - Gardez un seul cas par requête : tableau pour le bilan, série pour la chronologie.
- Pour relier une courbe à un SLO, partez de des SLI définis en DQL.
- Pour un Dashboard complet, voir les exemples de dashboards DQL.
- Si vos logs sont en JSON, extrayez d’abord les champs, comme dans cet article sur fieldsMove et jsonExtract.
- Côté OpenTelemetry, un log sans niveau tombe dans le groupe
null: vérifiez la sévérité à l’émission, voir les logs OpenTelemetry dans Dynatrace.
Questions fréquentes
Peut-on enchaîner summarize puis makeTimeseries ?
Ce n’est pas le bon usage. summarize produit un tableau agrégé, alors que makeTimeseries part des enregistrements et de leur horodatage (champ timestamp par défaut) pour construire la série. Pour obtenir une courbe, appliquez directement makeTimeseries après filter.
Pourquoi ma courbe contient-elle des valeurs null ?
Une tranche sans enregistrement est remplie par null par défaut. Utilisez count(default: 0) pour obtenir des zéros, et nonempty: true pour garder une série même sans aucun enregistrement.
Quelle différence avec la commande timeseries ?
timeseries interroge des métriques, makeTimeseries construit une série à partir d’enregistrements comme les logs. Pour les métriques, voir DQL timeseries et alertes. Les commandes de base sont rappelées dans filter, summarize et timeseries.
Conclusion
Un tableau par niveau pour le bilan, une série par niveau pour la chronologie : deux requêtes courtes suffisent à qualifier une montée d’erreurs. Pour un SRE, c’est un gain direct sur le MTTR, car le diagnostic initial ne dépend plus d’un export. Pour aller plus loin sur le regroupement, lisez DQL group by et summarize.
Sources
- DQL, commandes d’agrégation (summarize, makeTimeseries), documentation Dynatrace
- DQL, commandes de source de données (fetch), documentation Dynatrace
- DQL, fonctions d’agrégation (count, countIf), documentation Dynatrace
- Dictionnaire sémantique, modèle de log (loglevel), documentation Dynatrace
span.observer est un blog indépendant, non affilié à Dynatrace LLC. Les noms de produits cités appartiennent à leurs propriétaires respectifs ; les requêtes sont données à titre pédagogique et sont à adapter à vos données.