Le mode d’index logsdb Elasticsearch sert à stocker des logs de façon plus compacte, sans changer la façon dont vous les interrogez. Bonne nouvelle pour une équipe SRE : on l’active dans un modèle d’index, et il s’applique au prochain rollover. Aucune réindexation n’est nécessaire pour les nouvelles données.
Ce tutoriel montre comment mesurer le stockage actuel, activer logsdb, forcer la bascule et vérifier le résultat. Toutes les informations viennent de la documentation Elastic, citée en fin d’article. Les chiffres de gain sont ceux d’Elastic, pas des mesures de span.observer.
En bref
- logsdb est une valeur du réglage
index.mode, commestandard,time_seriesoulookup. - Selon la documentation, il est appliqué automatiquement aux nouveaux flux
logs-*-*à partir de la pile 9.0. Les flux existants ne basculent pas seuls. - La modification d’un modèle prend effet au prochain rollover : les anciens index gardent leur mode.
- Elastic annonce des gains « jusqu’à » 60 à 65 % selon la page. Mesurez avant et après sur vos propres logs.
Le problème : des logs qui coûtent cher à conserver
Les logs représentent souvent le plus gros volume d’une plateforme d’observabilité. Chaque jour de rétention ajoute du disque, des snapshots et du temps de restauration. Réduire ce volume améliore directement le coût par jour conservé, un point que les équipes plateforme suivent de près.
L’objectif ici est simple : activer logsdb sur un flux existant, vérifier qu’il est bien pris en compte, puis comparer la taille des index avant et après.
Ce que fait logsdb Elasticsearch
D’après le billet de Search Labs d’Elastic, logsdb combine trois techniques :
- un tri d’index intelligent, qui regroupe les données semblables pour mieux les compresser ;
- des codecs de compression avancés (Zstandard, delta, run-length), choisis automatiquement ;
- le
_sourcesynthétique, qui supprime le champ_sourcestocké et le reconstruit à la demande.
Le même billet précise le tri par défaut (host.name puis @timestamp) et indique qu’un autre ordre peut mieux convenir à vos données. Il signale aussi que logsdb consomme plus de CPU à l’indexation. La page de documentation parle d’un impact d’environ 10 à 20 % sur les performances d’indexation dans ses tests.
Côté licence, le billet indique que le tri et la compression relèvent des niveaux Standard, Gold ou Platinum, alors que le _source synthétique demande Enterprise ou Serverless. Vérifiez votre abonnement avant de planifier.
Prérequis et versions
- Un cluster Elasticsearch auto-géré, Elastic Cloud Hosted ou Serverless. Le billet donne une disponibilité générale à partir de la version 8.17.
- Un flux de données (data stream) de logs, par exemple
logs-mesapp-prod(nom fictif). - Le droit de modifier les modèles d’index et d’appeler l’API de rollover.
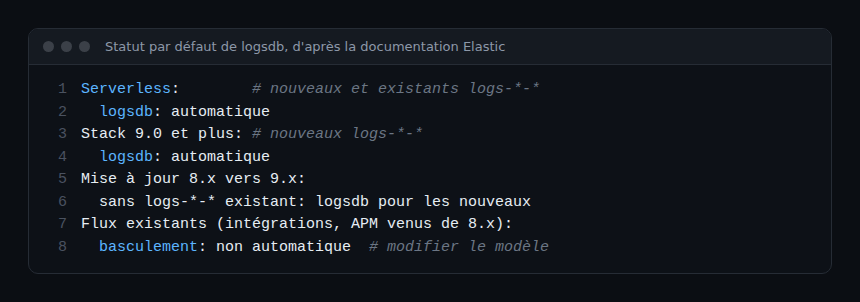
Point à corriger. Certaines annonces évoquent logsdb par défaut sur logs-* depuis la 9.2. La page officielle consultée ne cite pas cette version : elle indique « 9.0 et plus » pour les nouveaux flux. Nous retenons donc la formulation de la documentation.
Activer logsdb sans réindexer : pas à pas
Étape 1 : mesurer la taille avant
Notez la taille des index de support du flux. La console Kibana permet de lister les colonnes utiles de l’API cat (les colonnes docs.count et pri.store.size existent dans la référence de l’API) :
GET _cat/indices/.ds-logs-mesapp-*?h=index,docs.count,pri.store.size&s=indexComparez des index de même période et de volume proche, sinon la mesure ne signifie rien.
Étape 2 : placer index.mode dans le modèle
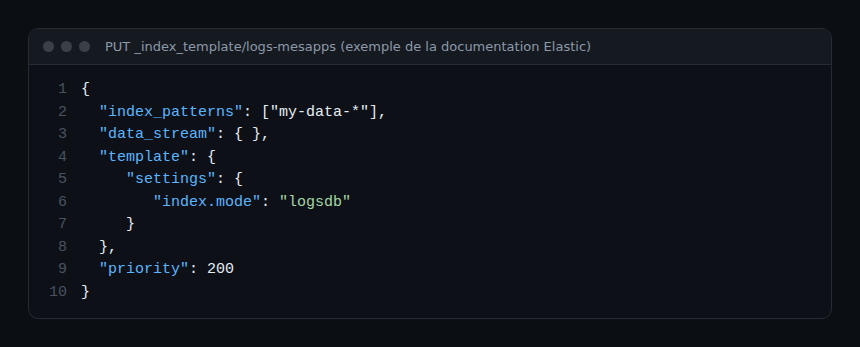
La documentation demande de définir index.mode à logsdb dans le modèle d’index, ou dans le modèle de composant @custom pour les flux d’intégrations. Voici l’exemple officiel :
{
  "index_patterns": ["my-data-*"],
  "data_stream": { },
  "template": {
     "settings": {
        "index.mode": "logsdb"
     }
  },
  "priority": 200
}
Attention : la page prévient qu’une requête PUT écrase le modèle existant. Récupérez d’abord la configuration en place et reprenez ses réglages. Dans Kibana, le même réglage se trouve dans Index Management, Index Templates, étape Logistics, champ Index mode.
Étape 3 : forcer le rollover
Le changement s’applique au prochain rollover. Vous pouvez attendre la règle ILM, ou forcer la bascule :
POST logs-mesapp-prod/_rolloverLa référence de l’API de rollover indique que, pour un flux de données, le rollover crée un nouvel index d’écriture, et que le paramètre new_index n’est pas pris en charge.
Étape 4 : vérifier
Lisez le flux avec l’API des flux de données. D’après sa référence, la réponse contient index_mode au niveau du flux (mode des futurs index de support) et pour chaque index de support :
GET _data_stream/logs-mesapp-prod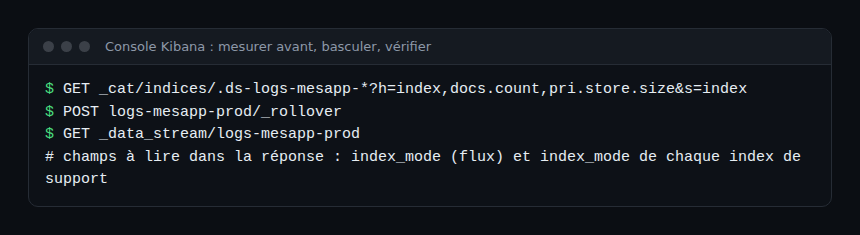
Comment vérifier que ça fonctionne
- Le flux annonce
logsdbdansindex_mode. - Le nouvel index de support (généré après le rollover) affiche aussi
logsdb; les anciens restent en mode précédent. - Après quelques heures d’ingestion normale, comparez
pri.store.sizerapporté au nombre de documents (docs.count) entre un index ancien et un index récent. - Rejouez vos requêtes habituelles de dashboards et d’alertes : les résultats doivent rester identiques.
Les anciennes données ne rétrécissent pas : seules les données écrites après le rollover profitent du mode. Pour convertir l’historique, il faudrait réindexer, ce que ce tutoriel évite volontairement.
Gains annoncés : à lire avec prudence
La page de documentation sur les flux de logs indique, dans ses benchmarks, une réduction du stockage allant jusqu’à 60 %, avec des résultats variables selon le jeu de données et la version. Le billet de Search Labs cite jusqu’à 65 % par rapport aux versions récentes sans logsdb, dont jusqu’à 30 % pour le tri et 20 à 40 % de plus pour le _source synthétique. Il ne décrit pas les jeux de données testés. Ces chiffres sont des plafonds fournis par l’éditeur : seule votre mesure compte.
Un autre billet d’Elastic, sur le stockage de logs à l’échelle du pétaoctet avec ILM, traite de l’architecture hot-frozen. Il ne mentionne pas logsdb et ses coûts sont un modèle illustratif de l’éditeur. Nous ne reprenons pas ses chiffres. Il offre en revanche une politique ILM d’un jour en hot puis frozen, utile pour combiner logsdb et rétention longue.
Limites et bonnes pratiques
- Mesurer avant d’activer : gardez un instantané des tailles et du débit d’indexation.
- Prévoir le CPU : surveillez la latence d’indexation après la bascule, c’est le compromis cité par Elastic.
- Ne pas écraser un modèle : relisez-le avant le PUT.
- Intégrations : passez par un modèle de composant
@custompar jeu de données, comme le décrit la documentation. - Tri par défaut : testez-le sur vos requêtes, l’ordre idéal dépend de vos champs.
Ce que cela change pour une équipe SRE
Chez span.observer, nous constatons que le coût du stockage des logs pousse souvent à raccourcir la rétention, donc à perdre du contexte lors d’un incident. Réduire l’empreinte sans toucher aux requêtes préserve cette fenêtre d’investigation, et un mode d’index se teste sur un seul flux avant d’être généralisé.
Ce réglage concerne le stockage Elasticsearch, pas la collecte. Si vos logs transitent par un Collector, le format OpenTelemetry ne change pas : voir notre guide sur le Collector OpenTelemetry sur Kubernetes. Pour situer le sujet, relisez observabilité et monitoring, puis le comparatif Dynatrace et Datadog ou le guide sur l’ingestion de logs dans Dynatrace. Nous n’affirmons aucune intégration particulière entre logsdb et Dynatrace.
Questions fréquentes
Faut-il réindexer pour utiliser logsdb ?
Non pour les nouvelles données : la documentation indique que la modification du modèle prend effet au prochain rollover. Les index existants gardent leur mode, donc l’historique ne gagne pas de place sans réindexation.
logsdb est-il activé par défaut ?
Selon la documentation, il est automatique sur les nouveaux flux logs-*-* de la pile 9.0 et plus, et sur Serverless pour les flux nouveaux et existants. Les flux existants d’une pile mise à jour depuis la 8.x ne basculent pas seuls.
Quel gain de stockage attendre ?
Elastic annonce jusqu’à 60 % dans la documentation et jusqu’à 65 % dans un billet, d’après ses benchmarks. Ces valeurs dépendent des données et de la version : mesurez avant et après sur vos index.
Conclusion
Activer logsdb tient en un réglage de modèle et un rollover. Mesurez la taille avant, vérifiez index_mode après, comparez sur des index équivalents, et gardez un œil sur le CPU d’indexation.
Sources
- Logs data stream, documentation Elastic
- Elasticsearch logsdb index mode, Elastic Search Labs
- Index modules, documentation Elastic
- Get data streams, référence de l’API Elasticsearch
- Roll over to a new index, référence de l’API Elasticsearch
span.observer est un blog indépendant, non affilié à Dynatrace LLC ni à Elastic N.V. Les noms de produits appartiennent à leurs propriétaires ; les noms de flux sont fictifs, et les chiffres de gain sont ceux annoncés par l’éditeur.