يُستخدم نمط الفهرس logsdb Elasticsearch لتخزين السجلات (logs) بشكل أكثر إحكامًا، دون تغيير طريقة الاستعلام عنها. وهذا خبر جيد لفريق SRE: يُفعَّل في قالب فهرس (index template) ويُطبَّق عند عملية rollover التالية. ولا حاجة إلى إعادة الفهرسة للبيانات الجديدة.
يوضح هذا الدرس كيف تقيس التخزين الحالي، وتفعّل logsdb، وتفرض التبديل، وتتحقق من النتيجة. كل المعلومات مأخوذة من وثائق Elastic المذكورة في نهاية المقال. أرقام الوفر هي أرقام Elastic وليست قياسات من span.observer.
باختصار
- logsdb قيمة للإعداد
index.mode، مثلstandardوtime_seriesوlookup. - بحسب الوثائق، يُطبَّق تلقائيًا على تدفقات
logs-*-*الجديدة بدءًا من الإصدار 9.0 للمنظومة (stack). أما التدفقات الموجودة فلا تتحول من تلقاء نفسها. - يسري تعديل القالب عند عملية rollover التالية: تحتفظ الفهارس القديمة بنمطها.
- تعلن Elastic عن وفر «يصل إلى» 60 إلى 65% بحسب الصفحة. قِس قبل التفعيل وبعده على سجلاتك أنت.
المشكلة: سجلات مكلفة في الاحتفاظ بها
غالبًا ما تمثل السجلات أكبر حجم في منصة قابلية الملاحظة (observability). وكل يوم احتفاظ يضيف قرصًا ولقطات (snapshots) ووقتًا للاستعادة. وتقليل هذا الحجم يحسّن مباشرة التكلفة لكل يوم محفوظ، وهي نقطة تتابعها فرق المنصة عن كثب.
الهدف هنا بسيط: تفعيل logsdb على تدفق موجود، والتأكد من أخذه في الحسبان، ثم مقارنة حجم الفهارس قبل التفعيل وبعده.
ماذا يفعل logsdb Elasticsearch
بحسب تدوينة Search Labs من Elastic، يجمع logsdb بين ثلاث تقنيات:
- ترتيب ذكي للفهرس، يجمع البيانات المتشابهة لضغطها بشكل أفضل؛
- ترميزات ضغط متقدمة (Zstandard وdelta وrun-length) تُختار تلقائيًا؛
_sourceالاصطناعي، الذي يحذف الحقل_sourceالمخزَّن ويعيد بناءه عند الطلب.
تذكر التدوينة نفسها الترتيب الافتراضي (host.name ثم @timestamp) وتشير إلى أن ترتيبًا آخر قد يناسب بياناتك أكثر. كما تنبّه إلى أن logsdb يستهلك مزيدًا من المعالج (CPU) أثناء الفهرسة. وتتحدث صفحة الوثائق عن أثر يقارب 10 إلى 20% في أداء الفهرسة في اختباراتها.
أما من جهة الترخيص، فتذكر التدوينة أن الترتيب والضغط ينتميان إلى المستويات Standard وGold وPlatinum، بينما يتطلب _source الاصطناعي مستوى Enterprise أو Serverless. تحقق من اشتراكك قبل التخطيط.
المتطلبات والإصدارات
- عنقود (cluster) Elasticsearch مُدار ذاتيًا، أو Elastic Cloud Hosted، أو Serverless. تذكر التدوينة توفرًا عامًا بدءًا من الإصدار 8.17.
- تدفق بيانات (data stream) للسجلات، مثل
logs-mesapp-prod(اسم افتراضي للتوضيح). - صلاحية تعديل قوالب الفهارس واستدعاء واجهة rollover.
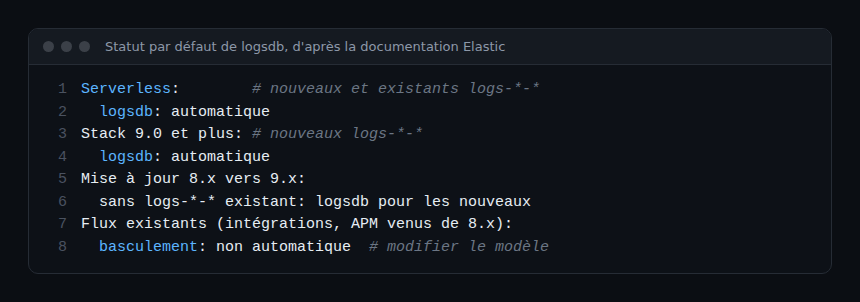
نقطة تستدعي التصحيح. تشير بعض الإعلانات إلى logsdb افتراضيًا على logs-* منذ الإصدار 9.2. لكن الصفحة الرسمية التي اطلعنا عليها لا تذكر هذا الإصدار: فهي تقول «9.0 وما بعده» للتدفقات الجديدة. لذلك نعتمد صياغة الوثائق.
تفعيل logsdb دون إعادة الفهرسة: خطوة بخطوة
الخطوة 1: قياس الحجم قبل التفعيل
دوّن حجم الفهارس الداعمة للتدفق. تتيح وحدة تحكم Kibana عرض الأعمدة المفيدة من واجهة cat (العمودان docs.count وpri.store.size موجودان في مرجع الواجهة):
GET _cat/indices/.ds-logs-mesapp-*?h=index,docs.count,pri.store.size&s=indexقارن فهارس من الفترة نفسها وبحجم متقارب، وإلا فلن يكون للقياس معنى.
الخطوة 2: وضع index.mode في القالب
تطلب الوثائق ضبط index.mode على logsdb في قالب الفهرس، أو في قالب المكوّن @custom لتدفقات التكاملات. وهذا هو المثال الرسمي:
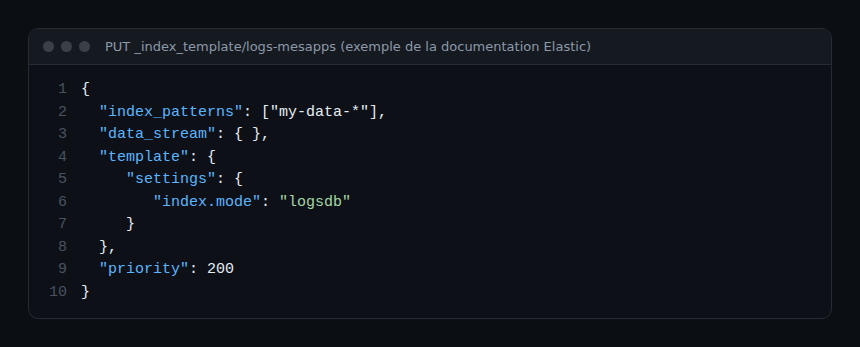
{
  "index_patterns": ["my-data-*"],
  "data_stream": { },
  "template": {
     "settings": {
        "index.mode": "logsdb"
     }
  },
  "priority": 200
}
انتبه: تحذّر الصفحة من أن طلب PUT يستبدل القالب الموجود. اجلب أولًا الإعداد الحالي وأعد استخدام إعداداته. في Kibana تجد الإعداد نفسه في Index Management ثم Index Templates ثم الخطوة Logistics والحقل Index mode.
الخطوة 3: فرض rollover
يُطبَّق التغيير عند عملية rollover التالية. يمكنك انتظار قاعدة ILM أو فرض التبديل:
POST logs-mesapp-prod/_rolloverيذكر مرجع واجهة rollover أن العملية، في حالة تدفق البيانات، تنشئ فهرس كتابة جديدًا، وأن المعامل new_index غير مدعوم.
الخطوة 4: التحقق
اقرأ التدفق عبر واجهة تدفقات البيانات. بحسب مرجعها، تحتوي الاستجابة على index_mode على مستوى التدفق (نمط الفهارس الداعمة المستقبلية) ولكل فهرس داعم:
GET _data_stream/logs-mesapp-prod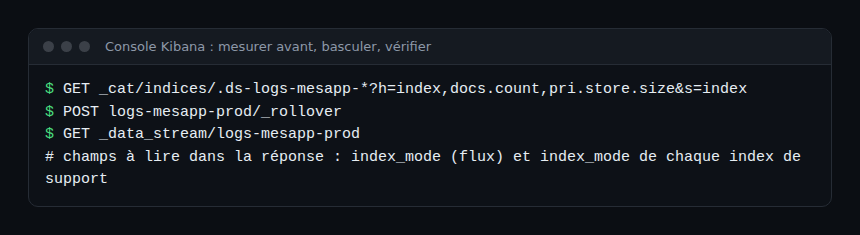
كيف تتحقق من أن الأمر يعمل
- يعلن التدفق القيمة
logsdbفيindex_mode. - يعرض الفهرس الداعم الجديد (المُنشأ بعد rollover) القيمة
logsdbأيضًا؛ وتبقى الفهارس القديمة على نمطها السابق. - بعد ساعات من الإدخال العادي، قارن
pri.store.sizeبالنسبة إلى عدد المستندات (docs.count) بين فهرس قديم وفهرس حديث. - أعد تشغيل استعلاماتك المعتادة للوحات المعلومات (dashboards) والتنبيهات: يجب أن تبقى النتائج متطابقة.
لا تتقلص البيانات القديمة: فقط البيانات المكتوبة بعد rollover تستفيد من النمط. ولتحويل السجل التاريخي يجب إعادة الفهرسة، وهو ما يتجنبه هذا الدرس عمدًا.
الوفر المعلن: اقرأه بحذر
تذكر صفحة الوثائق عن تدفقات السجلات، في اختباراتها المرجعية (benchmarks)، انخفاضًا في التخزين يصل إلى 60%، مع نتائج تختلف بحسب مجموعة البيانات والإصدار. وتذكر تدوينة Search Labs ما يصل إلى 65% مقارنة بإصدارات حديثة دون logsdb، منها ما يصل إلى 30% للترتيب و20 إلى 40% إضافية لـ _source الاصطناعي. ولا تصف مجموعات البيانات المختبَرة. هذه الأرقام سقوف تقدمها الجهة المصنِّعة: وحدها قياساتك تُعتمد.
تدوينة أخرى من Elastic، عن تخزين السجلات على مقياس البيتابايت باستخدام ILM، تتناول معمارية hot-frozen. لا تذكر logsdb، وتكاليفها نموذج توضيحي من الجهة المصنِّعة. لا نعتمد أرقامها. لكنها تقدم سياسة ILM بيوم واحد في hot ثم frozen، مفيدة للجمع بين logsdb والاحتفاظ الطويل.
الحدود وأفضل الممارسات
- القياس قبل التفعيل: احتفظ بلقطة للأحجام ولمعدل الفهرسة.
- توقع استهلاك المعالج: راقب زمن استجابة الفهرسة بعد التبديل، فهو المفاضلة التي تذكرها Elastic.
- لا تستبدل قالبًا: أعد قراءته قبل طلب PUT.
- التكاملات: استخدم قالب مكوّن
@customلكل مجموعة بيانات، كما تصف الوثائق. - الترتيب الافتراضي: اختبره على استعلاماتك، فالترتيب الأمثل يتوقف على حقولك.
ماذا يتغير بالنسبة لفريق SRE
في span.observer نلاحظ أن تكلفة تخزين السجلات كثيرًا ما تدفع إلى تقصير مدة الاحتفاظ، وبالتالي إلى فقدان السياق أثناء حادثة تشغيلية. وتقليل البصمة دون المساس بالاستعلامات يحفظ نافذة التحقيق هذه، ويمكن اختبار نمط الفهرس على تدفق واحد قبل تعميمه.
يخص هذا الإعداد تخزين Elasticsearch وليس الجمع. وإذا كانت سجلاتك تمر عبر Collector فلا يتغير تنسيق OpenTelemetry: راجع دليلنا عن Collector الخاص بـ OpenTelemetry على Kubernetes. ولوضع الموضوع في سياقه، أعد قراءة قابلية الملاحظة والمراقبة، ثم مقارنة Dynatrace وDatadog أو الدليل عن إدخال السجلات في Dynatrace. ولا نزعم وجود أي تكامل محدد بين logsdb وDynatrace.
الأسئلة الشائعة
هل يجب إعادة الفهرسة لاستخدام logsdb؟
لا بالنسبة للبيانات الجديدة: تذكر الوثائق أن تعديل القالب يسري عند rollover التالية. وتحتفظ الفهارس الموجودة بنمطها، لذا لا يوفّر السجل التاريخي مساحة دون إعادة فهرسة.
هل logsdb مفعّل افتراضيًا؟
بحسب الوثائق، هو تلقائي على تدفقات logs-*-* الجديدة في المنظومة 9.0 وما بعدها، وعلى Serverless للتدفقات الجديدة والموجودة. أما التدفقات الموجودة في منظومة تمت ترقيتها من 8.x فلا تتحول من تلقاء نفسها.
ما وفر التخزين المتوقع؟
تعلن Elastic عن ما يصل إلى 60% في الوثائق وما يصل إلى 65% في تدوينة، بحسب اختباراتها المرجعية. وتتوقف هذه القيم على البيانات والإصدار: قِس قبل التفعيل وبعده على فهارسك.
الخلاصة
يتلخص تفعيل logsdb في إعداد قالب واحد وعملية rollover. قِس الحجم قبل ذلك، وتحقق من index_mode بعده، وقارن فهارس متكافئة، وراقب استهلاك المعالج أثناء الفهرسة.
المصادر
- Logs data stream، وثائق Elastic
- Elasticsearch logsdb index mode، Elastic Search Labs
- Index modules، وثائق Elastic
- Get data streams، مرجع واجهة Elasticsearch
- Roll over to a new index، مرجع واجهة Elasticsearch
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC ولا لشركة Elastic N.V.. Dynatrace علامة تجارية لشركة Dynatrace LLC. أسماء المنتجات ملك لأصحابها؛ وأسماء التدفقات افتراضية، وأرقام الوفر هي ما أعلنته الجهة المصنِّعة. تحقق دائمًا من القيم (المنافذ والإصدارات والأحجام) في الوثائق الرسمية الخاصة بإصدارك.