El modo de índice logsdb Elasticsearch sirve para almacenar logs de forma más compacta, sin cambiar la manera de consultarlos. Buena noticia para un equipo SRE: se activa en una plantilla de índice y se aplica en el siguiente rollover. No hace falta reindexar para los datos nuevos.
Este tutorial muestra cómo medir el almacenamiento actual, activar logsdb, forzar el cambio y comprobar el resultado. Toda la información procede de la documentación de Elastic, citada al final del artículo. Las cifras de ganancia son las de Elastic, no mediciones de span.observer.
En breve
- logsdb es un valor del ajuste
index.mode, igual questandard,time_seriesolookup. - Según la documentación, se aplica automáticamente a los nuevos flujos
logs-*-*a partir de la pila 9.0. Los flujos existentes no cambian por sí solos. - La modificación de una plantilla surte efecto en el siguiente rollover: los índices antiguos conservan su modo.
- Elastic anuncia ganancias «de hasta» un 60 a un 65 % según la página. Mide antes y después con tus propios logs.
El problema: logs que cuesta mucho conservar
Los logs suelen ser el mayor volumen de una plataforma de observabilidad. Cada día de retención añade disco, snapshots y tiempo de restauración. Reducir ese volumen mejora directamente el coste por día conservado, un punto que los equipos de plataforma vigilan de cerca.
El objetivo aquí es sencillo: activar logsdb en un flujo existente, comprobar que se tiene en cuenta y comparar después el tamaño de los índices antes y después.
Qué hace logsdb Elasticsearch
Según la entrada de Search Labs de Elastic, logsdb combina tres técnicas:
- una ordenación de índice inteligente, que agrupa datos parecidos para comprimirlos mejor;
- códecs de compresión avanzados (Zstandard, delta, run-length), elegidos automáticamente;
- el
_sourcesintético, que elimina el campo_sourcealmacenado y lo reconstruye bajo demanda.
La misma entrada indica la ordenación por defecto (host.name y después @timestamp) y señala que otro orden puede convenir mejor a tus datos. También indica que logsdb consume más CPU en la indexación. La página de documentación habla de un impacto de aproximadamente un 10 a un 20 % en el rendimiento de indexación en sus pruebas.
En cuanto a la licencia, la entrada indica que la ordenación y la compresión pertenecen a los niveles Standard, Gold o Platinum, mientras que el _source sintético requiere Enterprise o Serverless. Comprueba tu suscripción antes de planificar.
Requisitos previos y versiones
- Un clúster Elasticsearch autogestionado, Elastic Cloud Hosted o Serverless. La entrada indica disponibilidad general a partir de la versión 8.17.
- Un flujo de datos (data stream) de logs, por ejemplo
logs-mesapp-prod(nombre ficticio). - Permiso para modificar las plantillas de índice y llamar a la API de rollover.
Punto a corregir. Algunos anuncios mencionan logsdb por defecto en logs-* desde la 9.2. La página oficial consultada no cita esa versión: indica «9.0 y posteriores» para los nuevos flujos. Por eso nos quedamos con la formulación de la documentación.
Activar logsdb sin reindexar: paso a paso
Paso 1: medir el tamaño antes
Anota el tamaño de los índices de respaldo del flujo. La consola de Kibana permite listar las columnas útiles de la API cat (las columnas docs.count y pri.store.size existen en la referencia de la API):
GET _cat/indices/.ds-logs-mesapp-*?h=index,docs.count,pri.store.size&s=indexCompara índices del mismo periodo y de volumen parecido; de lo contrario, la medición no significa nada.
Paso 2: poner index.mode en la plantilla
La documentación indica definir index.mode como logsdb en la plantilla de índice, o en la plantilla de componente @custom para los flujos de integraciones. Este es el ejemplo oficial:
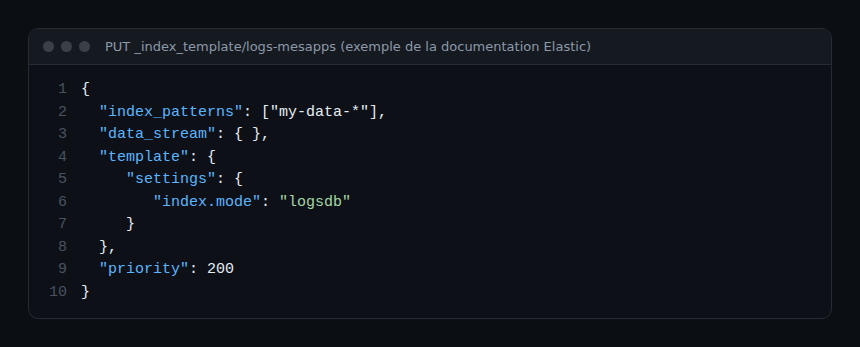
{
  "index_patterns": ["my-data-*"],
  "data_stream": { },
  "template": {
     "settings": {
        "index.mode": "logsdb"
     }
  },
  "priority": 200
}
Atención: la página advierte de que una petición PUT sobrescribe la plantilla existente. Recupera primero la configuración actual y reutiliza sus ajustes. En Kibana, el mismo ajuste se encuentra en Index Management, Index Templates, paso Logistics, campo Index mode.
Paso 3: forzar el rollover
El cambio se aplica en el siguiente rollover. Puedes esperar a la regla ILM o forzar el cambio:
POST logs-mesapp-prod/_rolloverLa referencia de la API de rollover indica que, para un flujo de datos, el rollover crea un nuevo índice de escritura y que el parámetro new_index no es compatible.
Paso 4: comprobar
Lee el flujo con la API de flujos de datos. Según su referencia, la respuesta contiene index_mode a nivel de flujo (modo de los futuros índices de respaldo) y para cada índice de respaldo:
GET _data_stream/logs-mesapp-prod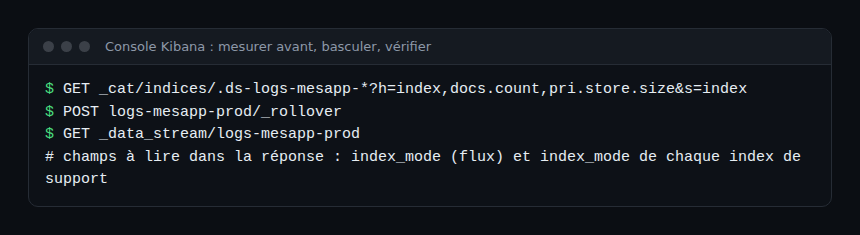
Cómo comprobar que funciona
- El flujo anuncia
logsdbenindex_mode. - El nuevo índice de respaldo (generado tras el rollover) también muestra
logsdb; los antiguos conservan el modo anterior. - Tras unas horas de ingesta normal, compara
pri.store.sizeen relación con el número de documentos (docs.count) entre un índice antiguo y uno reciente. - Vuelve a ejecutar tus consultas habituales de dashboards y alertas: los resultados deben seguir siendo idénticos.
Los datos antiguos no se reducen: solo los datos escritos después del rollover aprovechan el modo. Para convertir el historial habría que reindexar, algo que este tutorial evita deliberadamente.
Ganancias anunciadas: léelas con prudencia
La página de documentación sobre los flujos de logs indica, en sus benchmarks, una reducción del almacenamiento de hasta un 60 %, con resultados variables según el conjunto de datos y la versión. La entrada de Search Labs cita hasta un 65 % frente a versiones recientes sin logsdb, de las cuales hasta un 30 % por la ordenación y un 20 a un 40 % adicional por el _source sintético. No describe los conjuntos de datos probados. Estas cifras son techos facilitados por el proveedor: solo cuenta tu propia medición.
Otra entrada de Elastic, sobre el almacenamiento de logs a escala de petabytes con ILM, trata la arquitectura hot-frozen. No menciona logsdb y sus costes son un modelo ilustrativo del proveedor. No recogemos sus cifras. Ofrece, en cambio, una política ILM de un día en hot y después frozen, útil para combinar logsdb y retención larga.
Límites y buenas prácticas
- Medir antes de activar: guarda una instantánea de los tamaños y del caudal de indexación.
- Prever la CPU: vigila la latencia de indexación tras el cambio, es el compromiso que cita Elastic.
- No sobrescribir una plantilla: relee la plantilla antes del PUT.
- Integraciones: usa una plantilla de componente
@custompor conjunto de datos, como describe la documentación. - Ordenación por defecto: pruébala con tus consultas, el orden ideal depende de tus campos.
Qué cambia para un equipo SRE
En span.observer vemos que el coste del almacenamiento de logs empuja a menudo a acortar la retención y, por tanto, a perder contexto durante un incidente. Reducir la huella sin tocar las consultas preserva esa ventana de investigación, y un modo de índice se prueba en un solo flujo antes de generalizarlo.
Este ajuste afecta al almacenamiento de Elasticsearch, no a la recopilación. Si tus logs pasan por un Collector, el formato OpenTelemetry no cambia: consulta nuestra guía sobre el Collector de OpenTelemetry en Kubernetes. Para situar el tema, relee observabilidad y monitorización, y después la comparativa Dynatrace y Datadog o la guía sobre la ingesta de logs en Dynatrace. No afirmamos ninguna integración concreta entre logsdb y Dynatrace.
Preguntas frecuentes
¿Hay que reindexar para usar logsdb?
No para los datos nuevos: la documentación indica que la modificación de la plantilla surte efecto en el siguiente rollover. Los índices existentes conservan su modo, así que el historial no gana espacio sin reindexar.
¿Está logsdb activado por defecto?
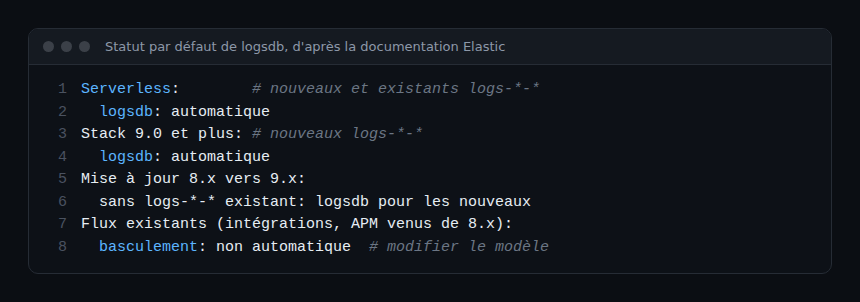
Según la documentación, es automático en los nuevos flujos logs-*-* de la pila 9.0 y posteriores, y en Serverless para los flujos nuevos y existentes. Los flujos existentes de una pila actualizada desde la 8.x no cambian por sí solos.
¿Qué ganancia de almacenamiento cabe esperar?
Elastic anuncia hasta un 60 % en la documentación y hasta un 65 % en una entrada, según sus benchmarks. Estos valores dependen de los datos y de la versión: mide antes y después en tus índices.
Conclusión
Activar logsdb se reduce a un ajuste de plantilla y un rollover. Mide el tamaño antes, comprueba index_mode después, compara índices equivalentes y vigila la CPU de indexación.
Fuentes
- Logs data stream, documentación de Elastic
- Elasticsearch logsdb index mode, Elastic Search Labs
- Index modules, documentación de Elastic
- Get data streams, referencia de la API de Elasticsearch
- Roll over to a new index, referencia de la API de Elasticsearch
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Elastic N.V. Dynatrace es una marca de Dynatrace LLC. Los nombres de productos pertenecen a sus propietarios; los nombres de flujos son ficticios y las cifras de ganancia son las anunciadas por el proveedor. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.