Módulo 2 del curso de métricas de Dynatrace Managed, dedicado a los hosts de infraestructura: 20 métricas builtin:host.* elegidas para operaciones, con su clave exacta, su unidad, sus agregaciones y una consulta de metric selector lista para copiar.
Curso: Formación en métricas de Dynatrace Managed · Módulo 2/7 · Dominio: hosts e infraestructura · Plataforma: Dynatrace Managed (Metrics API v2, metric selector)
Un host saturado arrastra todo lo que soporta: procesos, servicios y, después, la experiencia de los usuarios. Las métricas de host son, por tanto, el primer escalón de cualquier diagnóstico. La lista de métricas builtin de Dynatrace Managed cuenta con cientos; una veintena basta para cubrir la CPU, la memoria, el disco, la red y la disponibilidad.
Este módulo aplica a los hosts la cuadrícula de lectura del módulo 1 (entender las métricas). Cada ficha da la clave, lo que mide, un uso y una trampa; tenla a mano durante un diagnóstico.
Todo lo que sigue vale para Dynatrace Managed y para las métricas clásicas de Dynatrace SaaS. En Grail, los equivalentes llevan claves dt.host.* y se consultan con DQL: es el tema del curso de métricas de SaaS.
Hosts de infraestructura: la tabla resumen
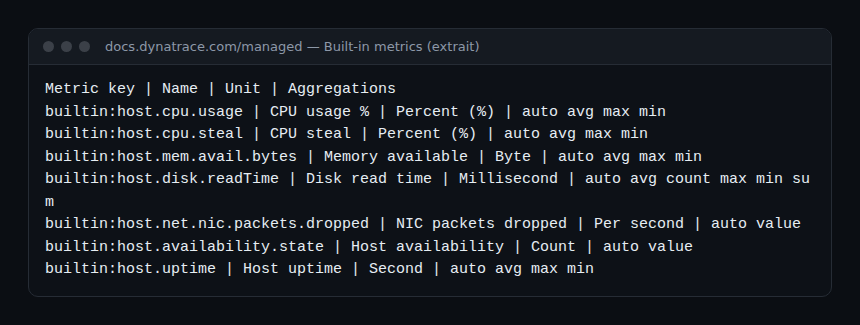
Las claves, unidades y agregaciones proceden de la página Built-in metrics de la documentación de Managed. Todas tienen la dimensión dt.entity.host; las métricas de disco añaden dt.entity.disk y las de interfaz de red, una dimensión de interfaz.
| Clave | Unidad | Agregaciones | Qué mide |
|---|---|---|---|
builtin:host.cpu.usage |
% | avg, max, min | CPU utilizada |
builtin:host.cpu.user |
% | avg, max, min | CPU en modo usuario |
builtin:host.cpu.system |
% | avg, max, min | CPU en modo kernel |
builtin:host.cpu.iowait |
% | avg, max, min | Espera de entrada/salida |
builtin:host.cpu.steal |
% | avg, max, min | CPU robada por el hipervisor |
builtin:host.cpu.load |
Ratio | avg, max, min | Carga del sistema a 1 minuto |
builtin:host.mem.usage |
% | avg, max, min | Memoria utilizada |
builtin:host.mem.avail.bytes |
Byte | avg, max, min | Memoria disponible |
builtin:host.mem.swap.used |
Byte | avg, max, min | Swap utilizado |
builtin:host.mem.avail.pfps |
Por segundo | avg, max, min | Fallos de página |
builtin:host.disk.usedPct |
% | avg, max, min | Espacio de disco utilizado |
builtin:host.disk.avail |
Byte | avg, max, min | Espacio de disco disponible |
builtin:host.disk.inodesAvail |
% | avg, max, min | Inodos libres |
builtin:host.disk.queueLength |
Count | avg, max, min | Cola de disco |
builtin:host.disk.readTime |
Milisegundo | avg, count, max, min, sum | Latencia de lectura |
builtin:host.disk.writeTime |
Milisegundo | avg, count, max, min, sum | Latencia de escritura |
builtin:host.net.nic.trafficIn |
bit/s | avg, max, min | Tráfico entrante |
builtin:host.net.nic.packets.dropped |
Por segundo | value | Paquetes descartados |
builtin:host.availability.state |
Count | value | Estado de disponibilidad |
builtin:host.uptime |
Segundo | avg, max, min | Tiempo desde el arranque |
Las métricas de host builtin de la CPU
builtin:host.cpu.usage
El porcentaje de tiempo de CPU utilizado, con todos los núcleos juntos. Es la métrica de saturación más mirada. Usa max en lugar de la media por defecto para ver los picos: una media sobre el intervalo oculta fácilmente una saturación corta. Cruza siempre con cpu.load antes de concluir.
builtin:host.cpu.usage:splitBy("dt.entity.host"):max:sort(value(max,descending)):limit(10)builtin:host.cpu.user
La parte de la CPU dedicada al modo usuario, es decir, al código de las aplicaciones. Si cpu.usage sube y cpu.user aporta la mayor parte, busca en los procesos de aplicación (módulo 5 del curso).
builtin:host.cpu.user:splitBy("dt.entity.host"):avgbuiltin:host.cpu.system
La parte en modo kernel. Un valor alto y duradero sugiere muchas llamadas al sistema, cambios de contexto o interrupciones de red. Es una señal que se compara con el histórico del host, no con un umbral absoluto.
builtin:host.cpu.system:splitBy("dt.entity.host"):maxbuiltin:host.cpu.iowait
El tiempo en que la CPU estaba inactiva mientras quedaba una entrada/salida pendiente. La documentación precisa que la métrica no existe en Windows. Un iowait que sube a la vez que la latencia de disco apunta al almacenamiento, no a la CPU.
builtin:host.cpu.iowait:splitBy("dt.entity.host"):maxbuiltin:host.cpu.steal
El tiempo durante el que una máquina virtual espera ciclos que el hipervisor da a otras VM; la documentación lo indica para los hosts Linux. Una aplicación lenta en un host con CPU moderada pero steal alto es asunto del equipo de virtualización, no del equipo de aplicaciones.
builtin:host.cpu.steal:splitBy("dt.entity.host"):avg:sort(value(avg,descending))builtin:host.cpu.load
El número medio de procesos en ejecución o esperando CPU durante el último minuto (load5m y load15m también existen). La unidad es un ratio: compáralo con el número de núcleos del host. Una carga superior al número de núcleos significa cola de espera.
builtin:host.cpu.load:splitBy("dt.entity.host"):maxMemoria
builtin:host.mem.usage
El porcentaje de memoria utilizada, calculado por OneAgent como total menos disponible. Trampa conocida: el valor no se corresponde con el «used» de free ni del Administrador de tareas, porque la caché recuperable se cuenta como disponible. No compares las dos cifras en plena crisis.
builtin:host.mem.usage:splitBy("dt.entity.host"):maxbuiltin:host.mem.avail.bytes
La memoria disponible en bytes, estimada sin recurrir al swap. A menudo es mejor indicador de alerta que el porcentaje: en un servidor grande, un 5 % libre sigue siendo varios gigabytes.
builtin:host.mem.avail.bytes:splitBy("dt.entity.host"):min:sort(value(min,ascending)):limit(10)builtin:host.mem.swap.used
El espacio de swap utilizado, en bytes. Un swap estable no preocupa; un swap que aumenta a la vez que baja la memoria disponible anuncia presión de memoria y tiempos de respuesta degradados.
builtin:host.mem.swap.used:splitBy("dt.entity.host"):maxbuiltin:host.mem.avail.pfps
Los fallos de página por segundo, fallos leves y graves juntos según la documentación. Sola, la cifra se interpreta mal; una ruptura clara respecto a la semana anterior, combinada con swap, confirma falta de memoria.
builtin:host.mem.avail.pfps:splitBy("dt.entity.host"):avgDisco
builtin:host.disk.usedPct
El porcentaje de espacio utilizado por sistema de archivos. Es la métrica de las alertas de «disco lleno». Piensa en la tendencia: una partición al 80 % que gana 2 puntos al día es más urgente que una partición estable al 90 %.
builtin:host.disk.usedPct:splitBy("dt.entity.host","dt.entity.disk"):max:sort(value(max,descending)):limit(20)builtin:host.disk.avail
El espacio libre en bytes. En Linux y AIX, la documentación precisa que es el espacio disponible para un usuario sin privilegios, sin la reserva de root: el valor puede ser por tanto más bajo que el de df como root.
builtin:host.disk.avail:splitBy("dt.entity.host","dt.entity.disk"):minbuiltin:host.disk.inodesAvail
El porcentaje de inodos libres, ausente en Windows. Un disco puede rechazar toda escritura aunque quede espacio: es el caso típico de los directorios llenos de archivos pequeños (sesiones, colas, logs rotativos).
builtin:host.disk.inodesAvail:splitBy("dt.entity.host","dt.entity.disk"):minbuiltin:host.disk.queueLength
El número medio de operaciones de lectura y escritura en cola. Una cola que se mantiene alta señala un disco que ya no absorbe la demanda; léela junto con los tiempos de lectura y escritura que siguen.
builtin:host.disk.queueLength:splitBy("dt.entity.host","dt.entity.disk"):maxbuiltin:host.disk.readTime
El tiempo medio de una lectura en el sistema de archivos, en milisegundos: la latencia de disco vista por el host. A menudo explica una base de datos lenta sin que la CPU se mueva.
builtin:host.disk.readTime:splitBy("dt.entity.host","dt.entity.disk"):avgbuiltin:host.disk.writeTime
La contrapartida en escritura, en milisegundos. Los logs de transacciones y las colas de mensajes son muy sensibles a ella. Compara el valor antes y después de una migración de almacenamiento para objetivar el cambio.
builtin:host.disk.writeTime:splitBy("dt.entity.host","dt.entity.disk"):maxRed, disponibilidad y sistema operativo
builtin:host.net.nic.trafficIn
El tráfico entrante por interfaz, en bits por segundo; builtin:host.net.nic.trafficOut da el saliente. Cuidado con la unidad: divide entre 8 para compararlo con un caudal en bytes. Relaciona el valor con la capacidad de la interfaz.
builtin:host.net.nic.trafficIn:splitBy("dt.entity.host"):max:sort(value(max,descending)):limit(10)builtin:host.net.nic.packets.dropped
Los paquetes descartados por segundo en las interfaces; las variantes droppedRx y droppedTx separan recepción y emisión. Todo valor no nulo de forma sostenida merece una mirada, sobre todo si aumentan las retransmisiones de los servicios.
builtin:host.net.nic.packets.dropped:splitBy("dt.entity.host")builtin:host.availability.state
El estado de disponibilidad del host, informado cada minuto. Sirve para medir una disponibilidad de infraestructura o para comprobar que un host no ha desaparecido durante una ventana dada. Antes de filtrar por un estado, lee las dimensiones exactas en el descriptor de tu entorno.
builtin:host.availability.state:splitBy("dt.entity.host")builtin:host.uptime
El tiempo transcurrido desde el último arranque, en segundos. La documentación indica que requiere OneAgent 1.259 o superior y que no existe en modo application-only. Práctica para detectar un reinicio imprevisto justo antes de un incidente.
builtin:host.uptime:splitBy("dt.entity.host"):min:sort(value(min,ascending)):limit(10)Cómo comprobar que funciona
- Lista las claves realmente presentes en tu entorno:
curl -s "$DT_URL/api/v2/metrics?metricSelector=builtin:host.*&fields=unit,aggregationTypes" \ -H "Authorization: Api-Token $DT_TOKEN" - Lee el descriptor de una clave (
GET /api/v2/metrics/builtin:host.disk.avail): unidad, agregaciones y dimensiones deben corresponder a la tabla. - Pega una consulta de este módulo en el Data Explorer, en modo código. Un error de sintaxis se muestra de inmediato; una serie vacía indica un host no monitorizado o una métrica no disponible en ese sistema operativo.
El token debe llevar el scope metrics.read. La sintaxis completa del metric selector se detalla en el módulo de metric selector y API.
Buenas prácticas
- Indica siempre la agregación: sin ella, la media por defecto suaviza los picos.
- Alerta sobre los bytes disponibles en lugar de un porcentaje en los volúmenes grandes.
- Lee juntos CPU, iowait y latencia de disco antes de señalar a un culpable.
- Mantén umbrales propios de tu parque: la documentación no fija ningún valor «normal».
Preguntas frecuentes
¿Por qué no se citan todas las métricas builtin:host.*?
La lista oficial cuenta varias decenas, incluidas métricas muy específicas de z/OS o AIX. Este módulo conserva las que sirven en la mayoría de los diagnósticos; la página Built-in metrics sigue siendo la referencia exhaustiva.
¿Hay que aprenderse de memoria las veinte claves?
No. Quédate con la lógica (CPU, memoria, disco, red, disponibilidad) y vuelve a la tabla resumen cuando construyas un dashboard o una alerta.
¿Funcionan estas claves en Dynatrace SaaS?
Sí, como métricas clásicas mediante la API v2. En Grail, usa las claves dt.host.* y el comando DQL timeseries, descritos en el curso de métricas de SaaS.
Estas veinte fichas cubren la base de un diagnóstico de host. El módulo siguiente sube un escalón: los servicios, sus peticiones y sus errores. Para profundizar en la infraestructura, consulta también la arquitectura de Dynatrace Managed.
← Módulo 1: entender las métricas · Índice del curso · Módulo 3: servicios →
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Las claves y unidades citadas proceden de la documentación oficial de Dynatrace Managed; compruébalas en la versión de tu clúster.