
Esta noche el equipo de plataforma va a drenar el nodo node-07 para actualizar el kernel. Una pregunta decide si hay luz verde: ¿qué servicios pierden réplicas y a quién hay que avisar? El grafo de la topología de Kubernetes en Dynatrace SaaS lo responde con una sola consulta DQL, siempre que sepas recorrerlo. Partimos de cuatro decisiones de operación y de ellas sacamos las consultas.
La sintaxis procede de la documentación de Dynatrace. Las ideas de casos de uso se inspiran en la entrada del fabricante sobre este tema. Las consultas de abajo están reescritas y no se han ejecutado en ningún tenant para este artículo: pruébalas primero en un ámbito pequeño antes de fiarte de ellas. Todo vale solo para Dynatrace SaaS.
La sintaxis general de smartscapeNodes y traverse se explica en el artículo sobre DQL y Smartscape. Aquí no repasamos los comandos: los usamos.
Por qué consultar la topología de Kubernetes y no solo kubectl
Con kubectl cada respuesta es una foto fija de un único clúster. Para saber qué servicios dependen de un nodo encadenas tres comandos y cruzas los datos a mano. Con diez clústeres, el ejercicio se vuelve un castigo.
El grafo guarda los objetos como nodos (K8S_NODE, K8S_POD, K8S_SERVICE, K8S_NAMESPACE, K8S_DEPLOYMENT, K8S_SECRET) y sus relaciones como aristas: runs_on une un pod con su nodo, routes_to un servicio con sus pods, belongs_to un objeto con su namespace, is_part_of un pod con su controlador y uses un pod con un Secret. Una sola consulta abarca así todos los clústeres conectados al entorno.
Tres piezas de sintaxis que conviene recordar
smartscapeNodes "*"abre la consulta. El tipo se escribe sin comillas (HOST), entre llaves si son varios, y entre comillas si es un patrón. La documentación indica que un patrón admite como máximo 64 comodines.traverse arista, tipo_destinosigue una relación. El sentido por defecto esforward. Condirection: backwardse sube contra la flecha de la arista, por ejemplo del nodo a sus pods.fieldsKeepconserva campos del nodo de partida en el arraydt.traverse.history. Cadatraverseañade un registro, ydt.traverse.history[0][name]recupera el nombre del primer nivel.
Decisión 1: drenar un nodo sin sorpresas
Antes de un drenaje quieres la lista de servicios afectados, ordenada por pods perdidos. Se parte del nodo, se baja a sus pods y de ahí a los servicios que les enrutan tráfico.
smartscapeNodes "*"
| filter type == "K8S_NODE" and name == "node-07"
| traverse runs_on, K8S_POD, direction: backward,
    fieldsKeep: {name, `k8s.namespace.name`, `k8s.cluster.name`}
| traverse routes_to, K8S_SERVICE, direction: backward,
    fieldsKeep: {name}
| fieldsAdd pod = dt.traverse.history[1][name]
| summarize pods_perdus = countDistinctExact(pod),
    by: {service = name,
         namespace = `k8s.namespace.name`,
         cluster = `k8s.cluster.name`}
| sort pods_perdus desc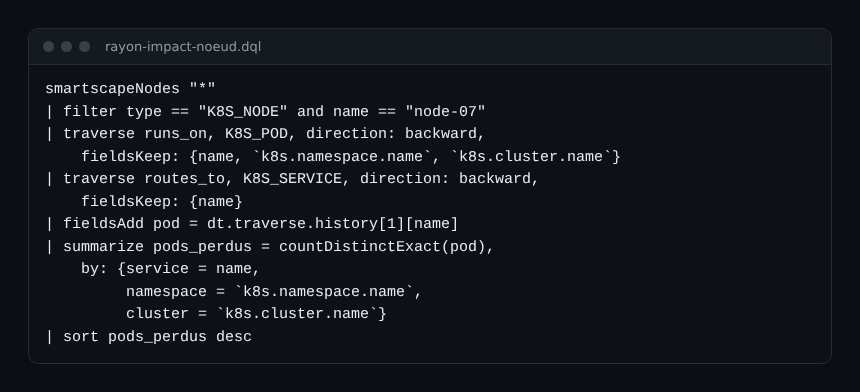
Lee el resultado con método. Un servicio que pierde un pod de doce no te preocupa. Uno que pierde dos de dos justifica aplazar el drenaje. Un resultado vacío puede indicar también que el nombre del nodo es incorrecto: compruébalo antes con smartscapeNodes "*" | filter type == "K8S_NODE".
Decisión 2: a quién avisar y dónde buscar
La topología no adivina quién es responsable de qué. Lee las etiquetas que tus equipos ponen en los namespaces. Si el namespace lleva una etiqueta owner, la consulta la muestra junto al clúster:
smartscapeNodes "*"
| filter type == "K8S_NAMESPACE"
| fields namespace = name, cluster = `k8s.cluster.name`, owner = tags[owner]
| sort cluster asc, namespace asc
Cada fila sin owner es un hueco de gobierno, no un fallo de la consulta. Corrígelo en origen, por ejemplo con el enriquecimiento que describe el artículo sobre metadata enrichment en Kubernetes. Después cruza esta lista con el resultado de la decisión 1 y sabrás a quién llamar.
Decisión 3: rotar un Secret sin romper producción
Cambiar un Secret suele obligar a reiniciar los pods que lo montan. La pregunta es, pues, cuántos pods y servicios dependen de él. Se parte de los Secrets y se sube por la relación uses.
smartscapeNodes "*"
| filter type == "K8S_SECRET"
| traverse uses, K8S_POD, direction: backward,
    fieldsKeep: {name, `k8s.cluster.name`}
| fieldsAdd pod = name
| traverse routes_to, K8S_SERVICE, direction: backward, fieldsKeep: {name}
| fieldsAdd service = dt.traverse.history[1][name]
| summarize pods = countDistinctExact(pod),
    services = countDistinctExact(service),
    by: {secret = dt.traverse.history[0][name], cluster = `k8s.cluster.name`}
| sort pods desc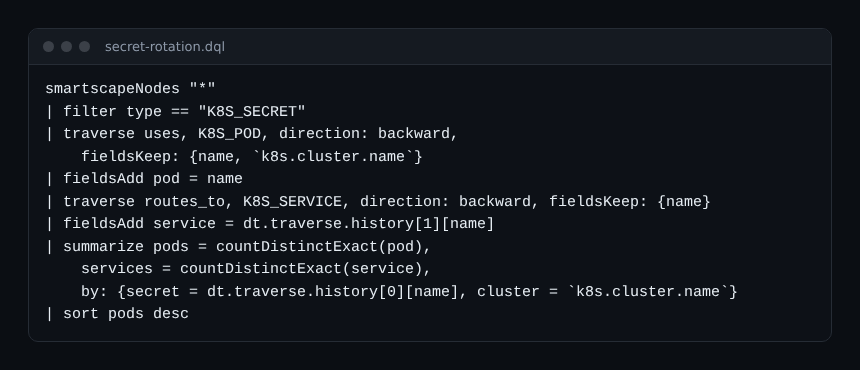
Un Secret montado por cuarenta pods se rota en varias oleadas. Uno montado por dos pods cabe en la ventana de mantenimiento de siempre. La cifra sirve para abrir la conversación con los equipos afectados; no sustituye su criterio.
Decisión 4: detectar riesgos antes del incidente
Dos consultas semanales equivalen a un ritual. La primera lista los deployments con un único pod, es decir, sin red de seguridad durante un drenaje:
smartscapeNodes "*"
| filter type == "K8S_DEPLOYMENT"
| traverse is_part_of, K8S_POD, direction: backward,
    fieldsKeep: {name, `k8s.namespace.name`, `k8s.cluster.name`}
| summarize pods = count(),
    by: {deployment = dt.traverse.history[0][name],
         namespace = `k8s.namespace.name`, cluster = `k8s.cluster.name`}
| filter pods == 1
Un límite que debes conocer: un deployment con cero pods no aparece, porque no tiene ningún pod que contar. La segunda consulta busca los pods desaparecidos durante el último día, gracias al campo lifetime:
smartscapeNodes "*"
| filter type == "K8S_POD"
| fieldsAdd fin = lifetime[end]
| filter fin < now() - 5m and fin > now() - 1d
| fields pod = name, cluster = `k8s.cluster.name`, namespace = `k8s.namespace.name`, fin
| sort fin desc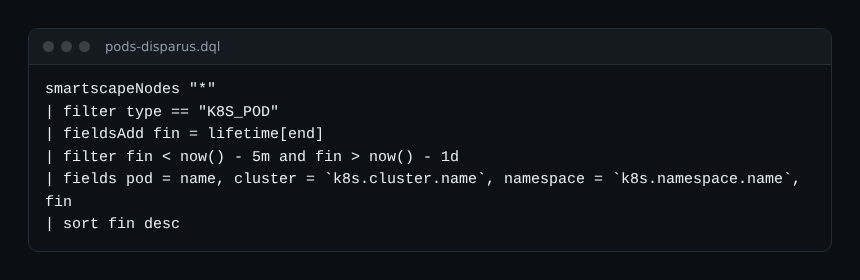
Los umbrales de cinco minutos y un día son una elección: ajústalos a tu ritmo de despliegue. Un pod que desaparece fuera de una ventana de despliegue merece una pregunta. Para convertir estas listas en alertas en vez de lectura manual, mira las alertas de Kubernetes sobre nodos, pods y cuotas.
Buenas prácticas para la topología de Kubernetes en DQL
- Filtra pronto por
typey por clúster: untraversesobre todo el entorno sale más caro. - Pon nombre a tus campos con
fieldsAddjusto después de cadatraverse, para no confundir los índices dedt.traverse.history. - Guarda las consultas útiles en un Notebook o un Dashboard. Para localizar el identificador de una entidad, consulta el artículo sobre identificadores de entidad.
- Ejecuta cada consulta en un clúster de pruebas antes de automatizarla.
Preguntas frecuentes
¿Hay que activar algo para consultar la topología de Kubernetes?
Hace falta que la monitorización de Kubernetes alimente el entorno SaaS y que tu rol dé acceso a la tabla de Grail smartscape, que según la documentación exige el permiso storage:smartscape:read. Aquí no he verificado el procedimiento completo de activación.
¿Qué diferencia hay entre smartscapeNodes y smartscapeEdges?
smartscapeNodes devuelve objetos y smartscapeEdges devuelve relaciones. Usa las aristas para inventariar los tipos de relación disponibles y traverse para seguirlas de un objeto a otro.
¿Funcionan estas consultas en Dynatrace Managed?
Este artículo cubre solo Dynatrace SaaS. No he verificado si estos comandos existen en Managed: no los traslades sin probarlos.
Conclusión
Un grafo solo sirve si responde a una decisión. Drenar un nodo, rotar un Secret, localizar un punto único de fallo: cada consulta de arriba sustituye un cruce manual de datos. Para completarlas con tendencias numéricas, repasa los comandos DQL filter, summarize y timeseries. La referencia oficial de la sintaxis es la página de comandos de Smartscape.
Blog independiente, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC.