



Mettre vLLM en production, c’est passer d’un LLM qui « marche sur ma machine » à un service d’inférence capable d’absorber des centaines de requêtes simultanées sur des GPU de datacenter. Né dans un laboratoire de l’université de Berkeley et aujourd’hui hébergé par la PyTorch Foundation, vLLM est l’un des projets open source les plus suivis sur GitHub pour le service de modèles de langage. Ce guide couvre les trois piliers d’un vLLM production fiable : le serveur compatible OpenAI, les métriques Prometheus et la supervision des GPU.
Sa force tient à deux idées : PagedAttention, qui gère la mémoire du cache clé-valeur (KV cache) par pages comme un système d’exploitation gère la mémoire virtuelle, et le batching continu, qui insère les nouvelles requêtes dans le lot en cours au lieu d’attendre qu’il se termine. Résultat : un bien meilleur taux d’occupation des GPU, qui coûtent cher.
Pour un SRE, vLLM a une autre qualité : il expose nativement un endpoint Prometheus riche et peut émettre des traces OpenTelemetry. Voyons comment l’installer, le lancer comme serveur compatible OpenAI, puis le superviser jusque dans Dynatrace.
vLLM production : pourquoi le choisir ?
vLLM répond à un besoin précis : servir des modèles ouverts (Llama, Mistral, Qwen, Gemma…) depuis Hugging Face avec un débit élevé. Il propose :
- un serveur HTTP compatible avec l’API OpenAI (
/v1/chat/completions,/v1/completions,/v1/models…), donc utilisable avec les SDK existants ; - le parallélisme de tenseurs et de pipeline pour répartir un grand modèle sur plusieurs GPU ;
- la prise en charge de nombreux formats quantifiés et de plusieurs familles de matériel (NVIDIA en premier lieu, mais aussi AMD et d’autres accélérateurs selon les versions).
Ses limites : il suppose un GPU sérieux, son temps de démarrage est long (chargement des poids, compilation, préallocation de la mémoire) et ses nombreux réglages demandent un peu d’expérience. Pour un poste de développeur, Ollama en local ou llama.cpp sont plus légers.
En pratique : déployer un serveur vLLM compatible OpenAI
Étape 1 — Installer vLLM
Sur une machine Linux avec un GPU NVIDIA et des pilotes CUDA récents, l’installation se fait par pip, de préférence dans un environnement virtuel :
python3 -m venv .venv && source .venv/bin/activate
pip install vllm
Les combinaisons de versions Python, CUDA et PyTorch prises en charge changent souvent : vérifiez-les dans le guide d’installation officiel de vLLM.
Étape 2 — Lancer le serveur
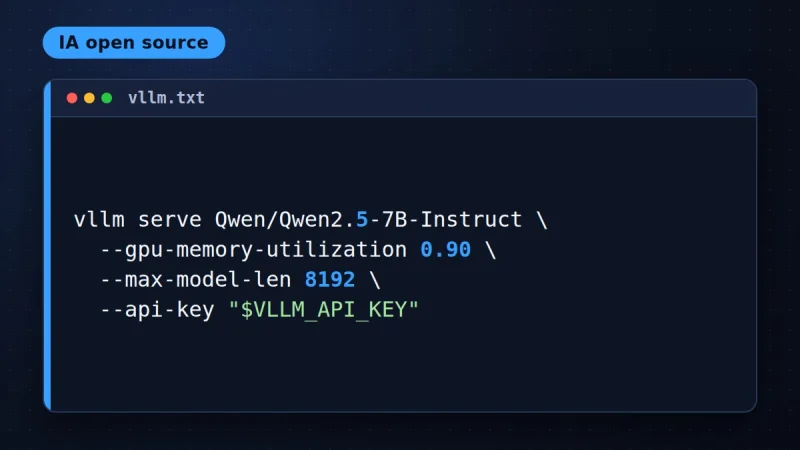
La commande vllm serve démarre le serveur compatible OpenAI, par défaut sur le port 8000. Pour un modèle soumis à conditions d’accès sur Hugging Face, exportez d’abord un jeton dans HF_TOKEN :
vllm serve Qwen/Qwen2.5-7B-Instruct \
  --gpu-memory-utilization 0.90 \
  --max-model-len 8192 \
  --api-key "$VLLM_API_KEY"
--gpu-memory-utilization fixe la fraction de mémoire GPU que vLLM s’autorise, --max-model-len limite la longueur de contexte (et donc la taille du KV cache), --tensor-parallel-size répartit le modèle sur plusieurs GPU. La liste complète des options s’obtient avec vllm serve --help.
Étape 3 — Ou utiliser l’image Docker
docker run --gpus all --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e HF_TOKEN="$HF_TOKEN" \
  vllm/vllm-openai:latest \
  --model Qwen/Qwen2.5-7B-Instruct
En production, remplacez latest par une version précise. Sur Kubernetes, la documentation propose des exemples de déploiement et des charts communautaires ; prévoyez une sonde de démarrage généreuse, car le chargement d’un gros modèle prend plusieurs minutes.
Étape 4 — Tester l’API
curl -s http://localhost:8000/v1/chat/completions \
  -H "Authorization: Bearer $VLLM_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "Qwen/Qwen2.5-7B-Instruct",
       "messages": [{"role": "user", "content": "Bonjour"}]}'
curl -s http://localhost:8000/health
Quelles métriques Prometheus surveiller sur vLLM ?
Le serveur publie ses métriques au format Prometheus sur /metrics, préfixées par vllm:. Les noms exacts ont évolué avec le passage au moteur « V1 » : contrôlez-les en interrogeant votre propre instance (curl localhost:8000/metrics) et la page « Metrics » de la documentation. Les familles à suivre :
- Charge : requêtes en cours d’exécution et en attente (
vllm:num_requests_running,vllm:num_requests_waiting). Une file d’attente qui grossit est le premier signe de saturation. - Mémoire : taux d’occupation du KV cache. Proche de 100 %, vLLM préempte des requêtes et la latence s’envole.
- Latence : histogrammes du temps jusqu’au premier token (TTFT), du temps entre tokens et de la latence de bout en bout.
- Volume : compteurs de tokens de prompt et de tokens générés, base du débit et du calcul de coût.
- Issue des requêtes : nombre de requêtes terminées par raison de fin (longueur maximale, arrêt normal, interruption).
Ces métriques applicatives se lisent avec celles du GPU : utilisation, mémoire, puissance et température, fournies par l’exportateur DCGM de NVIDIA (déployé par le GPU Operator sur Kubernetes) ou par un agent d’hôte.
Logs et traces OpenTelemetry
vLLM journalise sur la sortie standard le chargement du modèle, la mémoire allouée au KV cache et, périodiquement, un résumé du débit et de l’occupation du cache. Sur Kubernetes, ces logs sont collectés comme ceux de n’importe quel pod.
Côté traces, le serveur accepte une option --otlp-traces-endpoint qui envoie un span par requête vers un collecteur OTLP, avec des attributs inspirés des conventions sémantiques GenAI (modèle, tokens, temps en file d’attente, TTFT). Les paquets OpenTelemetry nécessaires doivent être installés séparément ; la documentation fournit un exemple complet. Si l’application appelante propage le contexte W3C, le span vLLM se rattache à la trace de bout en bout.
Faire remonter vLLM dans Dynatrace
Le chemin le plus simple passe par un Collector OpenTelemetry qui scrape /metrics, reçoit les traces OTLP et exporte le tout. Dynatrace attend des métriques OTLP en temporalité delta : le processeur cumulativetodelta convertit les compteurs Prometheus cumulatifs.
receivers:
  prometheus:
    config:
      scrape_configs:
        - job_name: vllm
          scrape_interval: 15s
          static_configs:
            - targets: ["vllm:8000"]
  otlp:
    protocols:
      grpc:
      http:
processors:
  cumulativetodelta:
  batch:
exporters:
  otlphttp:
    endpoint: https://<environnement>.live.dynatrace.com/api/v2/otlp
    headers:
      Authorization: "Api-Token ${env:DT_API_TOKEN}"
service:
  pipelines:
    metrics:
      receivers: [prometheus]
      processors: [cumulativetodelta, batch]
      exporters: [otlphttp]
    traces:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlphttp]
Le jeton doit porter les permissions d’ingestion des métriques et des traces. Sur Kubernetes, Dynatrace sait aussi scraper directement des endpoints Prometheus annotés ; consultez sa documentation pour choisir entre les deux approches. Une fois les données dans Grail, quelques tableaux suffisent : TTFT p95, requêtes en attente, occupation du KV cache, tokens par seconde et utilisation GPU par nœud. Les principes de SLO fondés sur des histogrammes, détaillés dans notre article sur les métriques histogrammes avec OpenPipeline, s’appliquent directement au TTFT.
Bonnes pratiques
- Épinglez la version de vLLM et l’identifiant du modèle ; testez chaque montée de version, les options et métriques changent.
- Protégez l’API par une clé et un filtrage réseau ; ne l’exposez pas directement sur Internet.
- Alertez sur la file d’attente et l’occupation du KV cache avant la latence : ce sont des indicateurs avancés.
- Dimensionnez
--max-model-lenselon l’usage réel plutôt que la capacité maximale du modèle. - Gardez les prompts hors des traces si elles contiennent des données sensibles.
Questions fréquentes
vLLM est-il vraiment compatible avec l’API OpenAI ?
Pour les endpoints principaux (chat, complétions, modèles, embeddings selon le modèle), oui : il suffit de changer l’URL de base du SDK. Certains paramètres avancés peuvent différer ; la documentation liste ceux qui sont pris en charge.
Où trouver les métriques Prometheus de vLLM ?
Sur le chemin /metrics du serveur, sur le même port que l’API. Les noms commencent par vllm:.
vLLM fonctionne-t-il sans GPU ?
Un mode CPU existe pour certaines plateformes, mais vLLM est conçu pour les accélérateurs. Sans GPU, llama.cpp ou Ollama sont plus adaptés.
Conclusion
vLLM apporte le débit nécessaire pour servir des LLM ouverts à grande échelle, et il a la bonne idée d’être observable dès l’installation. En reliant ses métriques Prometheus, ses traces OTLP et les métriques GPU dans un même backend, on pilote l’inférence comme n’importe quel service critique. Pour choisir entre vLLM et les autres briques, voyez notre comparatif des stacks IA open source auto-hébergées.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni aux projets cités. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans leur documentation officielle.
6 comments