تشغيل vLLM في الإنتاج يعني الانتقال من نموذج لغوي كبير (LLM) «يعمل على جهازي» إلى خدمة استدلال قادرة على استيعاب مئات الطلبات المتزامنة على وحدات GPU في مراكز البيانات. وُلد vLLM في مختبر بجامعة بيركلي وتستضيفه اليوم PyTorch Foundation، وهو من أكثر المشاريع المفتوحة المصدر متابعةً على GitHub في تقديم النماذج اللغوية. يغطي هذا الدليل الركائز الثلاث لتشغيل vLLM في الإنتاج بموثوقية: الخادم المتوافق مع OpenAI، ومقاييس Prometheus، ومراقبة وحدات GPU.
تقوم قوته على فكرتين: PagedAttention التي تدير ذاكرة التخزين المؤقت للمفاتيح والقيم (KV cache) على شكل صفحات كما يدير نظام التشغيل الذاكرة الافتراضية، والدفعات المستمرة (continuous batching) التي تُدخل الطلبات الجديدة في الدفعة الجارية بدل انتظار انتهائها. والنتيجة نسبة إشغال أفضل بكثير لوحدات GPU الباهظة الثمن.
وبالنسبة إلى مهندس SRE فلـ vLLM ميزة أخرى: يعرض أصلًا نقطة Prometheus غنية ويستطيع إصدار تتبعات OpenTelemetry. لنرَ كيف يُثبَّت ويُشغَّل كخادم متوافق مع OpenAI، ثم كيف يُراقَب وصولًا إلى Dynatrace.
vLLM في الإنتاج: لماذا تختاره؟
يلبّي vLLM حاجة محددة: تقديم نماذج مفتوحة (Llama وMistral وQwen وGemma…) من Hugging Face بمعدل معالجة مرتفع. وهو يقدّم:
- خادم HTTP متوافقًا مع واجهة OpenAI (
/v1/chat/completionsو/v1/completionsو/v1/models…)، فيعمل مع حزم SDK الموجودة؛ - التوازي على مستوى الموترات (tensor parallelism) وعلى مستوى خط المعالجة (pipeline parallelism) لتوزيع نموذج كبير على عدة وحدات GPU؛
- دعم صيغ مكمَّمة كثيرة وعدة عائلات من العتاد (NVIDIA أولًا، لكن AMD ومسرّعات أخرى بحسب الإصدارات).
أما حدوده: فهو يفترض وحدة GPU جادة، وزمن إقلاعه طويل (تحميل الأوزان والترجمة وحجز الذاكرة مسبقًا)، وإعداداته الكثيرة تتطلب شيئًا من الخبرة. ولجهاز المطور يكون Ollama محليًا أو llama.cpp أخف.
عمليًا: نشر خادم vLLM متوافق مع OpenAI
الخطوة 1: ثبّت vLLM
على جهاز Linux بوحدة GPU من NVIDIA ومشغّلات CUDA حديثة، يتم التثبيت عبر pip، ويفضَّل داخل بيئة افتراضية:
python3 -m venv .venv && source .venv/bin/activate
pip install vllm
تتغير كثيرًا تركيبات إصدارات Python وCUDA وPyTorch المدعومة، فتحقق منها في دليل التثبيت الرسمي لـ vLLM.
الخطوة 2: شغّل الخادم
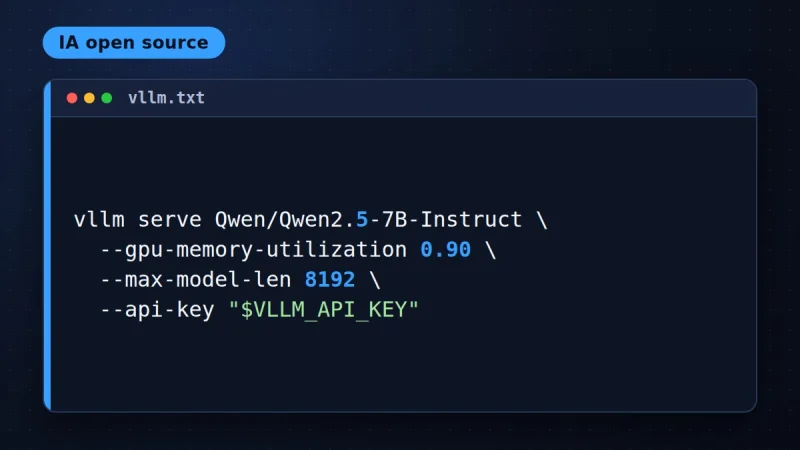
يبدأ الأمر vllm serve الخادم المتوافق مع OpenAI، افتراضيًا على المنفذ 8000. ولنموذج مشروط الوصول على Hugging Face، صدِّر أولًا رمزًا مميّزًا في HF_TOKEN:
vllm serve Qwen/Qwen2.5-7B-Instruct \
  --gpu-memory-utilization 0.90 \
  --max-model-len 8192 \
  --api-key "$VLLM_API_KEY"
يحدد --gpu-memory-utilization نسبة ذاكرة GPU التي يسمح vLLM لنفسه باستخدامها، ويحدّ --max-model-len طول السياق (ومن ثمّ حجم KV cache)، ويوزّع --tensor-parallel-size النموذج على عدة وحدات GPU. وتحصل على القائمة الكاملة للخيارات بالأمر vllm serve --help.
الخطوة 3: أو استخدم صورة Docker
docker run --gpus all --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e HF_TOKEN="$HF_TOKEN" \
  vllm/vllm-openai:latest \
  --model Qwen/Qwen2.5-7B-Instruct
في الإنتاج، استبدل latest بإصدار محدد. وعلى Kubernetes تقترح الوثائق أمثلة نشر ومخططات (charts) مجتمعية؛ فخصّص فحص إقلاع (startup probe) سخيًّا، لأن تحميل نموذج كبير يستغرق دقائق.
الخطوة 4: اختبر الواجهة
curl -s http://localhost:8000/v1/chat/completions \
  -H "Authorization: Bearer $VLLM_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "Qwen/Qwen2.5-7B-Instruct",
       "messages": [{"role": "user", "content": "Bonjour"}]}'
curl -s http://localhost:8000/health
أي مقاييس Prometheus تُراقَب في vLLM؟
ينشر الخادم مقاييسه بصيغة Prometheus على المسار /metrics، وتبدأ أسماؤها بالبادئة vllm:. وقد تطورت الأسماء الدقيقة مع الانتقال إلى المحرك «V1»: تحقق منها باستعلام نسختك أنت (curl localhost:8000/metrics) ومن صفحة «Metrics» في الوثائق. العائلات التي تُتابَع:
- الحمل: الطلبات قيد التنفيذ والمنتظرة (
vllm:num_requests_runningوvllm:num_requests_waiting). تضخم طابور الانتظار أول علامة على التشبّع. - الذاكرة: نسبة إشغال KV cache. عند الاقتراب من 100% يستبق vLLM بعض الطلبات (preemption) ويقفز زمن الاستجابة.
- زمن الاستجابة: مدرّجات تكرارية (histograms) للزمن حتى أول رمز (TTFT) والزمن بين الرموز والزمن من طرف إلى طرف.
- الحجم: عدّادات رموز المطالبة (prompt) والرموز المولَّدة، وهي أساس معدل المعالجة وحساب التكلفة.
- مآل الطلبات: عدد الطلبات المنتهية بحسب سبب الانتهاء (الطول الأقصى أو التوقف الطبيعي أو الإيقاف).
تُقرأ هذه المقاييس التطبيقية مع مقاييس GPU: الاستخدام والذاكرة والطاقة والحرارة، التي يوفرها مصدّر DCGM من NVIDIA (ينشره GPU Operator على Kubernetes) أو وكيل المضيف.
السجلات وتتبعات OpenTelemetry
يسجّل vLLM على الخرج القياسي تحميل النموذج والذاكرة المخصصة لـ KV cache، ودوريًا ملخصًا لمعدل المعالجة وإشغال الذاكرة المؤقتة. وعلى Kubernetes تُجمع هذه السجلات كسجلات أي pod.
أما في التتبعات، فيقبل الخادم الخيار --otlp-traces-endpoint الذي يرسل span لكل طلب إلى مجمّع OTLP، بسمات مستوحاة من الاصطلاحات الدلالية لـ GenAI (النموذج والرموز وزمن الانتظار في الطابور وTTFT). ويجب تثبيت حزم OpenTelemetry اللازمة على حدة؛ وتقدم الوثائق مثالًا كاملًا. وإذا نشر التطبيق المستدعي سياق W3C فإن span الخاصة بـ vLLM ترتبط بالتتبع الممتد من طرف إلى طرف.
إيصال vLLM إلى Dynatrace
أبسط طريق يمر عبر OpenTelemetry Collector يجمع /metrics ويستقبل تتبعات OTLP ويصدّر كل شيء. تتوقع Dynatrace مقاييس OTLP بزمنية delta: يحوّل المعالج cumulativetodelta عدّادات Prometheus التراكمية.
receivers:
  prometheus:
    config:
      scrape_configs:
        - job_name: vllm
          scrape_interval: 15s
          static_configs:
            - targets: ["vllm:8000"]
  otlp:
    protocols:
      grpc:
      http:
processors:
  cumulativetodelta:
  batch:
exporters:
  otlphttp:
    endpoint: https://<environnement>.live.dynatrace.com/api/v2/otlp
    headers:
      Authorization: "Api-Token ${env:DT_API_TOKEN}"
service:
  pipelines:
    metrics:
      receivers: [prometheus]
      processors: [cumulativetodelta, batch]
      exporters: [otlphttp]
    traces:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlphttp]
يجب أن يحمل الرمز المميّز صلاحيات استيعاب المقاييس والتتبعات. وعلى Kubernetes تستطيع Dynatrace أيضًا جمع نقاط Prometheus الموسومة مباشرة؛ راجع وثائقها للاختيار بين النهجين. وحين تصل البيانات إلى Grail تكفي بضعة جداول: TTFT عند p95 والطلبات المنتظرة وإشغال KV cache والرموز في الثانية واستخدام GPU لكل عقدة. وتنطبق مباشرة على TTFT مبادئ أهداف مستوى الخدمة (SLO) القائمة على المدرّجات التكرارية، المفصّلة في مقالنا عن مقاييس المدرّجات التكرارية مع OpenPipeline.
أفضل الممارسات
- ثبّت إصدار vLLM ومعرّف النموذج؛ واختبر كل ترقية، فالخيارات والمقاييس تتغير.
- احمِ الواجهة بمفتاح وترشيح للشبكة؛ ولا تعرضها مباشرة على الإنترنت.
- نبّه على طابور الانتظار وإشغال KV cache قبل زمن الاستجابة: فهما مؤشران استباقيان.
- حدّد
--max-model-lenبحسب الاستخدام الفعلي لا بالطاقة القصوى للنموذج. - أبقِ المطالبات (prompts) خارج التتبعات إن كانت تحتوي بيانات حساسة.
الأسئلة الشائعة
هل vLLM متوافق فعلًا مع واجهة OpenAI؟
للنقاط الرئيسية (المحادثة والإكمال والنماذج والتضمينات بحسب النموذج) نعم: يكفي تغيير عنوان URL الأساسي في SDK. وقد تختلف بعض المعاملات المتقدمة؛ وتسرد الوثائق المدعوم منها.
أين أجد مقاييس Prometheus الخاصة بـ vLLM؟
على المسار /metrics للخادم، وعلى المنفذ نفسه الذي تعمل عليه الواجهة. وتبدأ الأسماء بـ vllm:.
هل يعمل vLLM بدون GPU؟
يوجد وضع CPU لبعض المنصات، لكن vLLM مصمَّم للمسرّعات. وبدون GPU يكون llama.cpp أو Ollama أنسب.
الخلاصة
يوفر vLLM معدل المعالجة اللازم لتقديم نماذج لغوية مفتوحة على نطاق واسع، ومن حسناته أنه قابل للملاحظة منذ التثبيت. وبربط مقاييس Prometheus وتتبعات OTLP ومقاييس GPU في واجهة خلفية واحدة، تُدار عملية الاستدلال كأي خدمة حرجة. وللاختيار بين vLLM واللبنات الأخرى راجع مقارنتنا لحزم الذكاء الاصطناعي المفتوحة المصدر المستضافة ذاتيًا.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC ولا للمشاريع المذكورة. العلامات التجارية المذكورة ملك لأصحابها. الأدوات تتطور بسرعة، لذا تحقق دائمًا من الأوامر والخيارات في وثائقها الرسمية.