Poner vLLM en producción es pasar de un LLM que «funciona en mi máquina» a un servicio de inferencia capaz de absorber cientos de peticiones simultáneas en GPU de centro de datos. Nacido en un laboratorio de la Universidad de Berkeley y hoy alojado por la PyTorch Foundation, vLLM es uno de los proyectos de código abierto más seguidos en GitHub para servir modelos de lenguaje. Esta guía cubre los tres pilares de un vLLM en producción fiable: el servidor compatible con OpenAI, las métricas de Prometheus y la monitorización de las GPU.
Su fuerza se basa en dos ideas: PagedAttention, que gestiona la memoria de la caché clave-valor (KV cache) por páginas, como un sistema operativo gestiona la memoria virtual, y el batching continuo, que inserta las peticiones nuevas en el lote en curso en lugar de esperar a que termine. Resultado: una ocupación mucho mejor de las GPU, que son caras.
Para un SRE, vLLM tiene otra cualidad: expone de forma nativa un endpoint de Prometheus muy completo y puede emitir trazas de OpenTelemetry. Veamos cómo instalarlo, lanzarlo como servidor compatible con OpenAI y monitorizarlo hasta Dynatrace.
vLLM en producción: ¿por qué elegirlo?
vLLM responde a una necesidad precisa: servir modelos abiertos (Llama, Mistral, Qwen, Gemma…) desde Hugging Face con un alto rendimiento. Ofrece:
- un servidor HTTP compatible con la API de OpenAI (
/v1/chat/completions,/v1/completions,/v1/models…), utilizable por tanto con los SDK existentes; - paralelismo de tensores y de pipeline para repartir un modelo grande entre varias GPU;
- soporte de numerosos formatos cuantizados y de varias familias de hardware (NVIDIA en primer lugar, pero también AMD y otros aceleradores según las versiones).
Sus límites: exige una GPU seria, su tiempo de arranque es largo (carga de los pesos, compilación, preasignación de memoria) y sus numerosos ajustes requieren algo de experiencia. Para el puesto de un desarrollador, Ollama en local o llama.cpp son más ligeros.
En la práctica: desplegar un servidor vLLM compatible con OpenAI
Paso 1: instalar vLLM
En una máquina Linux con una GPU de NVIDIA y controladores CUDA recientes, la instalación se hace con pip, preferiblemente en un entorno virtual:
python3 -m venv .venv && source .venv/bin/activate
pip install vllm
Las combinaciones de versiones de Python, CUDA y PyTorch admitidas cambian a menudo: compruébalas en la guía de instalación oficial de vLLM.
Paso 2: lanzar el servidor
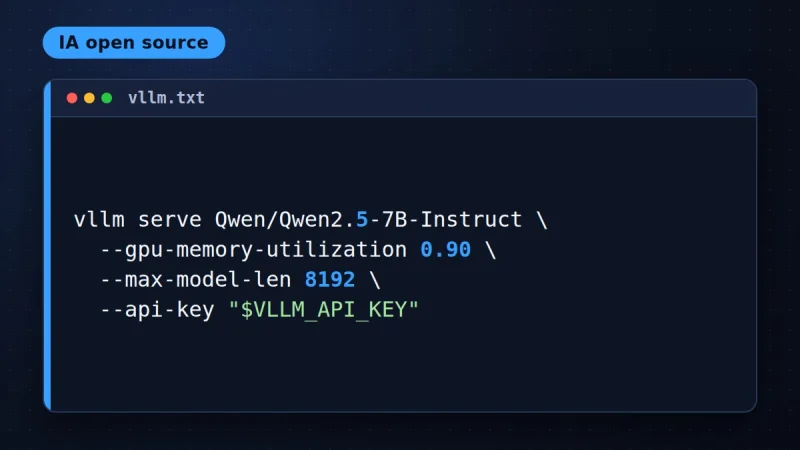
El comando vllm serve arranca el servidor compatible con OpenAI, por defecto en el puerto 8000. Para un modelo sujeto a condiciones de acceso en Hugging Face, exporta antes un token en HF_TOKEN:
vllm serve Qwen/Qwen2.5-7B-Instruct \
  --gpu-memory-utilization 0.90 \
  --max-model-len 8192 \
  --api-key "$VLLM_API_KEY"
--gpu-memory-utilization fija la fracción de memoria de GPU que vLLM se permite usar, --max-model-len limita la longitud de contexto (y por tanto el tamaño de la KV cache) y --tensor-parallel-size reparte el modelo entre varias GPU. La lista completa de opciones se obtiene con vllm serve --help.
Paso 3: o usar la imagen de Docker
docker run --gpus all --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e HF_TOKEN="$HF_TOKEN" \
  vllm/vllm-openai:latest \
  --model Qwen/Qwen2.5-7B-Instruct
En producción, sustituye latest por una versión concreta. En Kubernetes, la documentación propone ejemplos de despliegue y charts de la comunidad; prevé una sonda de arranque generosa, porque la carga de un modelo grande tarda varios minutos.
Paso 4: probar la API
curl -s http://localhost:8000/v1/chat/completions \
  -H "Authorization: Bearer $VLLM_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "Qwen/Qwen2.5-7B-Instruct",
       "messages": [{"role": "user", "content": "Bonjour"}]}'
curl -s http://localhost:8000/health
¿Qué métricas de Prometheus vigilar en vLLM?
El servidor publica sus métricas en formato Prometheus en /metrics, con el prefijo vllm:. Los nombres exactos han evolucionado con el paso al motor «V1»: contrástalos consultando tu propia instancia (curl localhost:8000/metrics) y la página «Metrics» de la documentación. Las familias a seguir:
- Carga: peticiones en ejecución y en espera (
vllm:num_requests_running,vllm:num_requests_waiting). Una cola de espera que crece es la primera señal de saturación. - Memoria: tasa de ocupación de la KV cache. Cerca del 100 %, vLLM expulsa peticiones y la latencia se dispara.
- Latencia: histogramas del tiempo hasta el primer token (TTFT), del tiempo entre tokens y de la latencia de extremo a extremo.
- Volumen: contadores de tokens de prompt y de tokens generados, base del rendimiento y del cálculo de coste.
- Resultado de las peticiones: número de peticiones terminadas por motivo de finalización (longitud máxima, parada normal, interrupción).
Estas métricas de aplicación se leen junto con las de la GPU: utilización, memoria, potencia y temperatura, que aporta el exportador DCGM de NVIDIA (desplegado por el GPU Operator en Kubernetes) o un agente de host.
Logs y trazas de OpenTelemetry
vLLM registra en la salida estándar la carga del modelo, la memoria asignada a la KV cache y, periódicamente, un resumen del rendimiento y de la ocupación de la caché. En Kubernetes, estos logs se recogen como los de cualquier pod.
En cuanto a las trazas, el servidor acepta una opción --otlp-traces-endpoint que envía un span por petición a un colector OTLP, con atributos inspirados en las convenciones semánticas GenAI (modelo, tokens, tiempo en cola, TTFT). Los paquetes de OpenTelemetry necesarios deben instalarse aparte; la documentación ofrece un ejemplo completo. Si la aplicación llamante propaga el contexto W3C, el span de vLLM se asocia a la traza de extremo a extremo.
Llevar vLLM a Dynatrace
El camino más sencillo pasa por un OpenTelemetry Collector que haga scrape de /metrics, reciba las trazas OTLP y exporte todo. Dynatrace espera métricas OTLP con temporalidad delta: el procesador cumulativetodelta convierte los contadores acumulativos de Prometheus.
receivers:
  prometheus:
    config:
      scrape_configs:
        - job_name: vllm
          scrape_interval: 15s
          static_configs:
            - targets: ["vllm:8000"]
  otlp:
    protocols:
      grpc:
      http:
processors:
  cumulativetodelta:
  batch:
exporters:
  otlphttp:
    endpoint: https://<environnement>.live.dynatrace.com/api/v2/otlp
    headers:
      Authorization: "Api-Token ${env:DT_API_TOKEN}"
service:
  pipelines:
    metrics:
      receivers: [prometheus]
      processors: [cumulativetodelta, batch]
      exporters: [otlphttp]
    traces:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlphttp]
El token debe tener los permisos de ingesta de métricas y de trazas. En Kubernetes, Dynatrace también sabe hacer scrape directamente de endpoints de Prometheus anotados; consulta su documentación para elegir entre ambos enfoques. Una vez los datos en Grail, bastan unos pocos paneles: TTFT p95, peticiones en espera, ocupación de la KV cache, tokens por segundo y utilización de GPU por nodo. Los principios de SLO basados en histogramas, detallados en nuestro artículo sobre las métricas de histograma con OpenPipeline, se aplican directamente al TTFT.
Buenas prácticas
- Fija la versión de vLLM y el identificador del modelo; prueba cada subida de versión, porque las opciones y las métricas cambian.
- Protege la API con una clave y un filtrado de red; no la expongas directamente a Internet.
- Alerta sobre la cola de espera y la ocupación de la KV cache antes que sobre la latencia: son indicadores adelantados.
- Dimensiona
--max-model-lensegún el uso real y no según la capacidad máxima del modelo. - Mantén los prompts fuera de las trazas si contienen datos sensibles.
Preguntas frecuentes
¿Es vLLM realmente compatible con la API de OpenAI?
Para los endpoints principales (chat, completions, modelos, embeddings según el modelo), sí: basta con cambiar la URL base del SDK. Algunos parámetros avanzados pueden diferir; la documentación lista los que se admiten.
¿Dónde encontrar las métricas de Prometheus de vLLM?
En la ruta /metrics del servidor, en el mismo puerto que la API. Los nombres empiezan por vllm:.
¿Funciona vLLM sin GPU?
Existe un modo CPU para algunas plataformas, pero vLLM está diseñado para aceleradores. Sin GPU, llama.cpp u Ollama son más adecuados.
Conclusión
vLLM aporta el rendimiento necesario para servir LLM abiertos a gran escala, y tiene la buena idea de ser observable desde la instalación. Al unir sus métricas de Prometheus, sus trazas OTLP y las métricas de GPU en un mismo backend, se gobierna la inferencia como cualquier servicio crítico. Para elegir entre vLLM y las demás piezas, consulta nuestra comparativa de pilas de IA de código abierto autoalojadas.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a los proyectos citados. Las marcas citadas pertenecen a sus propietarios. Las herramientas evolucionan rápido: comprueba los comandos y opciones en su documentación oficial.